
OpenAI berjanji: chip Jalapeño mereka akan lebih cepat dan lebih hemat dibandingkan solusi pesaing
Perusahaan mengklaim bahwa prosesor untuk inferensi yang dikembangkan bersama Broadcom mengungguli akselerator Nvidia dalam hal efisiensi energi dan kecepatan respons pada pengujian beberapa model AI. Mereka berencana menerapkan chip tersebut dalam volume kecil sebelum akhir tahun, tetapi tidak berniat sepenuhnya mengganti armada Nvidia.
OpenAI bertaruh pada chip Jalapeño: lebih cepat, lebih hemat, dan hampir siap dijual
Ketika berbicara tentang penerapan model bahasa besar, para insinyur terus-menerus harus mencari kompromi: entah sistem merespons dengan sangat cepat, tetapi kesulitan menahan aliran permintaan, atau sistem mampu menangani beban besar, tetapi dengan mengorbankan latensi yang nyata. Di OpenAI, mereka yakin telah menemukan solusi yang menghilangkan kontradiksi ini. Chip milik perusahaan itu sendiri, yang diberi nama Jalapeño, menurut klaim para pengembang, menunjukkan latensi rendah dan throughput tinggi secara bersamaan. Menurut Wakil Presiden OpenAI untuk perangkat keras, Richard Ho, produk baru ini menawarkan "yang terbaik dari kedua dunia".
Jalapeño bukanlah prosesor serbaguna, melainkan sirkuit terpadu khusus (ASIC) yang dibuat dalam kemitraan dengan Broadcom. Chip ini dirancang untuk tugas spesifik — inferensi, yaitu menjalankan langsung model yang telah dilatih untuk menyelesaikan tugas dan mengoperasikan agen. Diumumkan pada bulan Juni, kini chip ini untuk pertama kalinya mendapatkan hasil pengujian resmi, yang tidak segan-segan disebut revolusioner oleh perusahaan.
Apa yang ditunjukkan oleh pengujian kinerja
Untuk mengevaluasi kemampuan chip tersebut, OpenAI menggunakan platform tolok ukur miliknya sendiri, InferenceX. Sebagai standar pembanding, diambil hasil terbaik yang pernah tercatat pada superchip Nvidia GB200 dan GB300. Pengujian dilakukan pada tiga model populer: GPT-OSS 120B, DeepSeek R1, dan Kimi K2.5 1T.
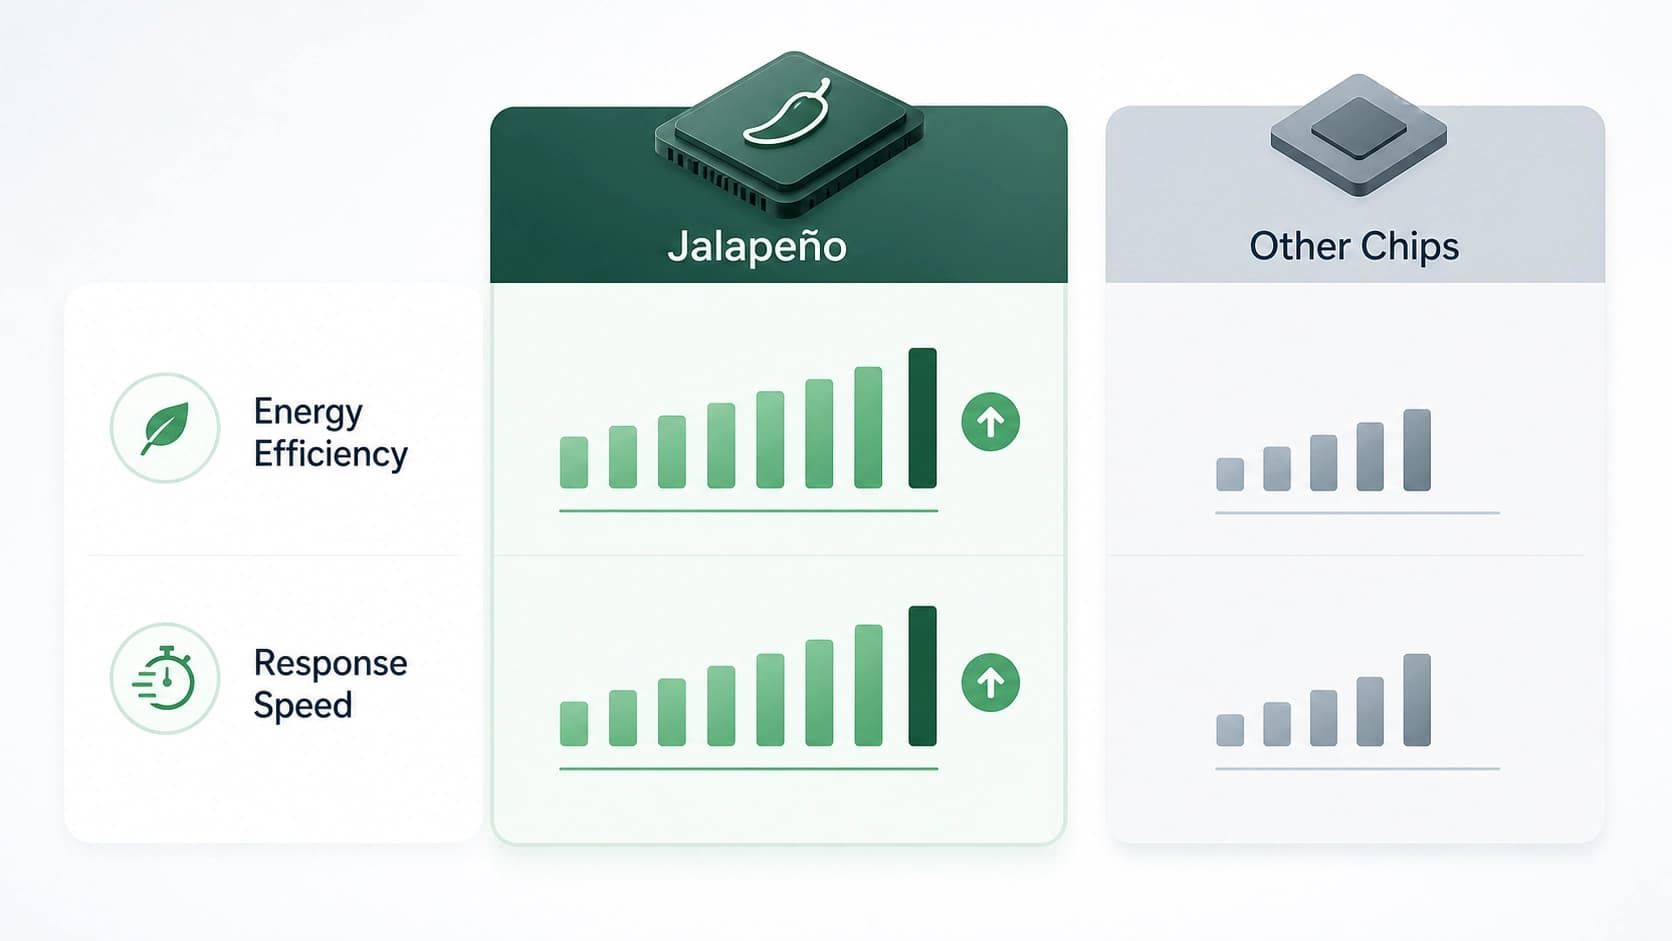
Perusahaan mengklaim bahwa hasilnya sangat mengesankan. Tergantung pada modelnya, Jalapeño menunjukkan komputasi 1,5–1,9 kali lebih banyak per watt dibandingkan sistem pesaing. Sederhananya, ini berarti untuk setiap kilowatt energi yang digunakan, chip baru ini melakukan lebih banyak pekerjaan yang bermanfaat secara signifikan. Ini sangat penting di era ketika tagihan listrik untuk pusat data menjadi salah satu pos pengeluaran utama.
Perbedaan kecepatan respons bahkan lebih terlihat. Latensi menyeluruh pada ketiga model yang diuji ternyata 1,7–3,6 kali lebih rendah dibandingkan sistem referensi dengan chip Nvidia. Dalam praktiknya, ini berarti respons asisten yang lebih cepat, tindakan agen AI yang lebih responsif, dan akses layanan yang stabil bahkan saat beban puncak. Semakin cepat model memproses permintaan, semakin sedikit waktu yang dihabiskan pengguna untuk menatap indikator "pengetikan" respons.
Strategi: bukan pengganti, melainkan pelengkap
Meskipun ada indikator yang begitu menjanjikan, OpenAI tidak berniat menghentikan kerja sama dengan Nvidia. Richard Ho menekankan bahwa strategi komputasi perusahaan secara keseluruhan melibatkan penggunaan berbagai mitra, dan Nvidia tetap menjadi salah satu mitra kunci. Jalapeño tidak akan menggantikan armada chip yang ada, melainkan akan menjadi elemen penting dalam penskalaan infrastruktur.
Generasi pertama chip ini direncanakan akan diterapkan dalam "volume kecil" sebelum akhir tahun ini. Peningkatan kapasitas skala penuh akan dimulai pada tahun 2027. Perusahaan sengaja tidak mengungkapkan jumlah pasti chip yang berencana digunakan tahun depan. Sementara itu, pekerjaan pada generasi kedua dan ketiga Jalapeño sudah berlangsung, yang menunjukkan arah jangka panjang dari inisiatif ini — tidak seperti banyak eksperimen yang tidak pernah mencapai tahap praktis.
Kesuksesan proyek ini dapat secara signifikan mengurangi ketergantungan operator model AI besar pada sejumlah kecil pemasok chip. ASIC milik sendiri memungkinkan penyesuaian arsitektur yang lebih presisi dengan algoritme dan beban kerja spesifik OpenAI, menghemat sumber daya dan mempercepat peluncuran produk baru ke pasar.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan
Invarian polinomial kanonik dalam diagnostik kegagalan simulator RL: di mana sebenarnya berguna?
Studi ini menguji apakah menyertakan hukum fisika dalam model dinamika yang dapat dilatih memang sepadan: invarian yang diekstrak dari lintasan dan diubah ke bentuk kanonis melalui basis Gröbner hanya sedikit meningkatkan prediksi, tetapi sangat berguna untuk diagnosis—invarian ini dapat membantu menemukan kendala yang dilanggar dan mengidentifikasi parameter spesifik yang keliru.
10 November 2026
AURA-Eval: cara memeriksa apakah agen LLM mengenali risiko dan mengubah langkah berikutnya
Framework ini mengevaluasi perilaku agen LLM bukan berdasarkan keputusan akhir, melainkan respons terhadap risiko di titik-titik penting: rangkaian pemanggilan alat dihentikan, lalu model harus melanjutkan penalaran dan tindakan, sementara panel juri LLM menilai deteksi risiko, karakter, dan keamanan langkah tersebut. Dalam 1.249 tugas yang dikumpulkan dari 157 rangkaian R-Judge, 20 model lebih sering melakukan tindakan tidak aman saat jalur aman tidak tersedia, dan penghapusan pengawasan sebelum eksekusi mengubah 52,3% kasus yang semula aman menjadi tidak aman.
10 November 2026
Memori reservoir Chern–Simons: dinamika konektivitas mandiri dan transfer densitas
Artikel ini membahas bagaimana reservoir menyimpan riwayat sinyal masukan secara bersamaan dalam distribusi densitas dan derajat kebebasan geometris. Perbandingan empat mekanisme menunjukkan bahwa arus menciptakan komponen keterhubungan tersendiri yang mengubah respons densitas berikutnya, sementara penggunaan semua fitur yang terukur memberikan sedikit peningkatan dalam dekode urutan pulsa.
10 November 2026