
Jawaban akhir sebagai satu-satunya metrik — dan apa yang disembunyikannya
Sebagian besar benchmark untuk model bahasa disusun seperti ulangan sekolah: ada pertanyaan, ada kunci jawaban, ada pemeriksaan kecocokan. Menghitung metrik semacam ini memang praktis, begitu pula membandingkan model. Namun skema ini punya cacat bawaan: ia menilai hasil, bukan jalan menuju hasil itu.
Bayangkan sebuah tugas yang mengharuskan menghubungkan empat fakta. Model keliru pada fakta kedua, kebetulan menebak benar pada fakta keempat — dan mendapat nilai. Atau sebaliknya: tiga mata rantai tersusun sempurna, tetapi jawaban terakhir berbeda satu frasa — dan tidak ada nilai. Dalam kedua kasus, angka akhirnya berbohong tentang apa yang sebenarnya terjadi di dalam. Ini terutama menyakitkan untuk pertanyaan multi-langkah: di sana yang diuji bukan satu keterampilan, melainkan urutannya — menemukan informasi, menahannya, menghubungkannya dengan informasi berikutnya, dan tidak kehilangannya di tengah jalan.
Diagnosis "di mana tepatnya yang rusak" bukanlah kejanggalan akademis. Dari situ bergantung apa yang harus diperbaiki: korpus data, strategi pelatihan, atau rumusan prompt. Akurasi akhir tidak bisa menjawab pertanyaan semacam itu secara inheren.
Apa itu Omanic
Justru titik buta inilah yang ditutup oleh karya "Omanic: Towards Step-wise Evaluation of Multi-hop Reasoning in Large Language Models" (arXiv:2603.16654, masuk ke bagian cs.CL, juga diklasifikasikan ke cs.AI dan cs.LG, diterima di EMNLP 2026 Findings). Tim penulisnya luas dan internasional: Xiaojie Gu, Sherry T. Tong, Aosong Feng, Sophia Simeng Han, Jinghui Lu, Yingjian Chen, Yusuke Iwasawa, Yutaka Matsuo, Chanjun Park, Rex Ying, Irene Li. Edisi pertama diunggah pada 17 Maret 2026, lalu disusul dua revisi — pada Mei dan Agustus.
Omanic adalah benchmark open-domain dengan empat langkah penalaran. Kata "open-domain" di sini kunci: model tidak memilih opsi dari daftar yang tersedia dan tidak menggali satu dokumen yang sudah disiapkan sebelumnya. Informasinya harus ditemukan sendiri, dan baru setelah itu dirangkai menjadi rantai. Pendekatan seperti ini lebih dekat dengan skenario nyata, di mana jawaban hampir tidak pernah terletak dalam satu paragraf.
Dua korpus, bukan satu
Di dalam Omanic terdapat dua kumpulan data yang berbeda, dan keduanya tidak boleh dicampuradukkan.
Pertama — OmanicSynth, 10.296 contoh yang dihasilkan mesin. Ini materi pelatihan: dapat digunakan sebagai supervisi, dan justru padanya para penulis menguji apakah kemampuan bernalar langkah demi langkah dapat ditransfer.
Kedua — OmanicBench, 967 contoh yang telah melalui pemeriksaan ahli dan dilengkapi anotasi manual. Ini bagian evaluasi, dan jumlahnya jauh lebih kecil — yang masuk akal, karena anotasi manusia pada tingkat langkah memang mahal.
Pemisahan semacam ini bukan formalitas. Ia memungkinkan kita memisahkan "model telah dilatih" dari "model benar-benar mampu": korpus pelatihan besar dan dihasilkan mesin, sedangkan korpus pengujian ringkas dan terverifikasi.
Bagaimana anotasi langkah demi langkah disusun
Perbedaan utama Omanic dari kumpulan QA yang biasa terletak pada penguraian setiap pertanyaan menjadi komponen-komponennya. Subpertanyaan satu langkah, jawaban antara, topologi graf terstruktur — yakni skema tentang bagaimana fakta-fakta saling terhubung.
Ini mengubah penilaian dari satu titik menjadi sekumpulan titik kontrol. Kini kita bisa melihat bukan hanya "model menjawab benar atau tidak", tetapi juga "pada transisi mana tepatnya ia tersandung". Struktur graf di sini juga penting karena berbagai jenis keterkaitan diberikan kepada model dengan tingkat kemudahan yang berbeda: satu hal menarik properti suatu objek, hal yang sama sekali lain menelusuri rantai empat ketergantungan berurutan.
Tiga diagnosis yang hanya terlihat pada langkah-langkah
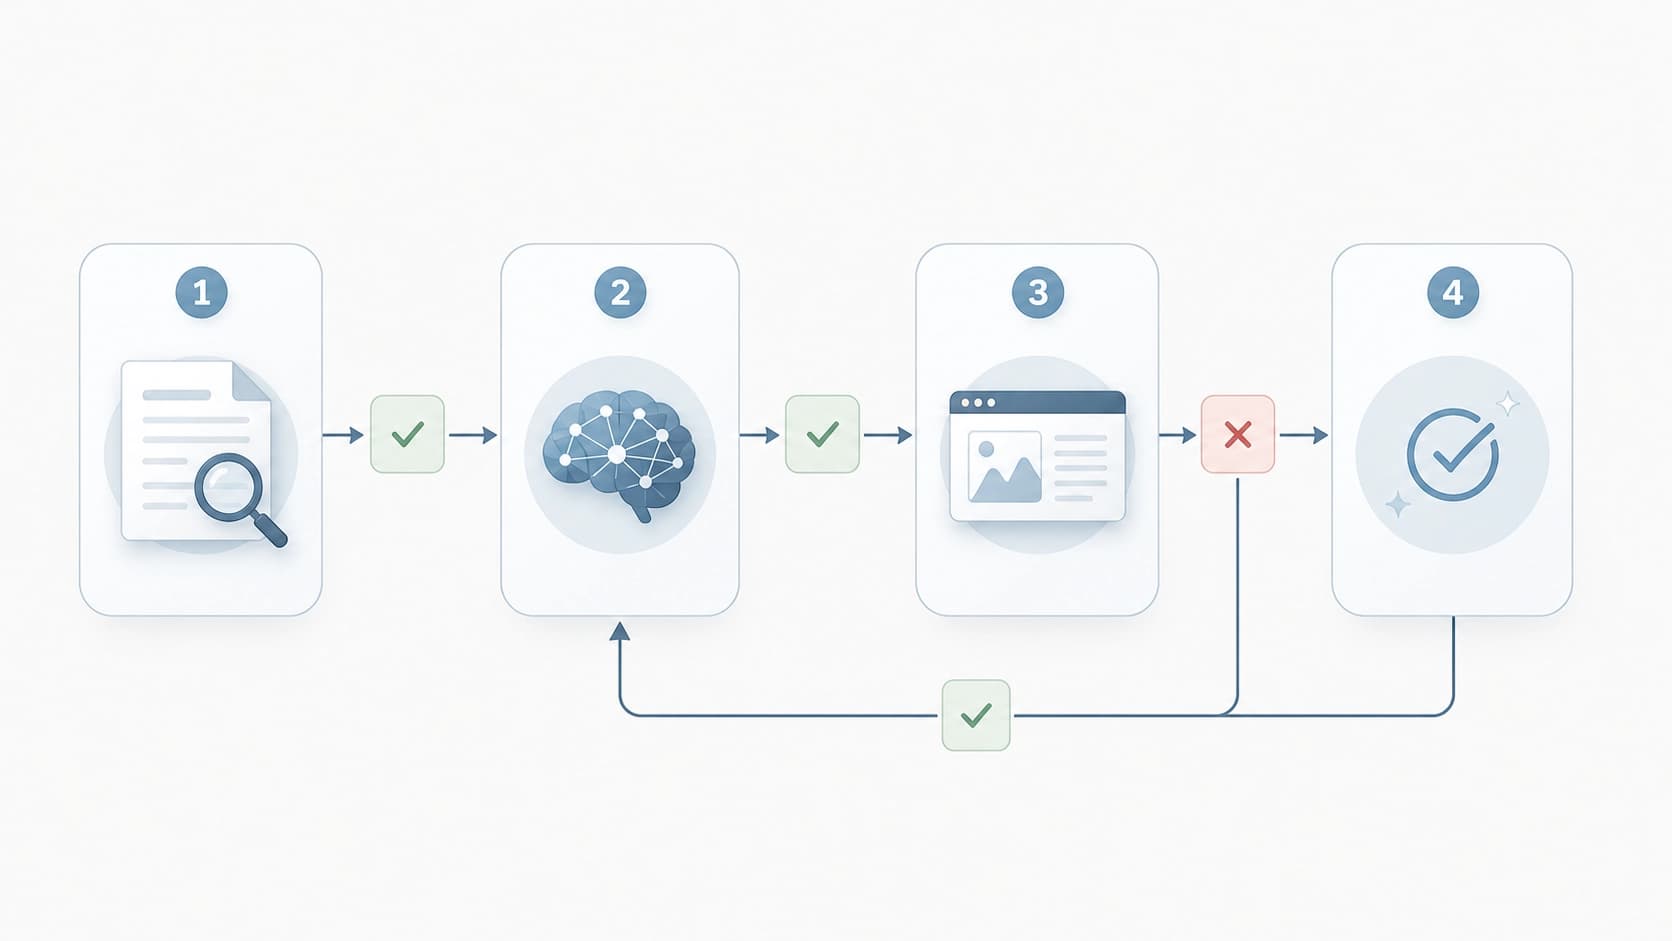
Eksperimen dengan model tertutup dan terbuka menghasilkan tiga pengamatan yang tidak mampu ditunjukkan oleh metrik akhir.
Hambatan pada langkah-langkah akhir
Temuan pertama disebut para penulis sebagai later-hop bottleneck. Intinya, kehilangan utama menumpuk bukan di awal, melainkan mendekati akhir rantai. Transisi pertama dan kedua dilalui model dengan relatif percaya diri, tetapi pada langkah ketiga dan keempat mereka mulai berjatuhan.
Penjelasannya muncul dengan sendirinya: semakin panjang rantai, semakin banyak entitas antara yang harus dijaga sekaligus dalam kondisi kerja. Pada langkah-langkah akhir, model harus beroperasi bukan lagi dengan pertanyaan awal, melainkan dengan hasil kesimpulannya sendiri sebelumnya — dan setiap ketidaktepatan di sana berlipat ganda. Kesimpulan praktisnya tidak menyenangkan bagi mereka yang gemar membangun pipeline panjang bertingkat: menambahkan langkah kelima dan keenam bisa jadi lebih mahal daripada yang terlihat.
"Lantai" pengetahuan faktual
Fenomena kedua — factual knowledge floor, "lantai" pengetahuan faktual. Sebagian kesalahan sama sekali tidak terkait dengan logika: model sekadar tidak memiliki fakta yang diperlukan, dan alih-alih berhenti dengan jujur, ia terus membangun penalaran di atas dasar yang kosong.
Ini pembedaan yang penting. Ketika model keliru dalam menyimpulkan — persoalannya pada penalaran. Ketika ia tidak mengetahui fakta awalnya — persoalannya pada data dan pada apakah ia mampu mengakui ketidaktahuannya. Yang kedua sulit diobati: baik penalaran langkah demi langkah maupun prompt yang lebih cerdas tidak akan menolong jika penopang di bawah mata rantai pertama memang tidak ada.
Kesalahan yang menjalar sepanjang rantai
Diagnosis ketiga — penyebaran kesalahan sepanjang rantai. Ketidaktepatan awal tidak tetap lokal: ia dipungut oleh langkah-langkah berikutnya dan berubah menjadi jawaban akhir yang meyakinkan, tersusun mulus, tetapi salah.
Di sini tersembunyi jebakan bagi penilaian. Model yang keliru sekali lalu bernalar secara konsisten setelahnya, dan model yang berjatuhan pada semua langkah, dalam metrik akhir tampak sama — keduanya tidak menebak benar. Penguraian langkah demi langkah membedakan keduanya, dan inilah justru kasus ketika diagnosis lebih berharga daripada skor akhir.
Transfer pembelajaran: 7,41 poin pada enam benchmark
Pertanyaan tersendiri — apakah anotasi ini dapat digunakan bukan hanya untuk pengukuran, tetapi juga untuk pelatihan. Para penulis mengujinya: fine-tuning pada OmanicSynth menghasilkan peningkatan pada enam benchmark pihak ketiga yang dikhususkan untuk penalaran dan matematika, dengan kenaikan rata-rata 7,41 poin.
Angka ini perlu dibaca dengan benar. Ini bukan "model menjadi lebih pintar dalam segala hal" — melainkan "keterampilan yang dilatih pada rantai yang terurai dapat ditransfer ke tugas lain dengan tipe serupa". Yang dengan sendirinya menunjukkan sifat benchmark ini: ia bukan tentang menghafal pertanyaan tertentu, melainkan tentang melatih prosedur — bagaimana memecah tugas menjadi langkah-langkah dan menjaga keterkaitan di antara langkah-langkah itu.
Apa artinya ini untuk praktik
Beberapa kesimpulan yang muncul dari uraian di atas.
Menilai per langkah, bukan berdasarkan hasil akhir. Jika sistem Anda menghasilkan jawaban multi-langkah, satu metrik akhir tidak cukup — ia akan merata-ratakan kegagalan yang berbeda sifatnya menjadi satu angka yang tidak jelas.
Bedakan "tidak tahu" dan "salah menyimpulkan". Ini dua cacat berbeda dengan cara pengobatan yang berbeda, tetapi dalam pelaporan biasa keduanya melebur.
Berhati-hatilah dengan rantai panjang. Langkah-langkah akhir adalah titik paling rentan. Terkadang lebih bijak memecah tugas menjadi beberapa subtugas independen daripada memaksakan satu rantai panjang sampai selesai.
Dekomposisi juga merupakan sinyal pelatihan. Hasil dengan transfer ke enam kumpulan pihak ketiga menunjukkan bahwa anotasi per langkah berfungsi bukan hanya sebagai penggaris, tetapi juga sebagai materi pelatihan.
Apa yang bukan Omanic
Berguna untuk menandai batasannya. Omanic bukan penilaian universal atas kecerdasan model dan bukan tes untuk segala hal sekaligus. Ini alat untuk tugas spesifik: menunjukkan pada mata rantai penalaran mana kegagalan terjadi dalam pertanyaan multi-langkah pada domain terbuka.
Ukuran bagian evaluasinya — 967 contoh — juga perlu diingat: kumpulannya terverifikasi, tetapi tidak raksasa. Bagian pelatihannya jauh lebih besar dan dibuat secara mesin, yang memberikan skala, tetapi tidak menggantikan pemeriksaan manual.
Dan yang terpenting: diagnosis itu sendiri tidak menyembuhkan apa pun. Mengetahui bahwa model tersandung pada langkah-langkah akhir hanyalah titik awal, bukan solusi. Setelah itu dimulailah pekerjaan biasa: di mana perlu menambah data, di mana perlu menyederhanakan rantai, di mana perlu melatih model untuk berhenti dan berkata "saya tidak tahu ini".
Data dan kode telah dirilis para penulis secara terbuka; karya ini tersedia melalui DOI 10.48550/arXiv.2603.16654.


