Mengapa SFT setelah RL mengancam kemampuan bernalar
Reinforcement learning mengembangkan kemampuan penalaran model bahasa besar. Pendekatan ini menjadi efektif untuk pascapelatihan LLM. Supervised fine-tuning berikutnya menyesuaikan model pasca-RL dengan bidang pengetahuan atau jenis perilaku baru. SFT semacam ini dapat secara serius menimpa kemampuan yang telah diperoleh.
Pendekatan yang ada untuk mengurangi lupa:
- pemutaran ulang pengalaman;
- inisialisasi khusus;
- optimisasi terbatas dengan proyeksi gradien.
Metode-metode tersebut hanya mempertahankan kemampuan secara terbatas atau memerlukan komputasi tambahan yang signifikan. Kriteria praktis: untuk model pasca-RL, pilih metode yang mengurangi risiko kemampuan bernalar tertimpa.
Ruang nol sebagai sumber daya untuk adaptasi
Para penulis menunjukkan bahwa aktivasi yang terkait dengan penalaran terkonsentrasi pada subruang berdimensi rendah. Kapasitas yang cukup besar masih tersedia di ruang nol untuk adaptasi. Ruang nol hampiran dapat diperkirakan secara andal dari sejumlah kecil contoh.
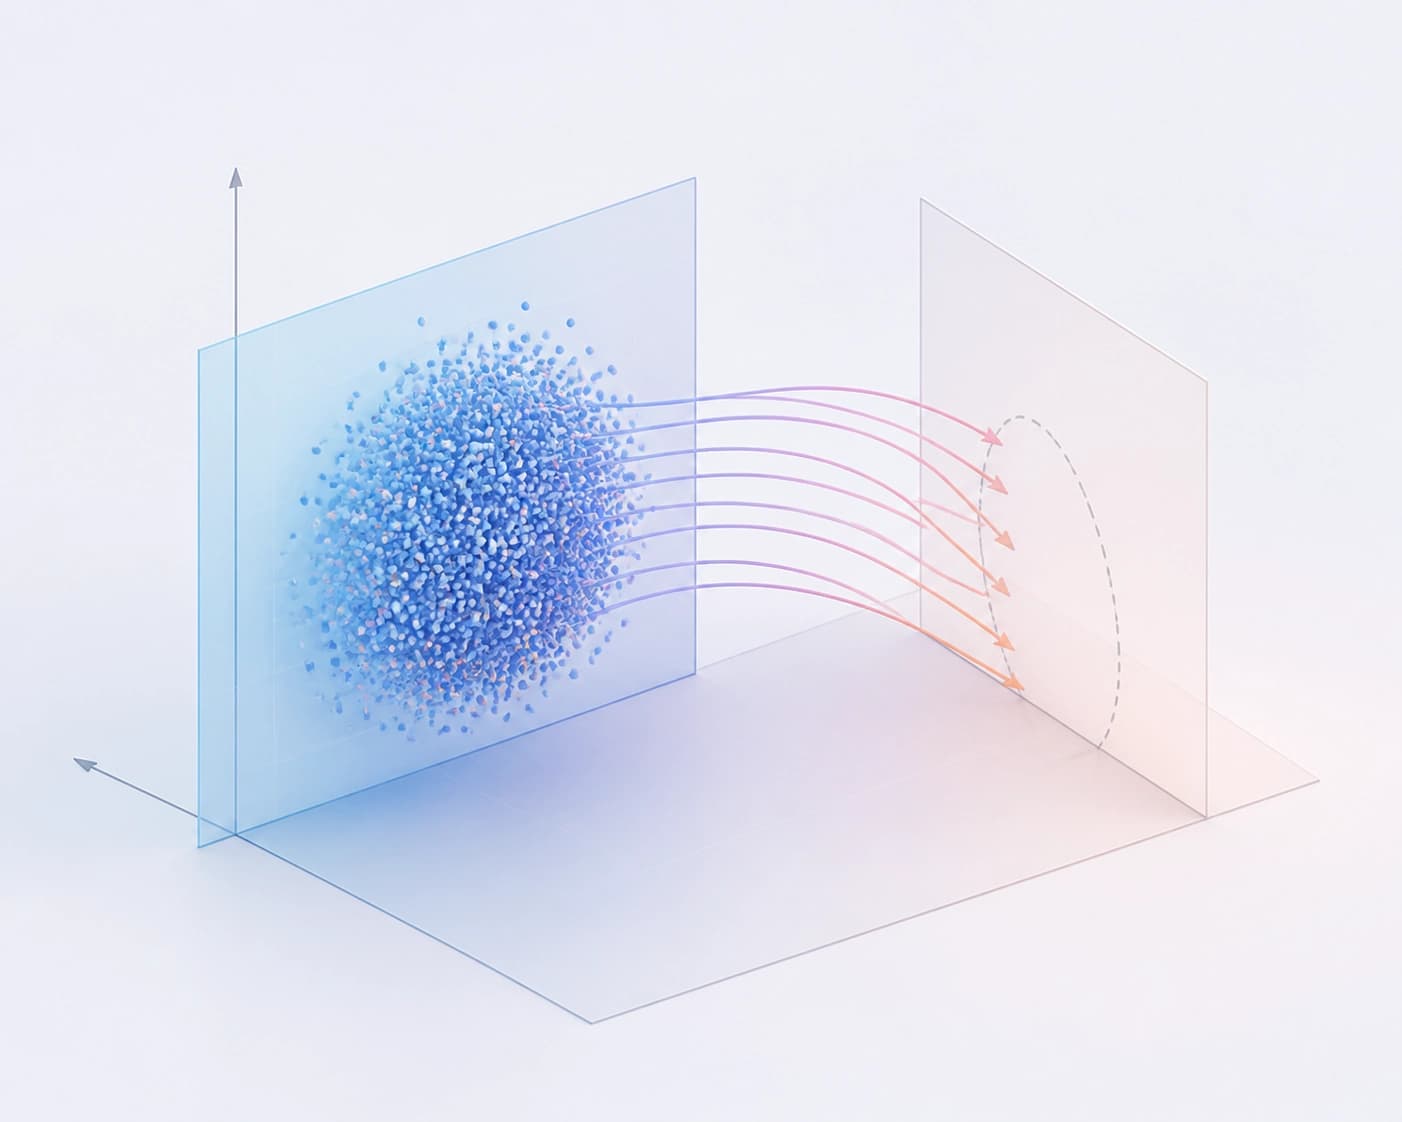
Kriteria praktis: metode yang membangun pembaruan di ruang nol memanfaatkan kapasitas yang tersedia. Metode ini tidak mengubah aktivasi penalaran.
Cara kerja NB-LoRA
Null-Basis Low-Rank Adaptation (NB-LoRA) adalah metode adaptasi hemat parameter untuk LLM pasca-RL. Metode ini diperkenalkan dalam makalah arXiv:2609.25618. Metode ini mempertahankan kemampuan penalaran yang telah diperoleh.
Tahapan kerja:
- Membangun basis nol hampiran tetap dari aktivasi penalaran.
- Memparametrisasi ulang pembaruan LoRA melalui basis ini.
- Merumuskan pelestarian kemampuan bernalar sebagai kendala untuk mempertahankan keadaan tersembunyi di tingkat lapisan.
- Mematuhi kendala tersebut selama proses fine-tuning.
Kriteria praktis: pilih NB-LoRA ketika perlu melakukan SFT sambil mempertahankan kemampuan bernalar model pasca-RL.
Perbandingan dengan pendekatan yang ada
Tabel ini membandingkan mekanisme dan karakteristik.
| Kriteria | Pendekatan yang ada | NB-LoRA |
|---|---|---|
| Mekanisme | Pemutaran ulang pengalaman, inisialisasi khusus, optimisasi terbatas dengan proyeksi gradien | Parametrisasi ulang LoRA melalui basis nol hampiran tetap |
| Karakteristik | Pelestarian kemampuan yang terbatas atau komputasi tambahan yang signifikan | Kendala untuk mempertahankan keadaan tersembunyi di tingkat lapisan |
Kriteria praktis: jika prioritasnya adalah mempertahankan kemampuan bernalar, NB-LoRA menyediakan kendala bawaan. Pendekatan yang ada mengharuskan pemilihan antara pelestarian terbatas dan komputasi tambahan.
Hasil eksperimen dan kriteria pemilihan
Eksperimen mencakup beberapa LLM yang dilatih dengan RL dan beragam tugas lanjutan. NB-LoRA menunjukkan kualitas adaptasi setara dengan LoRA standar. Metode ini mempertahankan akurasi penalaran mendekati tingkat sebelum fine-tuning. Pelestarian ini juga berlaku pada benchmark penalaran yang ditahan.
Kriteria praktis: untuk LLM pasca-RL yang kemampuan bernalarnya terancam oleh SFT, NB-LoRA layak dipertimbangkan untuk diuji pada tugas Anda sendiri.