
Neptuna: Perbandingan Arsitektur ML pada Aliran Multifase Kompresibel dengan Diskontinuitas
Diperkenalkan Neptuna — benchmark besar dengan 3 TB perhitungan untuk tugas kolaps gelembung dan fragmentasi tetesan akibat gelombang kejut, yang digunakan untuk menguji model konvolusional, spektral, transformer, dan PDE pralatih. Kesimpulannya: tidak ada model yang unggul secara universal, sementara fungsi loss gabungan dan SoftAdapt membantu mempertahankan batas antarfase dengan lebih baik serta mereproduksi spektrum secara lebih akurat.
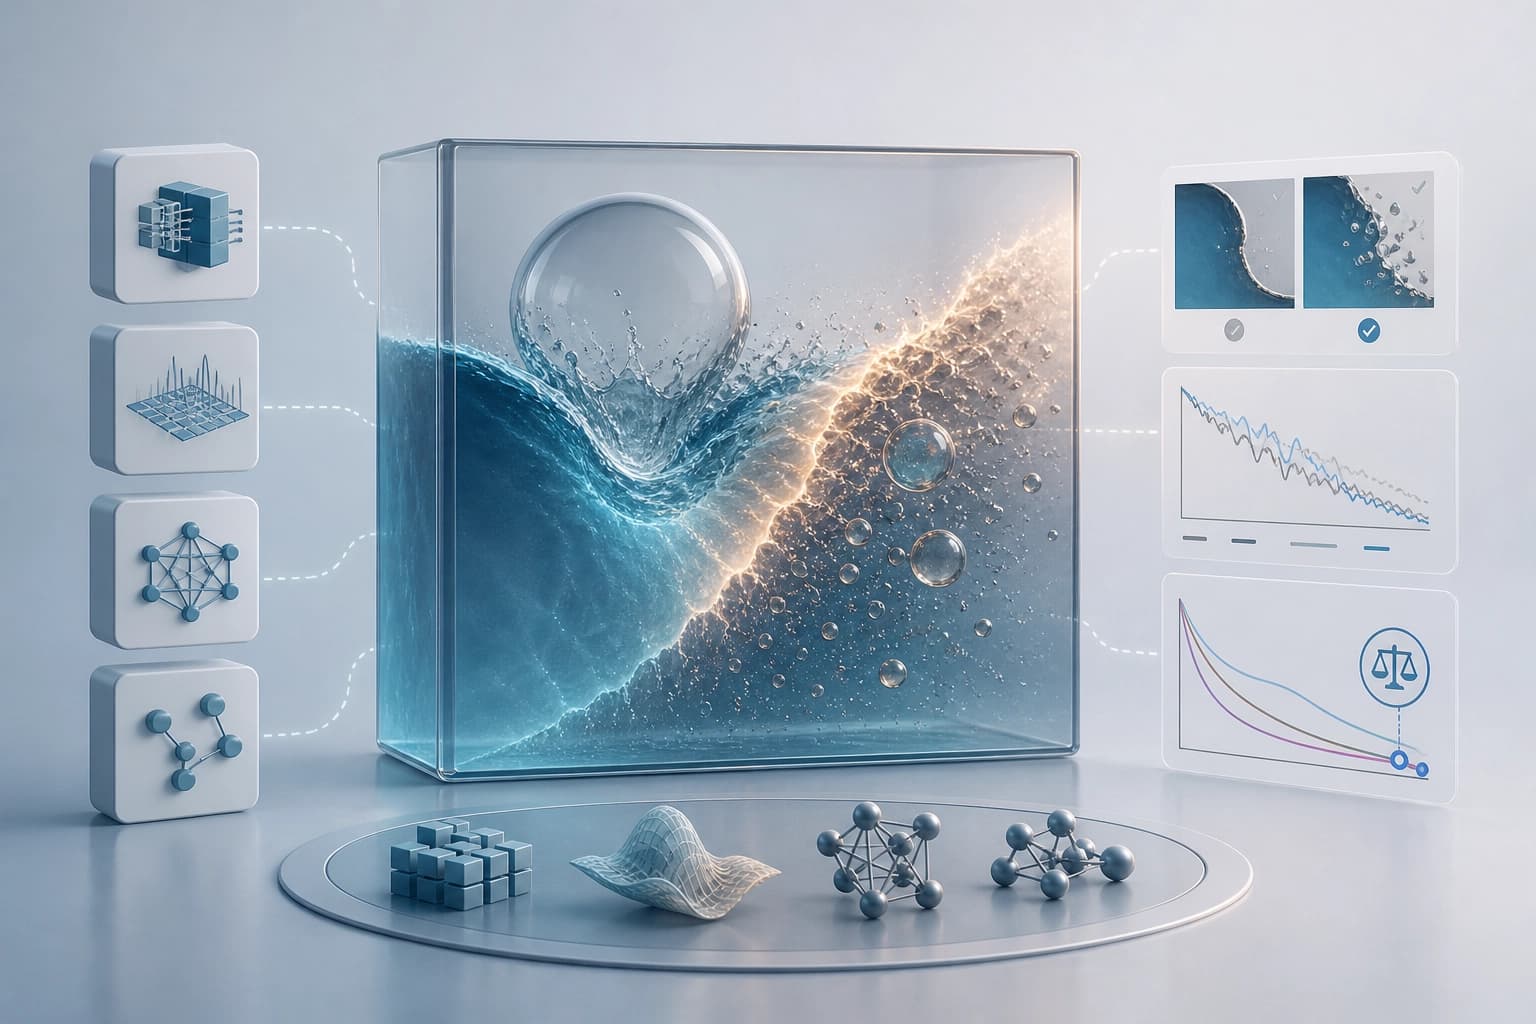
Tujuan benchmark
Neptuna adalah benchmark berskala besar pertama untuk aliran multifase kompresibel yang dieksitasi oleh gelombang kejut. Benchmark ini dibuat untuk membandingkan model ML menggunakan data yang memuat gelombang kejut dan antarmuka material. Benchmark ini menilai bukan hanya satu arsitektur, melainkan kombinasi arsitektur, fungsi loss, dan metrik.
| Komponen evaluasi | Opsi |
|---|---|
| Arsitektur | konvolusional, spektral, transformer, PDE foundation models |
| Fungsi loss | MSE, fungsi komposit, SoftAdapt, GradNorm |
| Metrik | per titik, spektral, berorientasi fitur, struktural, memperhitungkan fisika |
Kesimpulan: benchmark ini menyediakan platform terpadu untuk perbandingan yang dapat direproduksi. Kriteria praktis: gunakan benchmark ini untuk membandingkan model pada data dan metrik yang sama.
Data dan fisika
Benchmark ini mencakup 3 TB data 2D dan 3D berpresisi tinggi. Data menggambarkan keruntuhan gelembung dan fragmentasi tetesan yang disebabkan oleh gelombang kejut. Aliran seperti ini memiliki gelombang kejut dan antarmuka material.
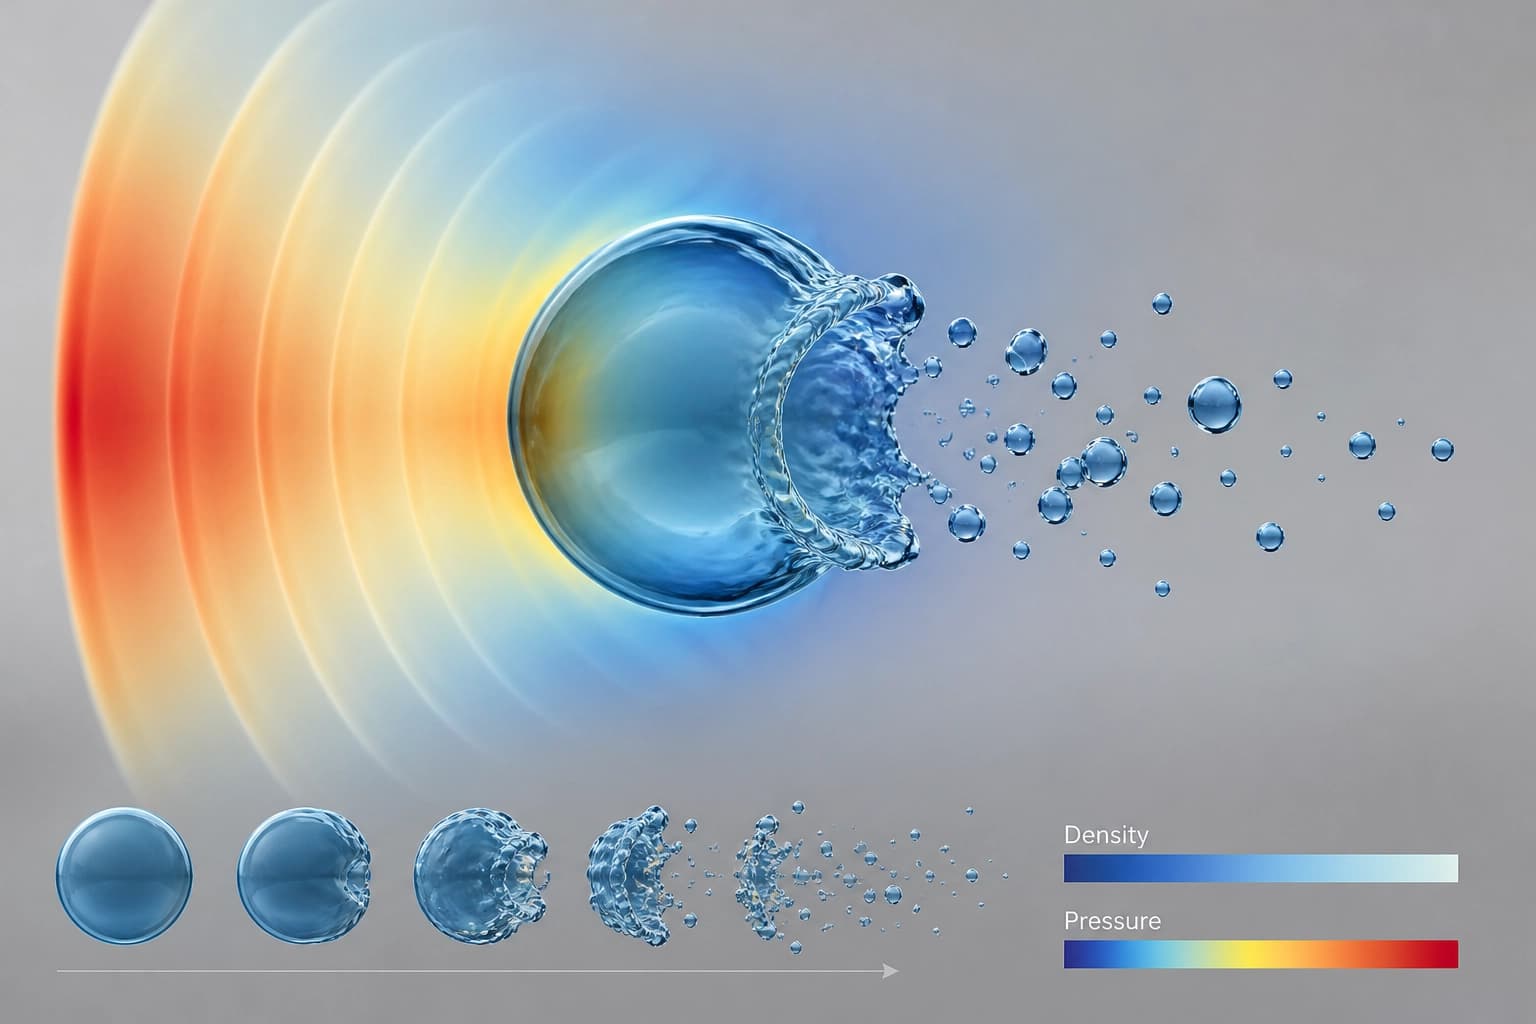
Interaksi nonlinier yang kuat menyebabkan deformasi antarmuka yang kompleks, pencampuran, dan dinamika multiskala. Ada tiga faktor yang menyulitkan pembuatan model surrogate yang andal:
- kompresibilitas;
- diskontinuitas tajam;
- efek multifase.
Faktor-faktor ini hadir secara bersamaan.
Kesimpulan: data ini menguji model pada diskontinuitas dan antarmuka. Kriteria praktis: sertakan skenario dengan diskontinuitas dan antarmuka dalam pengujian.
Arsitektur yang dibandingkan
Benchmark ini mengevaluasi model konvolusional, spektral, dan berbasis transformer. PDE foundation models yang telah dilatih sebelumnya juga disertakan dalam evaluasi. Benchmark ini menguji keluarga-keluarga model tersebut pada aliran multifase kompresibel dengan diskontinuitas.
Perbandingan ini mencakup berbagai cara untuk membangun model surrogate. Evaluasinya tidak terbatas pada satu keluarga model. Arsitektur dinilai menggunakan data dan metrik yang sama.
Kesimpulan: arsitektur dipilih sesuai dengan tugas, bukan berdasarkan nama keluarganya. Kriteria praktis: uji arsitektur pada kumpulan data tempat arsitektur itu akan digunakan.
Fungsi loss
Pelatihan standar dalam benchmark ini menggunakan MSE. Fungsi loss komposit juga diuji. Fungsi tersebut menggabungkan MSE dengan komponen Sobolev, interface-aware, dan structure-aware.
SoftAdapt dan GradNorm digunakan untuk menyeimbangkan loss secara adaptif. Benchmark ini mencakup kedua opsi tersebut.
| Opsi | Komposisi |
|---|---|
| MSE | Fungsi loss dasar |
| Fungsi komposit | MSE + Sobolev + interface-aware + structure-aware |
| SoftAdapt | Penyeimbangan loss adaptif |
| GradNorm | Penyeimbangan loss adaptif |
Kesimpulan: pemilihan fungsi loss bergantung pada metrik target. Kriteria praktis: sertakan SoftAdapt dan GradNorm untuk menguji penyeimbangan adaptif.
Metrik evaluasi
Evaluasi mencakup lima kelompok metrik:
- per titik;
- spektral;
- berorientasi fitur;
- struktural;
- memperhitungkan fisika.
Metrik yang digunakan bersifat multidimensi. Kesimpulan: model tidak dapat dinilai hanya dari satu metrik. Kriteria praktis: tentukan sejak awal kelompok metrik yang penting untuk tugas.
Hasil perbandingan
Tidak ada model yang menjadi yang terbaik pada semua kumpulan data dan untuk semua metrik. Hasil ini berlaku untuk berbagai arsitektur dan konfigurasi. Fungsi loss komposit secara signifikan meningkatkan kemampuan mempertahankan antarmuka dan akurasi spektral.
SoftAdapt memberikan peningkatan paling konsisten dengan hampir tanpa biaya komputasi tambahan dibandingkan pelatihan yang hanya menggunakan MSE. GradNorm juga disertakan dalam evaluasi. Tidak ada satu pemenang untuk semua indikator.
| Yang dibandingkan | Kesimpulan |
|---|---|
| Arsitektur | Tidak ada yang terbaik pada semua kumpulan data dan metrik |
| Fungsi loss komposit | Meningkatkan kemampuan mempertahankan antarmuka dan akurasi spektral |
| SoftAdapt | Peningkatan paling konsisten dengan hampir tanpa biaya tambahan |
Kesimpulan: pilihan bergantung pada kumpulan data dan metrik. Kriteria praktis: tentukan metrik yang penting, lalu uji fungsi loss dan arsitektur pada kumpulan data target.
Status dan akses
Karya Neptuna diterima di NeurIPS-2026 (Evaluations and Datasets Track). Artikel diajukan pada 24 Jul 2026 (v1); revisi terakhir pada 18 Okt 2026 (v3). arXiv:2607.22280.
Repositori benchmark dan kumpulan data tersedia melalui tautan this https URL. Ini memungkinkan evaluasi direproduksi dan model dibandingkan dengan hasil benchmark.
Kesimpulan: benchmark ini tersedia untuk pengujian praktis. Kriteria praktis: gunakan repositori sebagai dasar untuk perbandingan yang dapat direproduksi.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan
Invarian polinomial kanonik dalam diagnostik kegagalan simulator RL: di mana sebenarnya berguna?
Studi ini menguji apakah menyertakan hukum fisika dalam model dinamika yang dapat dilatih memang sepadan: invarian yang diekstrak dari lintasan dan diubah ke bentuk kanonis melalui basis Gröbner hanya sedikit meningkatkan prediksi, tetapi sangat berguna untuk diagnosis—invarian ini dapat membantu menemukan kendala yang dilanggar dan mengidentifikasi parameter spesifik yang keliru.
10 November 2026
AURA-Eval: cara memeriksa apakah agen LLM mengenali risiko dan mengubah langkah berikutnya
Framework ini mengevaluasi perilaku agen LLM bukan berdasarkan keputusan akhir, melainkan respons terhadap risiko di titik-titik penting: rangkaian pemanggilan alat dihentikan, lalu model harus melanjutkan penalaran dan tindakan, sementara panel juri LLM menilai deteksi risiko, karakter, dan keamanan langkah tersebut. Dalam 1.249 tugas yang dikumpulkan dari 157 rangkaian R-Judge, 20 model lebih sering melakukan tindakan tidak aman saat jalur aman tidak tersedia, dan penghapusan pengawasan sebelum eksekusi mengubah 52,3% kasus yang semula aman menjadi tidak aman.
10 November 2026
Memori reservoir Chern–Simons: dinamika konektivitas mandiri dan transfer densitas
Artikel ini membahas bagaimana reservoir menyimpan riwayat sinyal masukan secara bersamaan dalam distribusi densitas dan derajat kebebasan geometris. Perbandingan empat mekanisme menunjukkan bahwa arus menciptakan komponen keterhubungan tersendiri yang mengubah respons densitas berikutnya, sementara penggunaan semua fitur yang terukur memberikan sedikit peningkatan dalam dekode urutan pulsa.
10 November 2026