
Indikator Tersembunyi dalam Arsitektur MoE Mengungkap Jawaban Palsu LLM
Pendekatan baru InnerExpert memanfaatkan karakteristik perutean dan perbedaan pendapat para ahli dalam model MoE untuk mengidentifikasi fragmen yang dibuat-buat berdasarkan token. Metode ini dilatih tanpa anotasi manual dan pada lima dataset menunjukkan akurasi hingga 0,91 pada tingkat jawaban dan 0,76 pada tingkat token dalam satu kali proses.
Mengapa Keyakinan Palsu LLM Bukan Sekadar Bug
Model bahasa modern telah belajar menyampaikan pikiran dengan lancar dan meyakinkan. Namun di balik keyakinan ini, sering kali tersembunyi apa yang para ahli sebut sebagai halusinasi: model menghasilkan konten yang terdengar masuk akal, tetapi sepenuhnya fiktif. Bagi pengguna, ini terlihat seperti teks yang mulus dan penuh keyakinan — dan justru itulah mengapa masalah ini berbahaya.
Sebagian besar detektor halusinasi yang umum bekerja secara kasar. Mereka mengevaluasi seluruh jawaban secara keseluruhan atau per kalimat, melaporkan sesuatu seperti «sepertinya ada kesalahan di sini». Tetapi untuk memahami di bagian mana tepatnya model «mengarang fakta», diperlukan pemeriksaan yang lebih halus — pada tingkat token individual. Hanya deteksi per-token yang memungkinkan pelokalan fragmen palsu dan intervensi yang tepat sasaran dalam proses generasi, tanpa menyentuh teks lainnya.
Model MoE Secara Tidak Sengaja Memberi Petunjuk
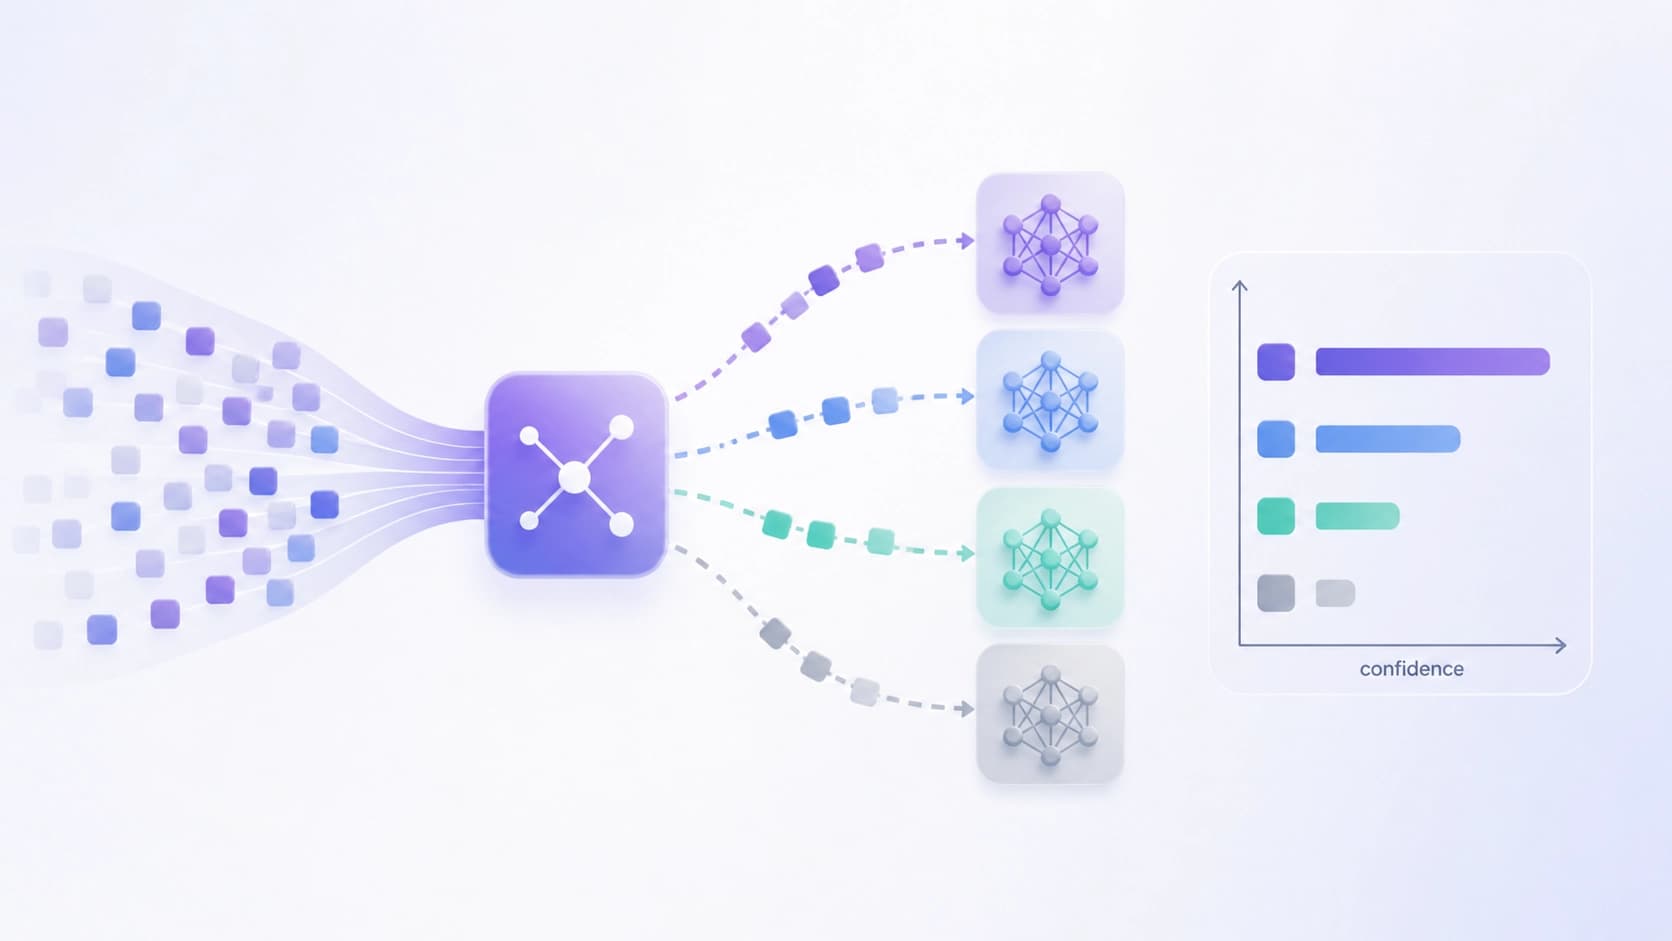
Dalam arsitektur seperti Mixture-of-Experts (MoE), terdapat prinsip yang menarik: dalam satu proses maju (forward pass), hanya subset «ahli» yang jarang (sparse) yang diaktifkan, bukan seluruh jaringan. Pemilihan siapa yang dipanggil dilakukan oleh mekanisme routing. Dan justru pada momen inilah muncul sinyal internal yang tidak dimiliki oleh arsitektur padat (dense):
- entropi router — seberapa «tidak yakin» model tentang ahli mana yang harus dituju;
- perbedaan pendapat antar ahli — seberapa jauh hasil antara mereka menyimpang;
- pola penggunaan ahli — spesialis mana yang lebih sering diaktifkan.
Sebelumnya, sinyal-sinyal ini hampir tidak pernah digunakan untuk mendeteksi halusinasi. Para peneliti João Fonseca, Rodrigo Rodrigues, dan Paolo Romano dalam artikel arXiv:2608.17687 menunjukkan bahwa hal itu sia-sia: indikator tersembunyi mampu mengungkap momen ketika model mulai mengarang. Karya ini dipresentasikan di arXiv pada 18 Agustus 2026.
InnerExpert: Detektor yang Melihat ke Dalam Model
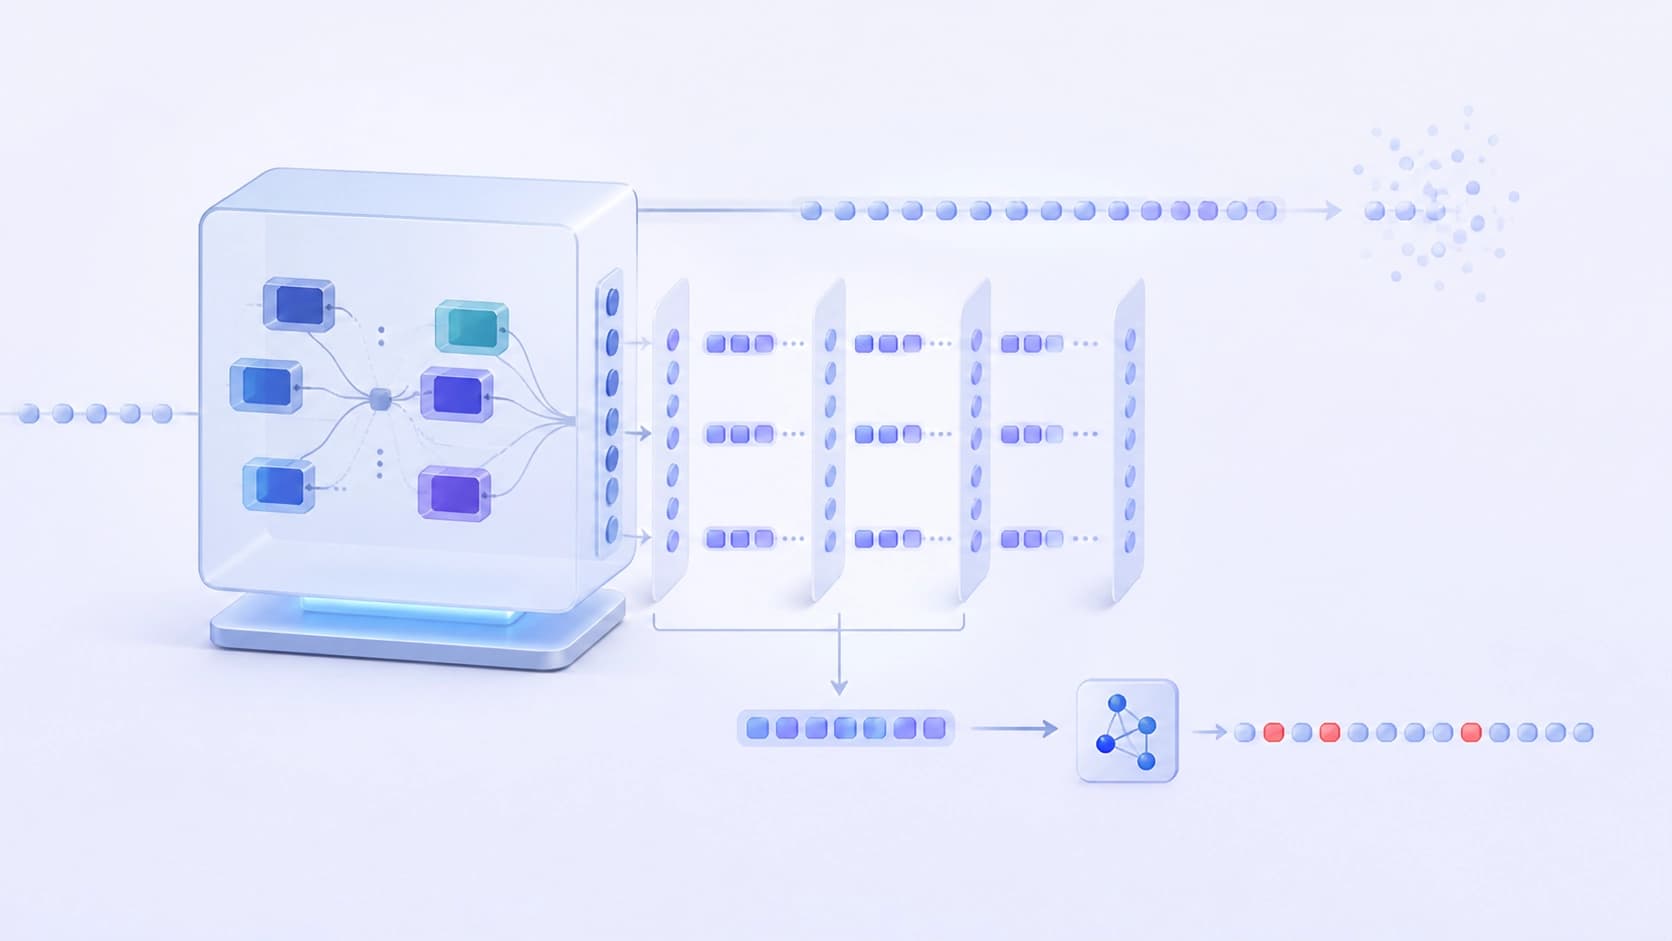
Metode InnerExpert yang diusulkan oleh para penulis menggabungkan dua jenis data: sinyal spesifik MoE pada tingkat routing dan representasi internal standar transformer. Semua ini dikumpulkan menjadi vektor fitur yang ringkas untuk setiap token. Kemudian, pengklasifikasi ringan memproses vektor-vektor ini dan menentukan apakah token tersebut merupakan halusinasi.
Fitur utamanya adalah pembelajaran otomatis. Label untuk melatih detektor dibuat oleh pipeline LLM-as-a-judge, di mana satu model bahasa mengevaluasi keluaran model lainnya. Tidak diperlukan anotasi manual sama sekali. Ini berarti detektor dapat dengan cepat diadaptasi ke versi baru model generatif, cukup dengan menjalankan ulang pipeline tersebut.
Apa yang Ditunjukkan oleh Pengujian
Eksperimen mencakup lima dataset dan dua arsitektur MoE yang berbeda. Dalam pengujian, InnerExpert secara konsisten mengungguli detektor yang sudah ada. Hasil terbaik mencapai 0,91 AUROC pada tingkat jawaban keseluruhan dan 0,76 AUROC pada tingkat token individual. Terlebih lagi, ini cukup dilakukan dengan satu proses maju — tidak perlu menjalankan model pemeriksa tambahan atau generasi berulang.
Hasil tingkat-jawaban yang tinggi berguna untuk penyaringan kasar. Namun metrik yang benar-benar berharga adalah tingkat-token: ini memungkinkan penemuan bagian teks palsu secara tepat dan, misalnya, menulis ulang atau menyorotnya untuk pengguna. Ini bukan lagi «ada kesalahan di suatu tempat», melainkan lokasi spesifik dalam jawaban.
Mengapa Ini Penting
Halusinasi tetap menjadi salah satu hambatan utama adopsi LLM di bidang medis, hukum, keuangan, dan sektor lain yang sensitif terhadap kesalahan. Kemampuan untuk melihat ke dalam sinyal internal model dan melihat «keraguannya» sejak dini — adalah langkah praktis lain menuju generasi yang transparan. Indikator tersembunyi tidak sepenuhnya menghilangkan masalah, tetapi memberikan alat kerja yang sudah tersedia.
Yang menarik secara terpisah adalah bahwa diagnosis halusinasi lahir dari karakteristik arsitektur itu sendiri. Model MoE diciptakan untuk kecepatan dan efisiensi, dan struktur internalnya ternyata secara tak terduga berguna untuk kontrol kualitas. Penelitian lebih lanjut tentu akan melangkah lebih dalam — menuju sinyal yang lebih halus di dalam para ahli dan mekanisme routing.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan
OpenCollab: koordinasi agen yang dapat diprogram, lingkungan eksekusi terkontrol, dan metrik kepatuhan terhadap kebijakan
Framework ini menyatukan penetapan struktur interaksi agen, lingkungan eksperimen bersama, dan pelacakan peristiwa yang terperinci, sementara metrik Adherence yang diperkenalkan menunjukkan sejauh mana pelaksanaan aktual sesuai dengan skema yang dinyatakan. Dalam benchmark, konfigurasi Duo mencapai tingkat SOTA baru, sedangkan varian agen tunggal memiliki konsumsi token terendah.
11 November 2026
Toollery: memilih alat untuk agen LLM dari puluhan ribu opsi tanpa fine-tuning
Toollery membangun indeks pencarian berdasarkan deskripsi keterampilan dan alat, lalu saat ada permintaan hanya meneruskan sekumpulan kandidat terbatas ke model. Dalam eksperimen pada pustaka berskala hingga puluhan ribu fungsi, pendekatan ini mampu mempertahankan kualitas pemilihan dengan top-K tetap, meskipun dampak akhirnya bergantung pada profil beban dan caching di penyedia.
11 November 2026
Diagnostik bertahap agen GUI dalam analisis dasbor: benchmark DashAct
DashAct diperkenalkan sebagai tolok ukur yang terdiri atas 348 trajektori yang diverifikasi manusia, yang menguraikan kerja agen GUI dengan panel interaktif menjadi tiga tahap dan empat kondisi visual. Hasilnya menunjukkan masalah yang terus berulang dalam memprediksi tindakan dan mengaitkannya dengan target visual, serta ketergantungan respons agen pada dukungan kontekstual dan spasial.
11 November 2026