
Pendekatan Baru LSem2Vec: cara mendapatkan vektor kode dalam dua langkah dan tanpa pelatihan yang mahal
Para peneliti mengusulkan metode sederhana untuk menyematkan kode sumber yang menggabungkan model bahasa besar dan model penyematan teks. Metode LSem2Vec tidak memerlukan penyesuaian halus untuk tugas tertentu dan, berdasarkan hasil eksperimen, mengungguli lima pendekatan tanpa pengawasan modern.
Apa itu Code Embeddings
Representasi vektor dari kode sumber dibutuhkan untuk berbagai tugas praktis: dari mencari fragmen serupa hingga mengelompokkan fungsi secara otomatis berdasarkan makna. Program diubah menjadi sekumpulan angka yang dapat diproses oleh algoritme pembelajaran mesin. Kualitas vektor di sini bergantung pada seberapa baik model memahami semantik kode, bukan hanya sintaksisnya.
Apa Kesulitannya
Metode klasik biasanya memerlukan pelatihan terpisah untuk setiap tugas, atau setidaknya penyempurnaan pada data domain. Ini mahal dan tidak selalu sepadan. Pendekatan berbasis model bahasa besar (LLM) tampak lebih universal, tetapi ada kekurangannya: dalam respons model, sering kali terdapat informasi yang berlebihan atau keliru, dan “kotoran” ini ikut masuk ke dalam vektor.
Ide LSem2Vec
Para penulis mengusulkan pendekatan dua tahap dengan nama yang menggambarkan diri sendiri, LSem2Vec — LLM-extracted code Semantics to Vector embedding. Alih-alih mencoba melatih model berat lainnya, mereka menggabungkan komponen yang sudah ada: LLM mengekstrak makna dari kode, dan model embedding kalimat mengubah deskripsi tersebut menjadi vektor. Penyempurnaan untuk tugas tertentu tidak diperlukan.
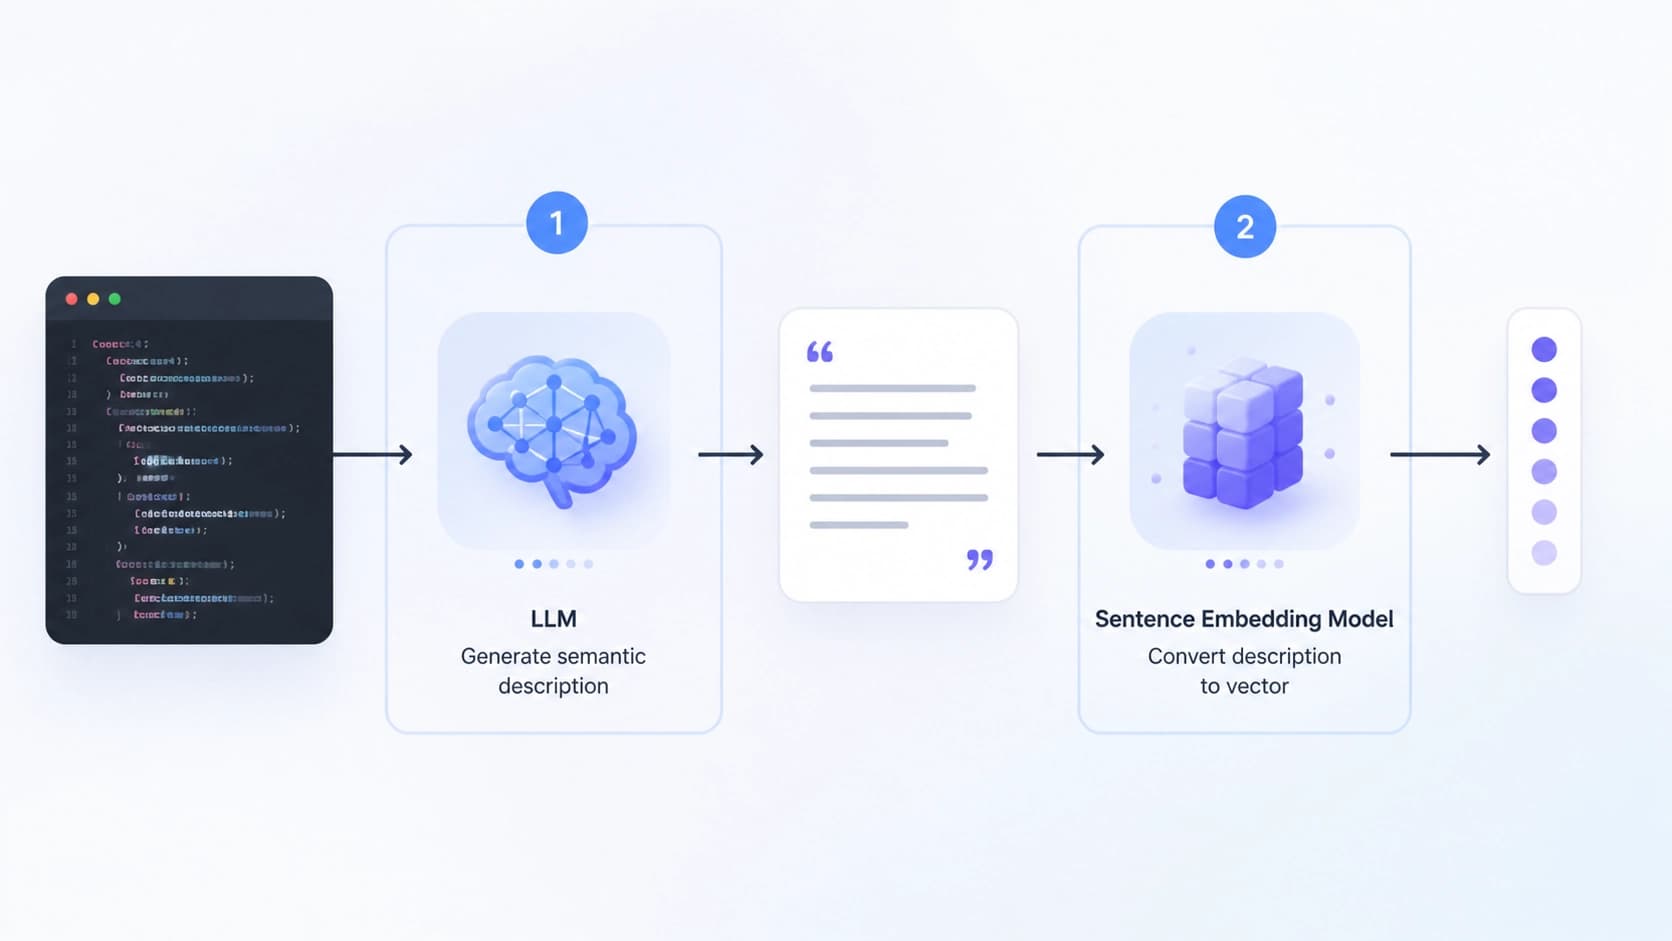
Mari kita uraikan prosesnya langkah demi langkah. Pada tahap pertama, LLM menerima kode dan harus merumuskan apa yang sebenarnya dilakukan kode tersebut. Ini bukan parafrase mekanis dari kode sumber, melainkan identifikasi inti: model membuang detail sekunder sehingga hanya hal penting bagi makna yang masuk ke dalam deskripsi. Secara bersamaan, pendekatan ini juga memangkas kemungkinan “halusinasi” model besar — informasi keliru yang paling sering muncul saat mencoba mengodekan kode secara langsung.
Tahap kedua sepele menurut standar pembelajaran mesin: deskripsi yang diperoleh dari LLM dimasukkan ke dalam model embedding kalimat. Model semacam itu telah dilatih untuk mengubah bahasa alami menjadi vektor yang bermakna, sehingga tidak perlu mengadaptasinya ke sintaksis bahasa pemrograman.
Mengapa Ini Berhasil
Kekuatan LSem2Vec terletak pada pembagian peran yang jelas. Satu model bertanggung jawab untuk memahami logika, model lainnya untuk menerjemahkan teks menjadi vektor. Masing-masing menyelesaikan tugasnya dengan cara terbaik, dan bersama-sama mereka menghasilkan vektor yang didasarkan pada semantik, bukan pada fitur formal kode. Tidak adanya tahap pelatihan membuat pendekatan ini murah dan mudah untuk direproduksi.
Bagaimana Pengujiannya dan Hasilnya
Eksperimen dilakukan pada tiga kumpulan data yang disusun dalam berbagai bahasa pemrograman. Para penulis sengaja mengganti-ganti LLM dan model embedding untuk memastikan bahwa hasilnya tidak bergantung pada pasangan alat tertentu.
Di semua konfigurasi, LSem2Vec menunjukkan hasil yang lebih baik daripada lima metode tak terawasi modern yang biasanya dirancang untuk kondisi spesifik dan memerlukan penyesuaian.
Status Penelitian
Artikel ini diunggah ke arXiv pada September 2024, dengan versi terakhir yang tersedia adalah v5 dari Agustus 2026. Menurut informasi dari penulis, karya ini telah diterima oleh jurnal Frontiers of Computer Science. Artinya, pendekatan ini tidak hanya memiliki halaman pracetak, tetapi juga publikasi yang telah ditinjau sejawat. Naskah asli dapat ditemukan melalui DOI: 10.1007/s11704-026-61288-0.
Kesimpulan
Kesimpulan utama LSem2Vec adalah bahwa tugas yang rumit tidak selalu membutuhkan solusi yang rumit. Cukup dengan menerapkan LLM secara berurutan untuk mengekstrak makna dan model embedding kalimat untuk membuat vektor. Ini cepat, tanpa penyempurnaan khusus, dan memberikan hasil yang kompetitif.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan
Verifikasi kandidat lebih mahal daripada generasinya: honeypot untuk melawan pencarian kerentanan berbasis LLM
Karya ini mengulas asimetri biaya dalam pencarian bug oleh agen: menghasilkan kandidat itu murah, sedangkan mengonfirmasinya melalui analisis keterjangkauan, eksekusi, dan PoC membutuhkan sebagian besar anggaran, sehingga verifikasi dapat dijadikan sasaran pertahanan tersendiri. RedHerring yang diusulkan—umpan yang disesuaikan dengan repositori dan dilengkapi sertifikat tertutup—mengurangi jumlah kerentanan nyata yang ditemukan sebesar 38,7–60,4% dengan biaya yang sama di 33 proyek OSS-Fuzz; bahkan setelah agen diperingatkan, penurunannya tetap mencapai 37,2%.
9 November 2026
Pemeriksaan halusinasi LLM melalui tampilan sumber SQL tanpa fine-tuning
Penelitian ini menguji apakah LLM dapat memanfaatkan keterampilan simbolik dasar—menyusun basis data SQL dari dokumen sumber—untuk melakukan grounding ke sumber tanpa supervisi dalam deteksi halusinasi. Pada RAGTruth dan DiaHalu, pipeline neuro-simbolik ini lebih akurat daripada prediksi langsung dan sebanding dengan metode mutakhir, tanpa memerlukan fine-tuning khusus domain.
9 November 2026
MathAdv: Apa yang Tersembunyi di Balik Akurasi Akhir Pembuktian Mesin
Kumpulan tugas diagnostik dari 13 bidang matematika tingkat universitas dan pascasarjana ini mengevaluasi sistem pembuktian otomatis di Lean 4 tidak hanya berdasarkan hasil akhir, tetapi juga penguasaan materi, kualitas penalaran informal, dan ketahanan terhadap perumusan ulang soal. Analisis per komponen menunjukkan bahwa menerjemahkan soal ke dalam bentuk formal masih menjadi kendala utama, sementara tingkat keberhasilan sangat bergantung pada bidang matematika dan cara soal dirumuskan.
9 November 2026