
Ringkasan spektral per halaman alih-alih sketsa umum: LOCKS dan pemilihan blok tanpa membaca kunci
Metode LOCKS menyimpan representasi berperingkat rendah yang terpisah untuk kunci setiap halaman konteks, sehingga penilaian kepentingan blok hanya bergantung pada ringkasan ini, dan kunci kandidat itu sendiri tidak dibaca. Pada tugas-tugas panjang, solusi ini menjaga kualitas mendekati cache penuh dengan mengakses sekitar 2% token dan penurunan latensi decoding yang signifikan.
Mengapa sketsa umum tidak berfungsi untuk halaman
Melayani model bahasa besar pada konteks panjang berbenturan dengan key-value (KV) cache. Cache dibaca seluruhnya pada setiap langkah decoding. Attention keys bersifat locally low-rank, meskipun globally high-rank. Sketsa low-rank tetap yang sama untuk semua halaman terbukti buta terhadap arah halaman.
Dengan ukuran summary yang sama, basis khusus halaman memberi peringkat halaman dan mempertahankan pembawa jauh lebih baik. Sketsa umum tidak melihat arah tersebut. Summary spektral per halaman menyelesaikan masalah ini.
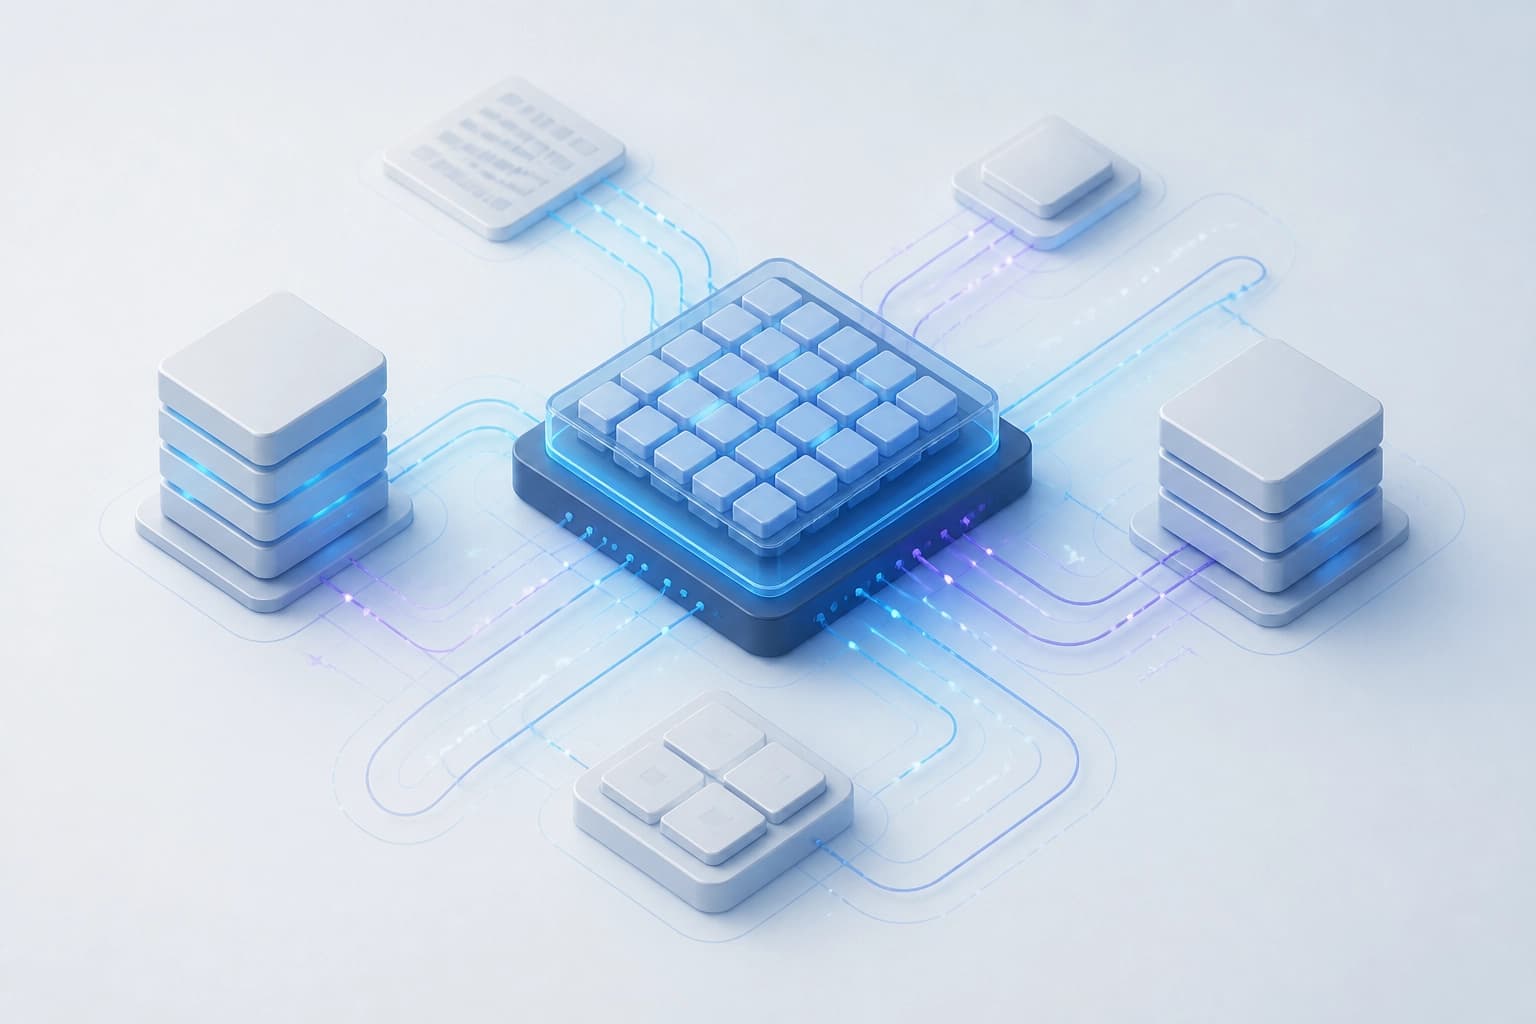
Ringkasan spektral per halaman
LOCKS memberikan setiap halaman rank-r spectral summary tersendiri. Ringkasan bersifat residen: sepersepuluh cache pada r=8 dan seperdua puluh lima pada r=2. Metode ini merekonstruksi logit intra-halaman. Metode ini memperkirakan massa attention setiap halaman melalui log-sum-exp. Kemudian hanya memproses halaman teratas.
Elemen kunci:
- Nama: Page-Local Compact Key Summaries for Efficient Long-Context Decoding.
- Ringkasan: rank-r spectral summary untuk setiap halaman.
- Residensi: sepersepuluh cache pada r=8, seperdua puluh lima pada r=2.
- Rekonstruksi: logit intra-halaman.
- Estimasi: massa attention halaman melalui log-sum-exp.
- Seleksi: hanya halaman teratas.
Kesimpulan: ringkasan menempati sebagian kecil cache, tetapi mempertahankan ciri halaman. Seleksi halaman dilakukan berdasarkan data spektral.
Seleksi blok tanpa membaca key
Seleksi itu sendiri tidak membaca key atau value kandidat. Pemilihan hanya berdasarkan ringkasan spektral. Ringkasan dipindai sepenuhnya pada setiap langkah. Pembacaan KV per langkah turun 10–25 kali dalam rentang rank yang disebutkan.
Latensi decoding per token berkurang setengah. Pada 1M token di satu H200 NVL, percepatan mencapai 2.0× pada r=8. Ini perbandingan dengan dense attention. Seleksi tidak bergantung pada pembacaan key kandidat.
Kualitas pada tugas panjang
LOCKS mempertahankan kualitas pada beberapa jenis tugas. Pada long-document QA (LongBench-v1; Llama-3.1-8B) hasilnya tetap dalam selisih satu poin dari cache penuh. Pada retrieval-dense RULER metode ini mengikuti LSE-oracle tepat yang membaca setiap key, hingga budget terkecil sekalipun. Pada long-form reasoning (AIME26, MATH-500; Qwen3-4B) kualitas bertahan paling lama dalam mode budget kecil. Selektor dan kompresor penalaran berbasis eviction di sana tertinggal.
Pada budget 2048 token LOCKS menyamai kualitas agregat FullKV pada konteks 100K+ (GLM-4-9B-Chat-1M). Metode ini memproses 2% token.
| Kondisi | Hasil |
|---|---|
| Long-document QA (LongBench-v1; Llama-3.1-8B) | dalam selisih satu poin dari cache penuh |
| Retrieval-dense RULER | mengikuti LSE-oracle tepat hingga budget kecil |
| Long-form reasoning (AIME26, MATH-500; Qwen3-4B) | mempertahankan kualitas paling lama pada budget kecil |
| Budget 2048 token, konteks 100K+ (GLM-4-9B-Chat-1M) | menyamai FullKV, memproses 2% token |
Kesimpulan: pada tugas-tugas yang disebutkan, pendekatan ini mempertahankan kualitas lebih lama daripada selektor dan kompresor berbasis eviction.
Penerapan dan kriteria pemilihan
Pendekatan ini tersedia sebagai plugin drop-in untuk vLLM tanpa modifikasi. Decoding batch berjalan dalam CUDA graph penuh. Tidak diperlukan modifikasi vLLM.
Kriteria pemilihan: konteks panjang, budget token terbatas, kebutuhan untuk mengurangi pembacaan KV dan latensi decoding. Jika tugas memerlukan seleksi blok tanpa membaca key kandidat, pendekatan ini cocok.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan
Invarian polinomial kanonik dalam diagnostik kegagalan simulator RL: di mana sebenarnya berguna?
Studi ini menguji apakah menyertakan hukum fisika dalam model dinamika yang dapat dilatih memang sepadan: invarian yang diekstrak dari lintasan dan diubah ke bentuk kanonis melalui basis Gröbner hanya sedikit meningkatkan prediksi, tetapi sangat berguna untuk diagnosis—invarian ini dapat membantu menemukan kendala yang dilanggar dan mengidentifikasi parameter spesifik yang keliru.
10 November 2026
AURA-Eval: cara memeriksa apakah agen LLM mengenali risiko dan mengubah langkah berikutnya
Framework ini mengevaluasi perilaku agen LLM bukan berdasarkan keputusan akhir, melainkan respons terhadap risiko di titik-titik penting: rangkaian pemanggilan alat dihentikan, lalu model harus melanjutkan penalaran dan tindakan, sementara panel juri LLM menilai deteksi risiko, karakter, dan keamanan langkah tersebut. Dalam 1.249 tugas yang dikumpulkan dari 157 rangkaian R-Judge, 20 model lebih sering melakukan tindakan tidak aman saat jalur aman tidak tersedia, dan penghapusan pengawasan sebelum eksekusi mengubah 52,3% kasus yang semula aman menjadi tidak aman.
10 November 2026
Memori reservoir Chern–Simons: dinamika konektivitas mandiri dan transfer densitas
Artikel ini membahas bagaimana reservoir menyimpan riwayat sinyal masukan secara bersamaan dalam distribusi densitas dan derajat kebebasan geometris. Perbandingan empat mekanisme menunjukkan bahwa arus menciptakan komponen keterhubungan tersendiri yang mengubah respons densitas berikutnya, sementara penggunaan semua fitur yang terukur memberikan sedikit peningkatan dalam dekode urutan pulsa.
10 November 2026