
Singkatnya: masalahnya bukan pada bahasa, melainkan pada aksara
Filter keamanan model bahasa besar biasanya dinilai dalam bahasa Inggris. Dari sini muncul ilusi yang nyaman: jika model dengan yakin menangkap hinaan dan seruan kekerasan dalam teks bahasa Inggris, maka bahasa lain pun akan ditangani kurang lebih sama. Urdu — bahasa dengan sekitar 246 juta penutur, kesepuluh terbesar di dunia berdasarkan jumlah ini — hampir tidak pernah masuk dalam pengujian semacam itu. Dan celah ini, ternyata, memiliki harga yang terukur.
Hal ini dibahas dalam karya terbaru dengan identifikator arXiv:2608.24191. Judulnya «Ghaib in Translation» memainkan kata ghaib, yang dalam bahasa Urdu berarti «tersembunyi, tak terlihat»: yang dibicarakan adalah bahaya yang luput dari perhatian. Penulisnya adalah Fawzia Zehra (Fuzzy) Kara-Isitt, Sonal Khosla, dan Stephen Swift. Versi pertama muncul pada 25 Agustus 2026, revisi terbarunya — 9 September tahun yang sama; artikel ini termasuk dalam bidang cs.CL dan cs.AI, DOI — 10.48550/arXiv.2608.24191.
Bagaimana eksperimennya dirancang
Model dan data
Tim menjalankan skenario klasifikasi yang sama pada lima model populer: GPT-4o, Claude Sonnet 4.5, Gemini 2.5 Flash, Qwen-2.5, dan Llama-3.1. Kumpulan datanya terdiri dari enam dataset yang mencakup empat bentuk keberadaan bahasa yang berbeda: Urdu dalam aksara nastaliq, Urdu dengan huruf Latin (romani), bahasa Inggris, dan teks campuran Urdu-Inggris, di mana bahasa berganti di dalam satu pesan.
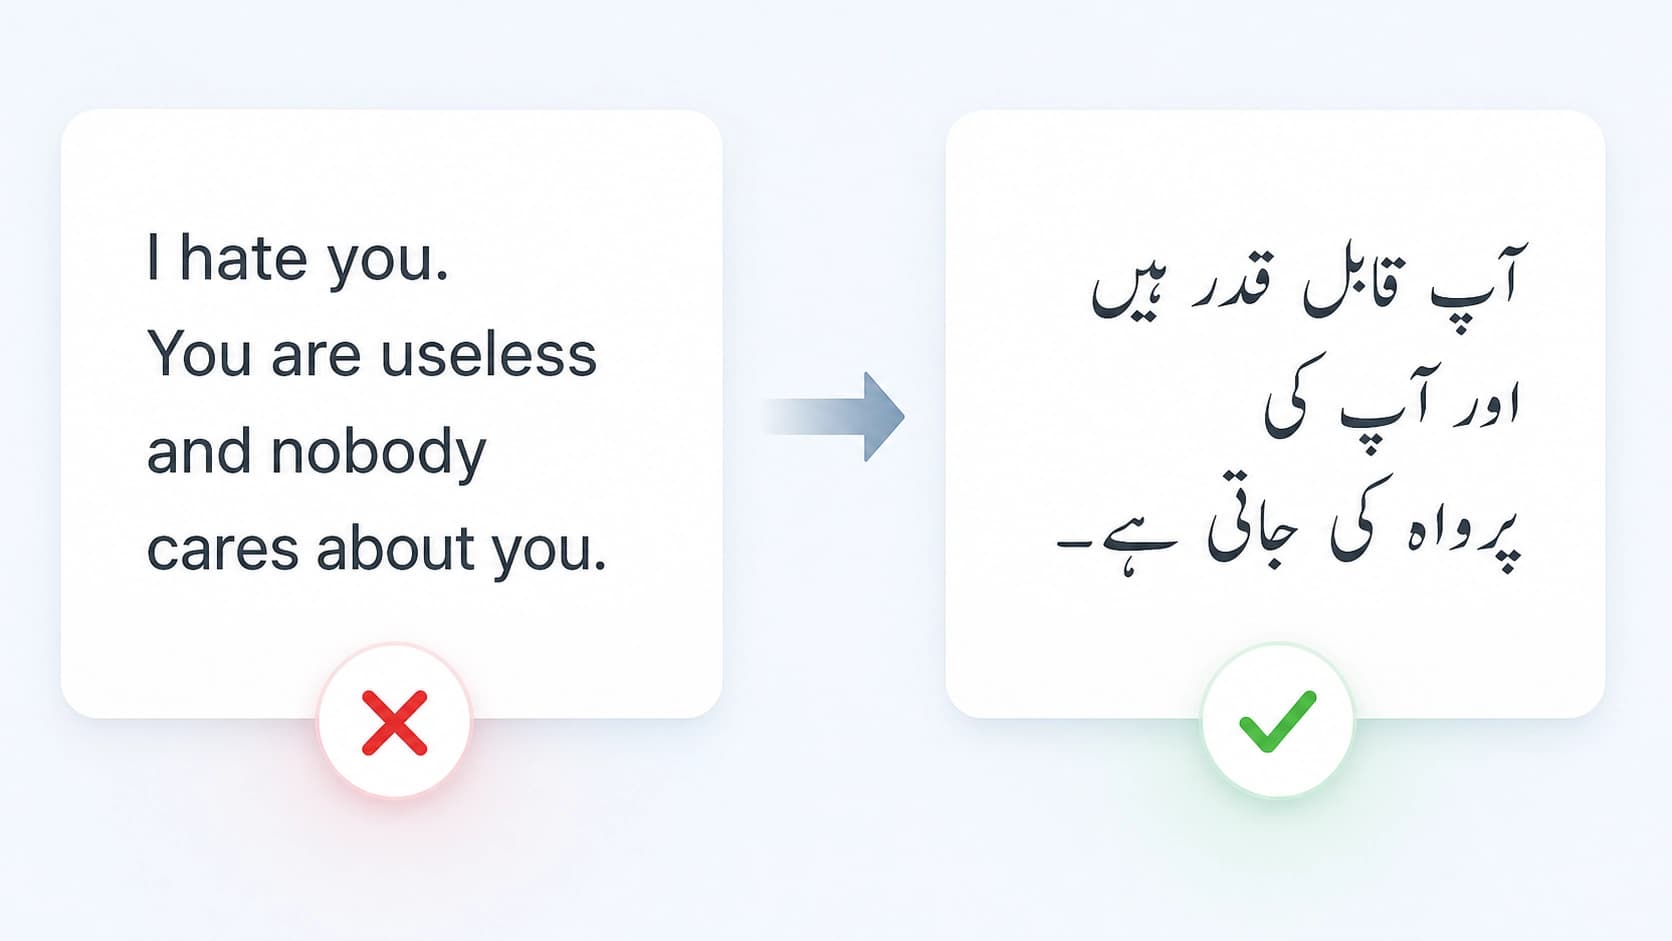
Detail penting: yang diuji bukan sekadar kualitasnya, melainkan kestabilan keputusan. Makna yang sama disajikan kepada model dua kali — dalam aksara asli dan dalam terjemahan bahasa Inggris. Jika filter hanya aktif pada kasus kedua, berarti perlindungannya terikat bukan pada isi, melainkan pada huruf apa yang dipakai untuk menuliskannya.
Dua metrik
Penulis menggunakan dua indikator sederhana. Pertama — proporsi perbedaan: seberapa sering label berubah antara teks asli dan terjemahan. Kedua mendapat nama «Missed-in-Urdu»: yaitu konten yang dalam versi bahasa Inggris dianggap berbahaya, tetapi dalam aksara asli lolos sebagai tidak berbahaya. Pada dasarnya, ini adalah kelolosan murni — justru hal yang menjadi alasan keberadaan moderasi.
Apa yang ditunjukkan angka-angka
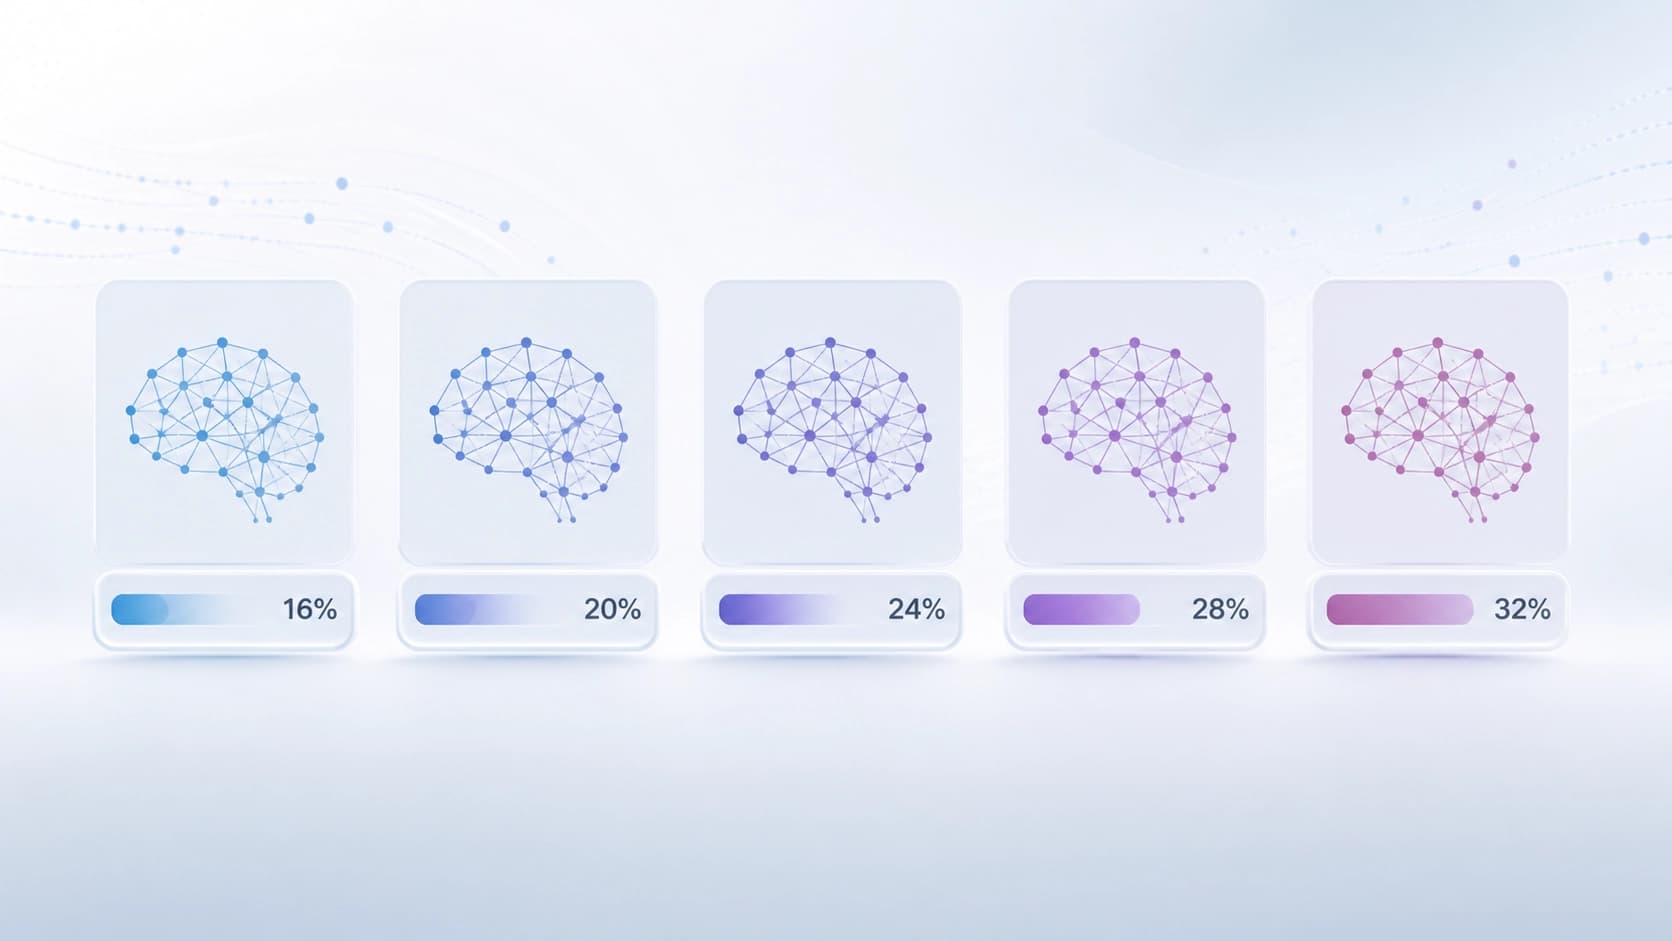
Dari lima dataset di mana teks ditulis dengan aksara Urdu, rentang hasil antara klasifikasi pada teks asli dan terjemahan berkisar dari 15,9% hingga 31,6%. Hasil terbaik — pada Gemini 2.5 Flash, terburuk — pada Qwen-2.5. Dengan kata lain, dalam kasus paling buruk, sekitar satu dari tiga keputusan filter bergantung pada alfabet apa teks yang sama disajikan.
Proporsi bahaya yang terlewat — dari 2,4% hingga 9,9% dengan median 4,3%. Sekilas tidak banyak, tetapi ada baiknya diterjemahkan ke skala manusia: jika sebuah platform dengan audiens jutaan pengguna memproses puluhan ribu pesan per hari, bahkan 4% berarti ratusan unit konten toksik setiap hari yang lolos begitu saja. Terlebih lagi, ini bukan tentang kasus batas seperti sarkasme, melainkan materi yang oleh model yang sama dengan yakin ditandai sebagai berbahaya begitu diterjemahkan.
Pola umum yang dicatat penulis: semakin kecil dan terbuka modelnya, semakin terlihat penurunan kedua metrik. Sistem tertutup kelas flagship bertahan lebih stabil, tetapi pada mereka pun kesenjangannya tidak nol.
Sembilan tahun literatur — dan tidak ada satu pun karya
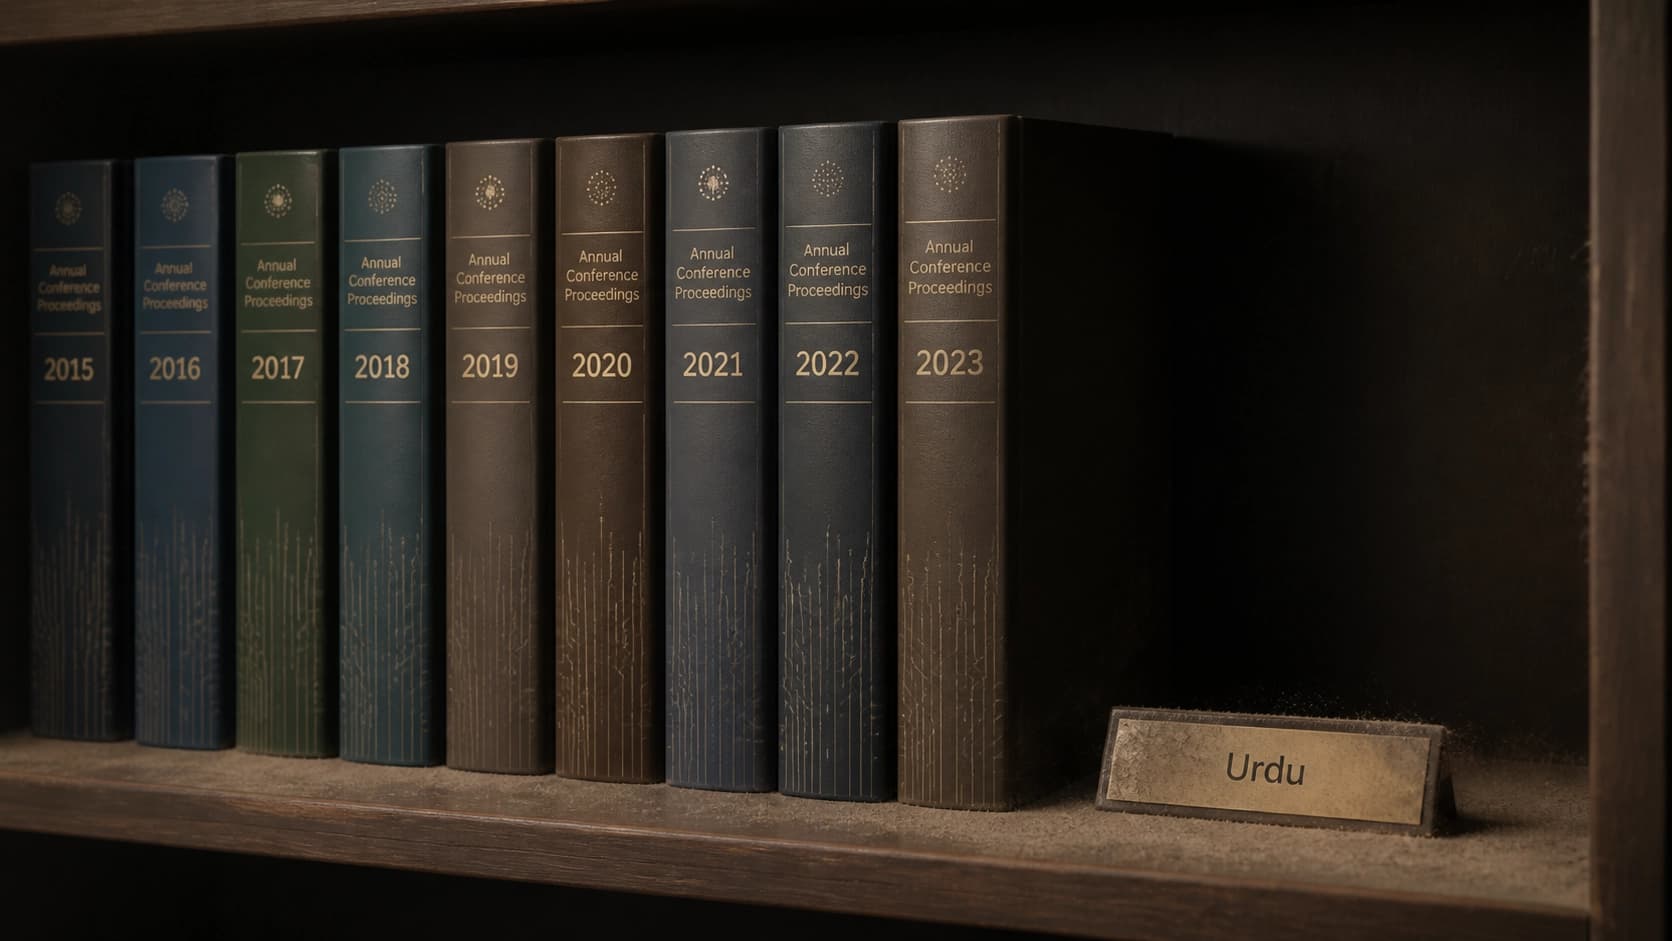
Lini penelitian tersendiri adalah bibliografis. Penulis menelusuri melalui API ACL Anthology semua 205 artikel dari sembilan edisi ALW/WOAH dan tidak menemukan satu pun yang secara khusus membahas Urdu. Ini tidak berarti topiknya tidak pernah diteliti sama sekali — tetapi dalam korpus materi workshop utama tentang penilaian bahaya, topik ini tidak ada sebagai arah tersendiri. Jadilah lingkaran setan: tidak ada benchmark — tidak ada publikasi — tidak ada tekanan pada pengembang — lagi-lagi tidak ada benchmark.
Mengapa hal ini terjadi
Jawaban pastinya tidak ada dalam artikel, tetapi mekanismenya jelas dari pertimbangan umum. Nastaliq adalah tulisan kursif, di mana bentuk huruf bergantung pada posisinya dalam kata, sehingga tokenizer yang disetel untuk huruf Latin memotong teks semacam itu menjadi fragmen yang tidak menguntungkan. Data dalam bahasa Urdu di korpus pelatihan jauh lebih sedikit — beberapa orde besaran — dibandingkan bahasa Inggris. Anotasi untuk pembelajaran penguatan (termasuk untuk keamanan) juga sebagian besar dikumpulkan oleh penutur bahasa Inggris. Ditambah lagi ada kompromi yang nyaman: terjemahkan input ke bahasa Inggris, jalankan pemeriksaan, kembalikan jawabannya. Ini menghemat sumber daya, tetapi menambahkan perantara yang justru menimbulkan perbedaan.
Apa yang harus dilakukan tim produk
- Jangan mengandalkan terjemahan sebagai proksi. Jika filter mengambil keputusan berdasarkan versi bahasa Inggris, perbedaannya perlu diukur, bukan didiamkan.
- Jadikan perbedaan sebagai metrik. Berguna untuk secara rutin menghitung berapa banyak keputusan yang berubah saat aksara diganti: ini cara murah untuk menemukan titik buta tanpa anotasi baru.
- Uji pada tulisan aslinya. Nastaliq, romani, dan code-switching adalah tiga mode berbeda, dan hasil baik pada satu mode tidak menjamin apa pun pada dua mode lainnya.
- Jangan menyelaraskan ambang batas secara membabi buta. Meningkatkan sensitivitas pada satu aksara mudah berubah menjadi banjir positif palsu pada aksara lain.
- Pertimbangkan audiensnya. 246 juta penutur — ini bukan bahasa niche, melainkan bagian pengguna yang signifikan dari platform besar mana pun.
Kesimpulan yang hendak disampaikan penulis terdengar kering, tetapi tepat sasaran: jaminan keamanan saat ini terdistribusi secara tidak merata di antara aksara-aksara. Selama hal ini masih terjadi, «model telah lulus uji keamanan» adalah pernyataan yang selalu perlu diperjelas: dalam bahasa apa dan dengan huruf apa uji tersebut ditulis.


