
Aturan klinis alih-alih anotasi: metode baru melatih agen triase oftalmologi pada 3.000 dialog
Para penulis memperkenalkan pendekatan GAO: rekomendasi American Academy of Ophthalmology dikompilasi menjadi tabel berisi 70 aturan, yang menjadi satu-satunya sumber kontrol untuk pelatihan. Model 9B yang disempurnakan meningkatkan kesesuaian dengan standar acuan dari 61,7% menjadi 74,1%, dan pengenalan kasus yang tidak terduga dari 9,5% menjadi 69,0%, sementara penandaan manual hanya digunakan untuk evaluasi.
Mengapa anotasi biasa menghambat pelatihan agen medis
Agen dialog untuk triase oftalmologi tidak bisa hanya dilatih dengan kata-kata: perlu diperlihatkan ribuan contoh percakapan dengan jawaban yang benar. Dalam produk biasa, anotasi semacam itu dilakukan oleh manusia-annotator. Di klinik, segalanya lebih rumit: anotasi membutuhkan partisipasi dokter, biayanya mahal, dan transkrip percakapan dengan pasien dilindungi oleh kerahasiaan medis. Menyerahkannya ke kontraktor eksternal tidak diperbolehkan, sehingga hampir mustahil untuk menskalakan supervisi.
Penulis sebuah studi terbaru mengusulkan untuk meninggalkan model ini. Alih-alih mempekerjakan pakar dan memberi anotasi manual pada setiap ucapan, mereka menggunakan pedoman klinis itu sendiri sebagai sumber sinyal pelatihan. Dalam oftalmologi, aturan triase cukup ketat untuk disederhanakan menjadi operasi formal yang dapat memberi anotasi dialog secara otomatis. Pendekatan ini tidak hanya menekan biaya proses, tetapi juga memungkinkan data sensitif tetap berada di dalam lingkungan riset.
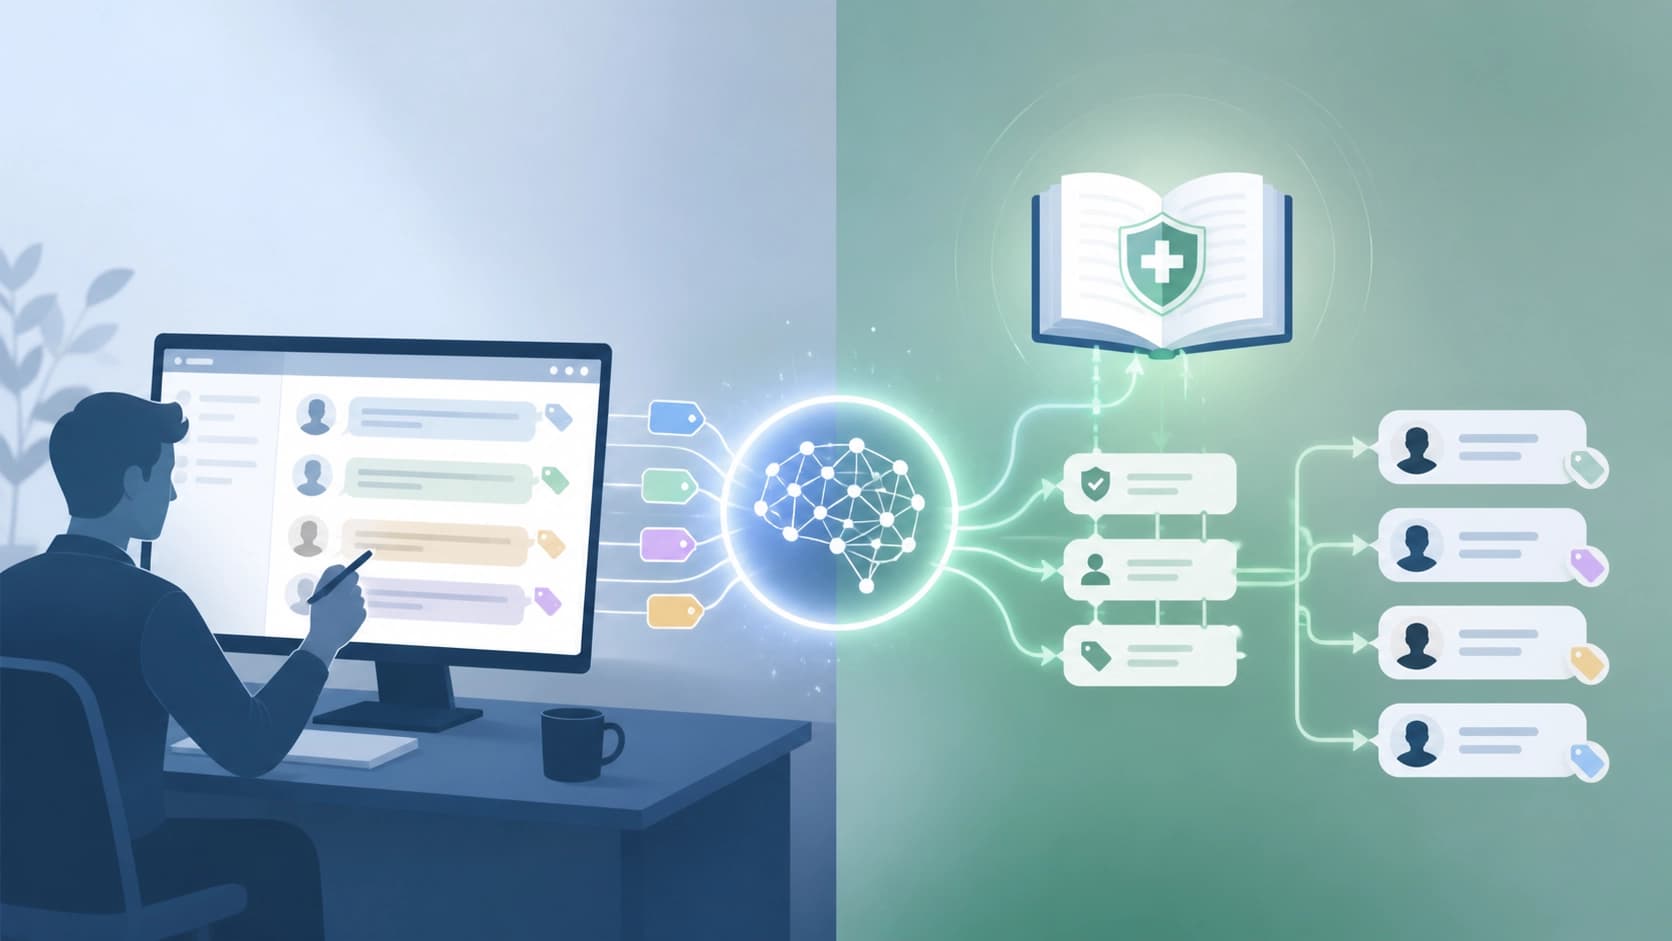
Metode Guideline-as-Oracle: pedoman menjadi "oracle"
Para peneliti mengambil rekomendasi American Academy of Ophthalmology dan menyusunnya menjadi tabel operasional berisi 70 baris. Setiap baris menjelaskan kondisi yang memungkinkan sebuah dialog diklasifikasikan ke kelas triase yang sesuai. Tabel ini berperan sebagai "oracle": tabel ini secara otomatis menetapkan label untuk 3.000 dialog pelatihan. Anotasi manusia hanya diperlukan untuk pemeriksaan akhir — digunakan sebagai tolok ukur pada set terpisah berisi 201 kasus klinis, tetapi tidak dalam proses pelatihan.
Penerjemahan teks klinis menjadi dialog itu sendiri adalah tugas rekayasa yang tidak sepele. Untuk membuatnya andal, para penulis mendeskripsikan delapan strategi konstruksi korpus. Di antaranya — penetapan tingkat berdasarkan baris pedoman yang relevan, pasangan batas "satu fakta berbeda", koreksi kesalahan hanya pada metadata, dan perbaikan label secara terpisah. Setiap strategi mereka karakterisasi dari sisi tingkat bukti: satu berfungsi sebagai mekanisme anotasi mandiri, yang lain tidak memberikan efek, yang ketiga tercampur dengan pengaruh faktor lain, dan yang keempat hanya dapat diuji dalam keseluruhan pipeline.
Pendekatan ini memecahkan masalah tidak hanya biaya, tetapi juga pembaruan: ketika pedoman klinis berubah, cukup memperbaiki tabel aturan, bukan memberi anotasi ulang ribuan dialog dari awal.
Eksperimen: keselarasan meningkat, recall melonjak
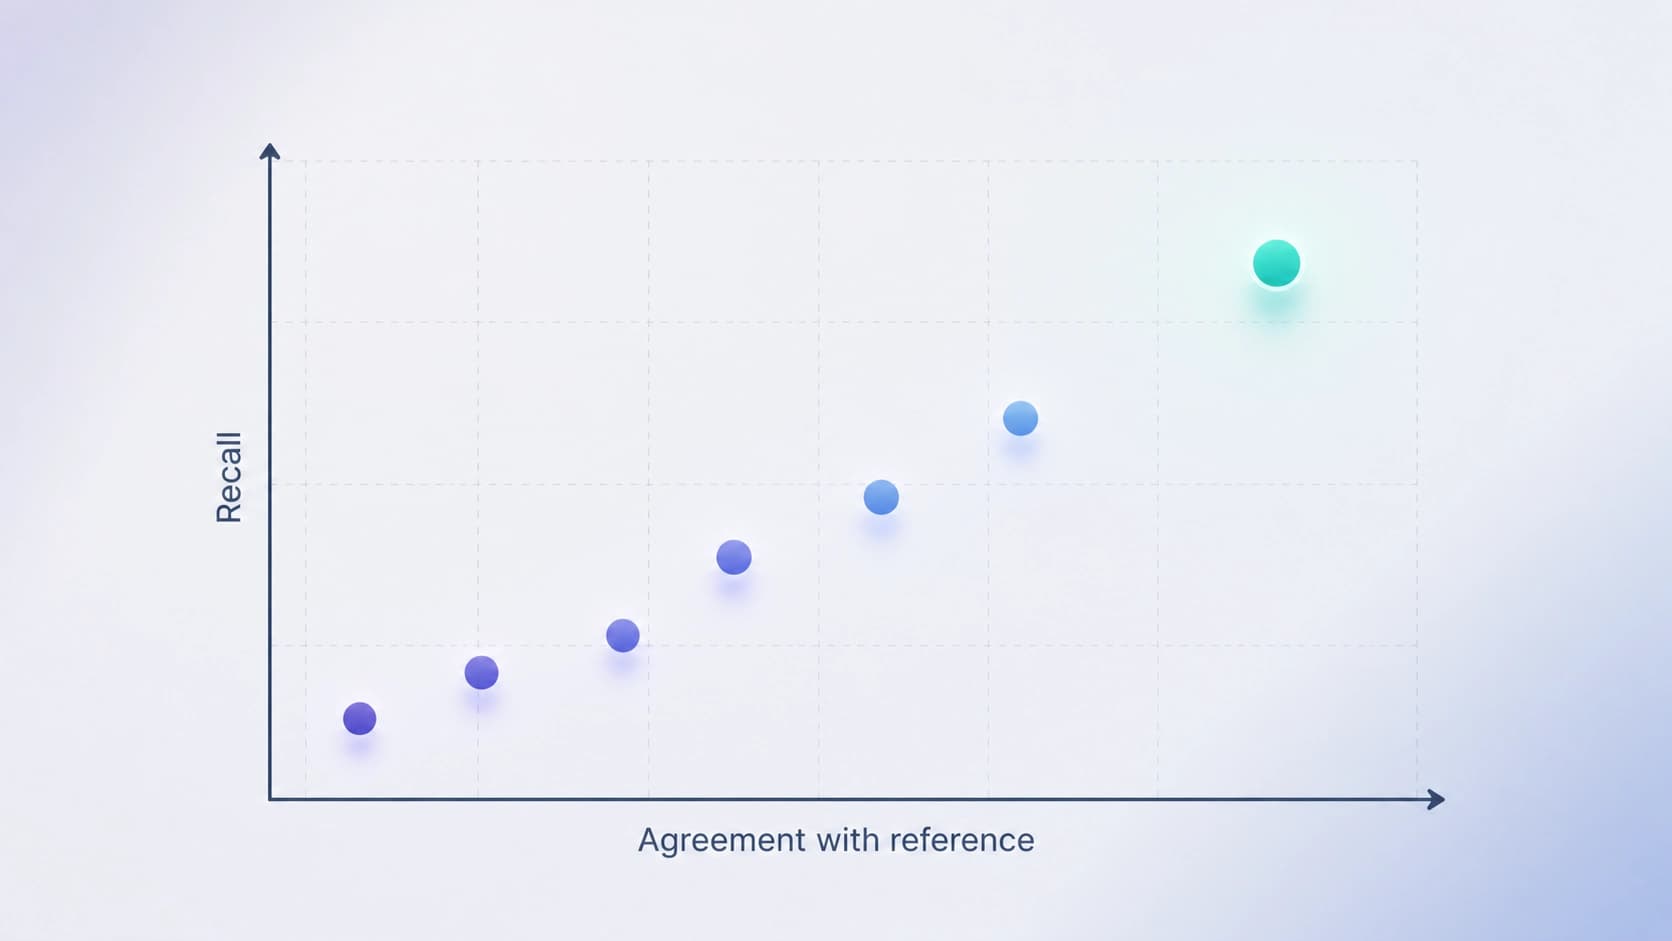
Dasar eksperimen adalah model dengan 9 miliar parameter. Setelah penyesuaian halus pada korpus 3.000 dialog beranotasi otomatis, dihasilkan agen yang dinamai GAO-Triage. Pada tolok ukur 201 kasus, keselarasan jawaban dengan keputusan yang diharapkan meningkat dari 61,7% menjadi 74,1%. Perubahan ini signifikan secara statistik: uji eksak McNemar menghasilkan p = 0,0046.
Peningkatan recall pada kasus tak terduga sangat mencolok. Ini merujuk pada situasi yang tidak sesuai dengan protokol standar — misalnya, ketika pasien menggambarkan gejala yang membutuhkan respons non-templat. Di sinilah agen biasanya paling sering membuat kesalahan. Pada GAO-Triage, metrik ini meningkat dari 9,5% menjadi 69,0%, artinya model menjadi jauh lebih jarang melewatkan skenario yang berpotensi berbahaya.
Peningkatan tersebut tidak terjadi secara kebetulan: peningkatan bertahan saat pelatihan ulang dengan seed berbeda dan pada simulator pasien. GAO-Triage dibandingkan dengan tujuh sistem dialog serbaguna. Tidak satu pun dari mereka yang mendominasi secara bersamaan pada kedua metrik: sebagian memiliki keselarasan lebih tinggi, sebagian lagi recall lebih tinggi, tetapi hanya GAO-Triage yang menggabungkan keduanya. Selain itu, pada tahap inferensi, agen tidak memerlukan model frontier terkuat dan dapat berjalan secara lokal pada basis dengan 9B parameter.
Rahasia kesuksesan — pada penetapan label, bukan pada teks
Para penulis melakukan eksperimen kontrol yang menjelaskan mengapa metode ini berhasil. Mereka mengambil 3.000 dialog yang sama, tetapi mengacak korespondensi antara dialog dan label yang ditetapkan oleh aturan. Setelah pengacakan ini, model sepenuhnya terdegradasi dan berubah menjadi prediktor rutin yang konstan: model mulai mengeluarkan jawaban standar yang sama, mengabaikan isi percakapan. Ini adalah hasil yang penting. Ini menunjukkan bahwa yang bermanfaat bukanlah bentuk permukaan dari ucapan, melainkan hubungan antara dialog tertentu dengan kelas yang diturunkan dari aturan klinis.
Secara terpisah, para peneliti melacak strategi label repair — perbaikan label pada tahap akhir pelatihan. Penerapannya bertepatan dengan hilangnya degradasi keamanan. Tampaknya, ketika anotasi mulai dibersihkan secara cermat menjelang akhir pelatihan, model berhenti tergelincir ke jawaban yang tidak aman yang dapat muncul karena kesalahan awal dalam data.
Apa artinya ini untuk praktik
Kesimpulan utama dari studi ini: di bidang dengan pedoman klinis yang matang, agen dialog dapat dilatih hampir tanpa anotasi manual. Cukup menerjemahkan rekomendasi menjadi aturan yang dapat dieksekusi satu kali, lalu menggunakannya sebagai supervisor. Sampel pakar kecil tetap diperlukan — untuk evaluasi kualitas akhir — tetapi ukurannya tidak sebanding dengan anotasi penuh pada korpus pelatihan.
Pendekatan ini tidak terbatas pada oftalmologi. Jika protokol serupa ada di kardiologi, gawat darurat, atau telemedis, skema ini dapat diadaptasi di sana juga. Tantangan teknis utama tetap sama: pedoman klinis harus diterjemahkan menjadi aturan yang tidak ambigu secara cermat dan dengan pemahaman domain yang mendalam. Tetapi begitu ini selesai, pelatihan agen medis yang aman menjadi jauh lebih cepat dan murah, dan data pasien yang sensitif tetap berada di bawah kendali pengembang.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan
Invarian polinomial kanonik dalam diagnostik kegagalan simulator RL: di mana sebenarnya berguna?
Studi ini menguji apakah menyertakan hukum fisika dalam model dinamika yang dapat dilatih memang sepadan: invarian yang diekstrak dari lintasan dan diubah ke bentuk kanonis melalui basis Gröbner hanya sedikit meningkatkan prediksi, tetapi sangat berguna untuk diagnosis—invarian ini dapat membantu menemukan kendala yang dilanggar dan mengidentifikasi parameter spesifik yang keliru.
10 November 2026
AURA-Eval: cara memeriksa apakah agen LLM mengenali risiko dan mengubah langkah berikutnya
Framework ini mengevaluasi perilaku agen LLM bukan berdasarkan keputusan akhir, melainkan respons terhadap risiko di titik-titik penting: rangkaian pemanggilan alat dihentikan, lalu model harus melanjutkan penalaran dan tindakan, sementara panel juri LLM menilai deteksi risiko, karakter, dan keamanan langkah tersebut. Dalam 1.249 tugas yang dikumpulkan dari 157 rangkaian R-Judge, 20 model lebih sering melakukan tindakan tidak aman saat jalur aman tidak tersedia, dan penghapusan pengawasan sebelum eksekusi mengubah 52,3% kasus yang semula aman menjadi tidak aman.
10 November 2026
Memori reservoir Chern–Simons: dinamika konektivitas mandiri dan transfer densitas
Artikel ini membahas bagaimana reservoir menyimpan riwayat sinyal masukan secara bersamaan dalam distribusi densitas dan derajat kebebasan geometris. Perbandingan empat mekanisme menunjukkan bahwa arus menciptakan komponen keterhubungan tersendiri yang mengubah respons densitas berikutnya, sementara penggunaan semua fitur yang terukur memberikan sedikit peningkatan dalam dekode urutan pulsa.
10 November 2026