
DiSCO: perlindungan konten text-to-image dari konten berbahaya tanpa akses ke bagian dalam model
Metode baru DiSCO bekerja sebagai modul eksternal: ia memilih prompt yang aman dan mengurangi tingkat serangan red-team yang berhasil sebesar 37,7% untuk model yang tidak terlindungi dan 25,13% untuk sistem yang sudah terlindungi. Sementara itu, akurasi semantik tetap terjaga, dan koherensi gambar bahkan meningkat.
Ancaman Tersembunyi di Balik Prompt yang Tampak Polos
Jaringan saraf modern yang menghasilkan gambar berdasarkan deskripsi teks mampu menciptakan gambar yang mengesankan, tetapi terkadang "memunculkan" konten yang tidak diinginkan. Biasanya, perlindungan sistem semacam itu dibangun dengan mengintervensi struktur internalnya: melatih ulang encoder teks, menyesuaikan bobot, atau pemrosesan khusus pada tahap inferensi. Pendekatan ini efektif selama Anda memiliki akses ke model itu sendiri, namun sama sekali tidak cocok untuk layanan proprietary tertutup yang beroperasi dengan prinsip "kotak hitam".
Sebagai alternatif, model bahasa besar digunakan untuk menulis ulang permintaan secara otomatis menjadi bentuk yang aman. Tetapi di sini pun ada kelemahannya: prompt yang dihasilkan secara linguistik benar-benar tidak berbahaya, namun karena cara model mendistribusikan data selama pelatihan, generasi tetap mengarah ke area yang berbahaya. Para penulis menyebut mode ini sebagai "benign adversarial" — ketika teks secara formal aman, tetapi hasilnya tidak.
Apa yang Ditawarkan DiSCO
Metode DiSCO (Distribution-guided contrastive prompt optimization), yang dikembangkan oleh sekelompok peneliti, menawarkan pendekatan yang sama sekali berbeda: melindungi generasi pada tingkat prompt tanpa melihat ke dalam model. Ini adalah solusi black-box murni yang bekerja sebagai modul plug-and-play eksternal. Metode ini tidak memerlukan fine-tuning, pelatihan ulang, atau informasi apa pun tentang parameter dan arsitektur sistem target.
Idenya adalah memodifikasi sufiks secara otomatis — yaitu bagian akhir dari prompt — sedemikian rupa untuk mengarahkan generasi ke jalur yang aman. Pencarian sufiks yang sesuai dilakukan dengan beam search, dan kualitas kandidat dievaluasi dengan contrastive scoring. Untuk ini, modul terlebih dahulu menghasilkan dua kumpulan gambar menggunakan model target itu sendiri: gambar aman dan tidak aman. Dengan membandingkan hasil generasi dengan kumpulan referensi, DiSCO memahami ke arah mana sufiks harus "ditekan".
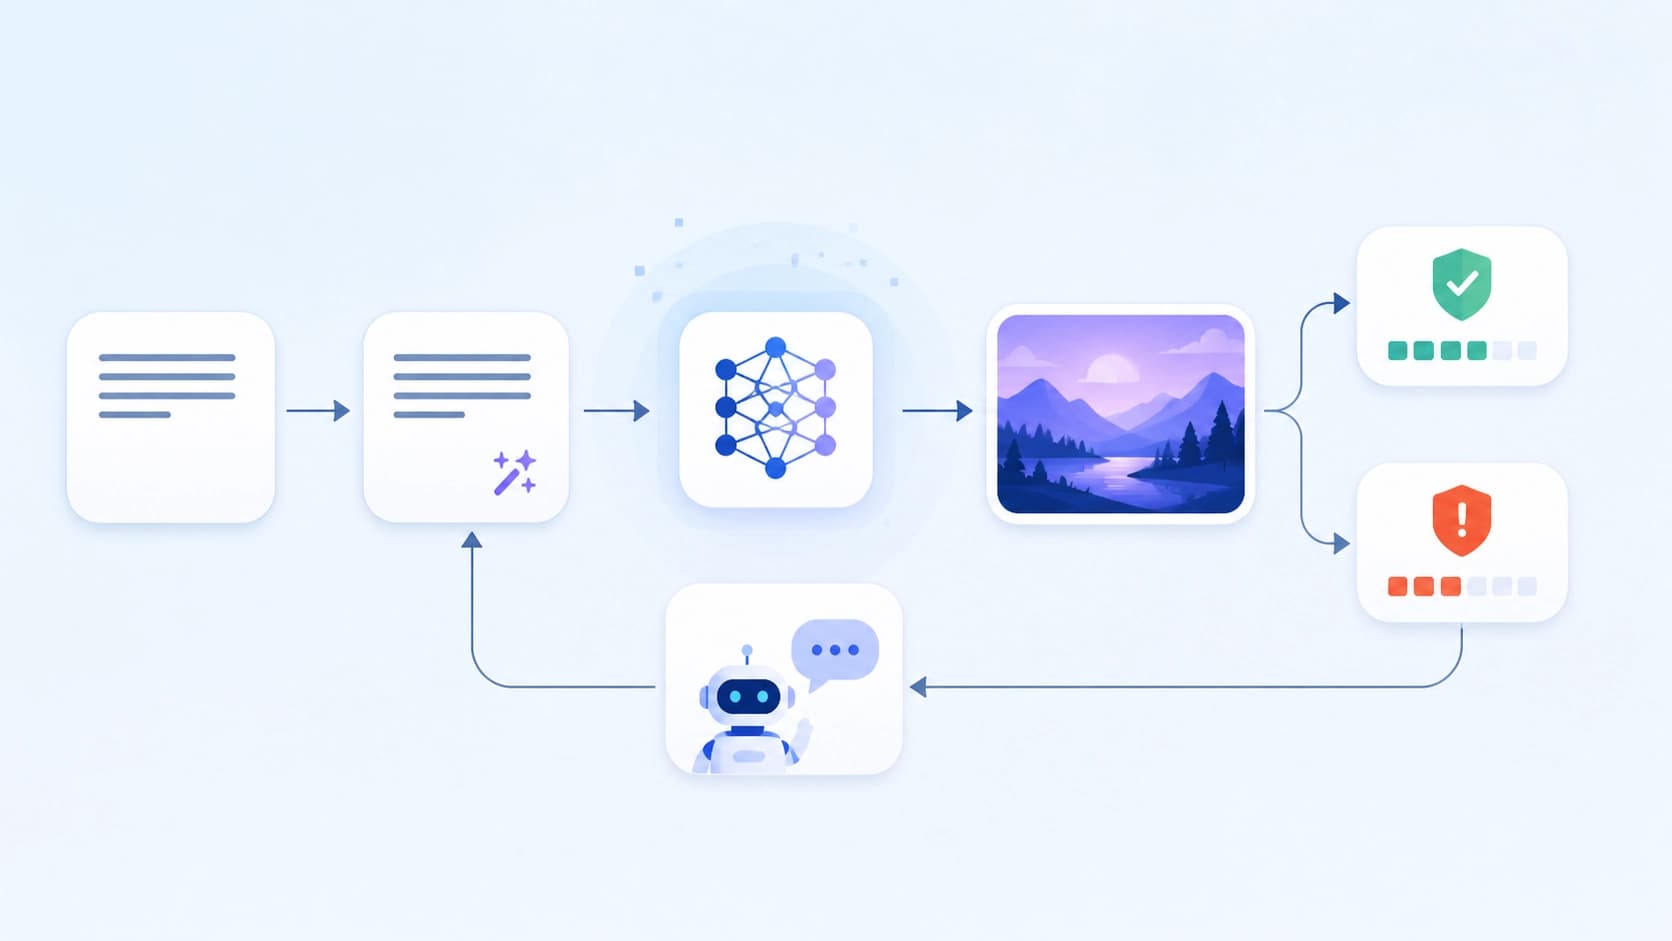
Prosesnya iteratif: setelah setiap langkah, modul mengevaluasi gambar yang dihasilkan dan, jika masih mengandung elemen yang tidak diinginkan, menyesuaikan sufiks kembali. Ini berlanjut hingga generasi sesuai dengan kumpulan aman. Tidak ada satu pun tahap yang mengharuskan pengungkapan internal model — semua interaksi hanya melalui pengiriman prompt dan penerimaan gambar.
Seberapa Efektif Ini
Para peneliti menguji DiSCO pada benchmark I2P (Inappropriate Image Prompts) dalam skenario serangan red-teaming ganda. Hasilnya menunjukkan bahwa tingkat serangan yang berhasil turun sebesar 37,7% untuk model tanpa perlindungan apa pun dan 25,13% untuk model yang sudah dilindungi oleh metode lain. Ini berarti DiSCO tidak hanya menutup celah di tempat yang tidak ada perlindungannya, tetapi juga memperkuat penghalang yang sudah ada.
Yang penting, akurasi semantik tidak terganggu: gambar yang dihasilkan tetap relevan dengan prompt asli, dan koherensi bahkan meningkat. Dengan kata lain, modul ini tidak merusak kualitas generasi, melainkan hanya menjauhkannya dari interpretasi yang berpotensi berbahaya.
Karena DiSCO bersifat agnostik terhadap arsitektur, modul ini dapat dihubungkan ke sistem text-to-image apa pun tanpa mengubah model itu sendiri. Ini sangat berharga untuk API komersial tertutup yang aksesnya terbatas, dan bagi pengguna yang ingin meningkatkan keamanan layanan pihak lain — misalnya, sebelum digunakan dalam aplikasi publik.
Meskipun hasilnya mengesankan, perlu diingat bahwa metode ini bukanlah "peluru perak", melainkan salah satu lapisan perlindungan. Menghilangkan risiko sepenuhnya mungkin sulit dilakukan, tetapi menggeser pendekatan dari keamanan "internal" ke "eksternal" dan adaptif adalah langkah penting menuju ketahanan sistem generatif terhadap permintaan berbahaya.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan
Memori reservoir Chern–Simons: dinamika konektivitas mandiri dan transfer densitas
Artikel ini membahas bagaimana reservoir menyimpan riwayat sinyal masukan secara bersamaan dalam distribusi densitas dan derajat kebebasan geometris. Perbandingan empat mekanisme menunjukkan bahwa arus menciptakan komponen keterhubungan tersendiri yang mengubah respons densitas berikutnya, sementara penggunaan semua fitur yang terukur memberikan sedikit peningkatan dalam dekode urutan pulsa.
10 November 2026
STAR: normalisasi adaptif konteks temporal dan graf layanan untuk manajemen insiden end-to-end
Framework STAR mempelajari representasi dari metrik, log, dan trace dengan menerapkan normalisasi yang dapat dilatih, yang memperhitungkan dinamika temporal multiskala dan struktur dependensi antarservice. Pada dua dataset dunia nyata, pendekatan ini secara konsisten meningkatkan kualitas deteksi anomali, pemeringkatan kegagalan, dan penelusuran akar penyebab dibandingkan metode baseline mutakhir.
10 November 2026
Verifikasi kandidat lebih mahal daripada generasinya: honeypot untuk melawan pencarian kerentanan berbasis LLM
Karya ini mengulas asimetri biaya dalam pencarian bug oleh agen: menghasilkan kandidat itu murah, sedangkan mengonfirmasinya melalui analisis keterjangkauan, eksekusi, dan PoC membutuhkan sebagian besar anggaran, sehingga verifikasi dapat dijadikan sasaran pertahanan tersendiri. RedHerring yang diusulkan—umpan yang disesuaikan dengan repositori dan dilengkapi sertifikat tertutup—mengurangi jumlah kerentanan nyata yang ditemukan sebesar 38,7–60,4% dengan biaya yang sama di 33 proyek OSS-Fuzz; bahkan setelah agen diperingatkan, penurunannya tetap mencapai 37,2%.
9 November 2026