
CaLR: Optimisasi laten dengan kendala kausal untuk inferensi stabil pada model difusi
Karya ini memperkenalkan CaLR—pendekatan yang merumuskan penalaran sebagai optimisasi berkendala dalam ruang laten; strukturnya bersumber dari matriks topologi kausal yang berasal dari model ahli, sedangkan pelatihannya mengandalkan diferensiasi implisit. Metode ini meningkatkan konsistensi dan memungkinkan hasil antara dikoreksi selama proses generasi paralel, sehingga menghasilkan kinerja yang lebih baik pada kumpulan data yang kompleks dan tugas dengan kendala ketat, termasuk sudoku.
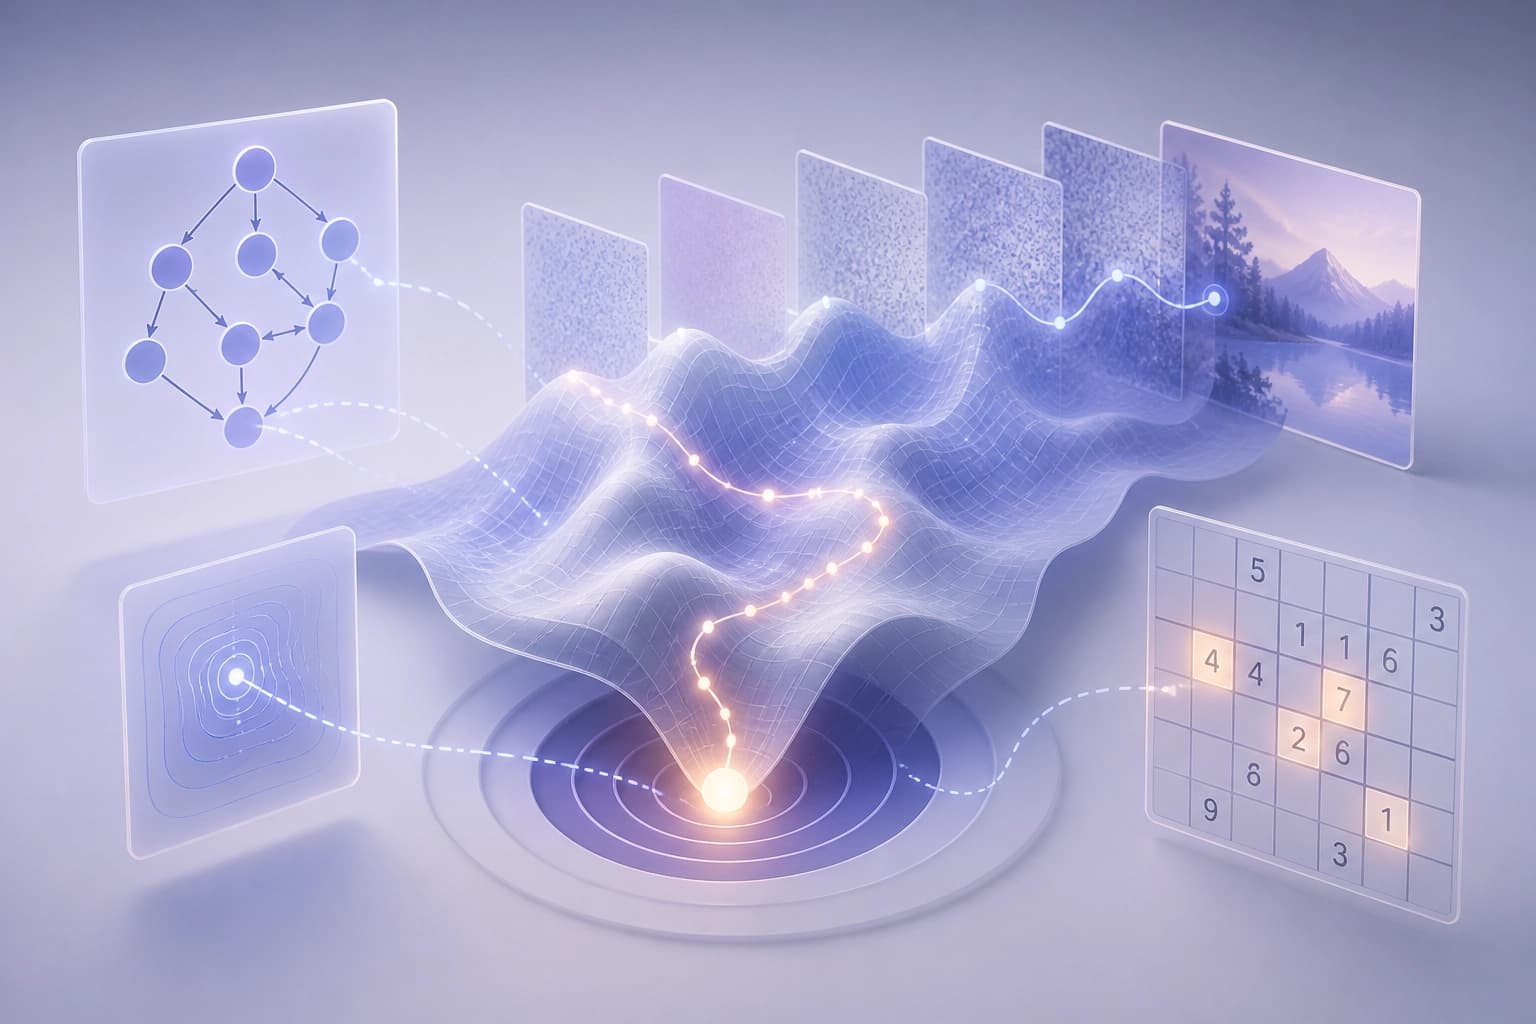
Masalah: keserakahan lokal AR dan kausalitas DLM yang lemah
Model autoregresif mengalami keserakahan lokal. Model bahasa difusi sering kali tidak memiliki struktur kausal yang ketat untuk penalaran.
| Jenis model | Keterbatasan |
|---|---|
| AR | Keserakahan lokal |
| DLM | Kurangnya struktur kausal yang ketat untuk penalaran |
Kesimpulan: penalaran membutuhkan mekanisme yang menghubungkan generasi dengan batasan kausal. Kriteria praktis: periksa bagaimana model mempertahankan struktur logis pada langkah-langkah perantara.
Kerangka kerja dan tujuannya
CaLR adalah kerangka kerja untuk inferensi model difusi yang tangguh. Kerangka ini merumuskan penalaran sebagai optimisasi laten terkendala. Nama lengkapnya: «CaLR: Causal Latent Revision for Robust Diffusion Reasoning». Penulis: Wei Cai, Jian Zhao, Yuchen Yuan, Xuelong Li. Tanggal pengajuan: 17 Sep 2026.
Kesimpulan: CaLR menghubungkan inferensi yang tangguh dengan optimisasi representasi laten. Kriteria praktis: pilih metode ini jika tugas membutuhkan struktur kausal dalam penalaran.
Komponen pendekatan
CaLR menggunakan tiga elemen. Pertama — causal topology matrix (CTM). Matriks ini diperoleh dari model ahli. Kedua — diferensiasi implisit. Ketiga — «revisi pemikiran» yang diarahkan oleh gradien.
Causal topology matrix (CTM)
CTM adalah matriks topologis kausal. Sumbernya adalah model ahli.
Diferensiasi implisit
CaLR menggunakan diferensiasi implisit.
«Revisi pemikiran» yang diarahkan oleh gradien
Operasi ini ditujukan untuk memastikan konsistensi logis. Operasi ini juga ditujukan untuk mengoreksi sendiri langkah-langkah perantara secara dinamis selama generasi paralel.
Kesimpulan: CTM menyediakan struktur kausal, diferensiasi implisit menjadi bagian dari optimisasi, dan revisi pemikiran memperbaiki langkah-langkah. Kriteria praktis: periksa ketersediaan sumber struktur kausal dan mekanisme koreksi.
Hasil yang diklaim
CaLR mencapai performa DLM SOTA pada tolok ukur yang sulit. Kerangka kerja ini mengungguli baseline AR yang kuat. Kerangka ini menunjukkan ketangguhan yang lebih tinggi dalam tugas dengan batasan, seperti Sudoku.
| Properti | Hasil |
|---|---|
| Performa DLM | SOTA pada tolok ukur yang sulit |
| Perbandingan dengan AR | Mengungguli baseline AR yang kuat |
| Ketangguhan | Ketangguhan yang lebih tinggi dalam tugas dengan batasan, misalnya Sudoku |
Kesimpulan: keunggulan yang diklaim berkaitan dengan tolok ukur yang sulit dan tugas dengan batasan. Kriteria praktis: sesuaikan kebutuhan tugas dengan ketangguhan dalam tugas dengan batasan. Untuk skenario lain, tidak ada informasi dalam abstrak.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan
Invarian polinomial kanonik dalam diagnostik kegagalan simulator RL: di mana sebenarnya berguna?
Studi ini menguji apakah menyertakan hukum fisika dalam model dinamika yang dapat dilatih memang sepadan: invarian yang diekstrak dari lintasan dan diubah ke bentuk kanonis melalui basis Gröbner hanya sedikit meningkatkan prediksi, tetapi sangat berguna untuk diagnosis—invarian ini dapat membantu menemukan kendala yang dilanggar dan mengidentifikasi parameter spesifik yang keliru.
10 November 2026
AURA-Eval: cara memeriksa apakah agen LLM mengenali risiko dan mengubah langkah berikutnya
Framework ini mengevaluasi perilaku agen LLM bukan berdasarkan keputusan akhir, melainkan respons terhadap risiko di titik-titik penting: rangkaian pemanggilan alat dihentikan, lalu model harus melanjutkan penalaran dan tindakan, sementara panel juri LLM menilai deteksi risiko, karakter, dan keamanan langkah tersebut. Dalam 1.249 tugas yang dikumpulkan dari 157 rangkaian R-Judge, 20 model lebih sering melakukan tindakan tidak aman saat jalur aman tidak tersedia, dan penghapusan pengawasan sebelum eksekusi mengubah 52,3% kasus yang semula aman menjadi tidak aman.
10 November 2026
Memori reservoir Chern–Simons: dinamika konektivitas mandiri dan transfer densitas
Artikel ini membahas bagaimana reservoir menyimpan riwayat sinyal masukan secara bersamaan dalam distribusi densitas dan derajat kebebasan geometris. Perbandingan empat mekanisme menunjukkan bahwa arus menciptakan komponen keterhubungan tersendiri yang mengubah respons densitas berikutnya, sementara penggunaan semua fitur yang terukur memberikan sedikit peningkatan dalam dekode urutan pulsa.
10 November 2026