Kota sebagai domain tersendiri
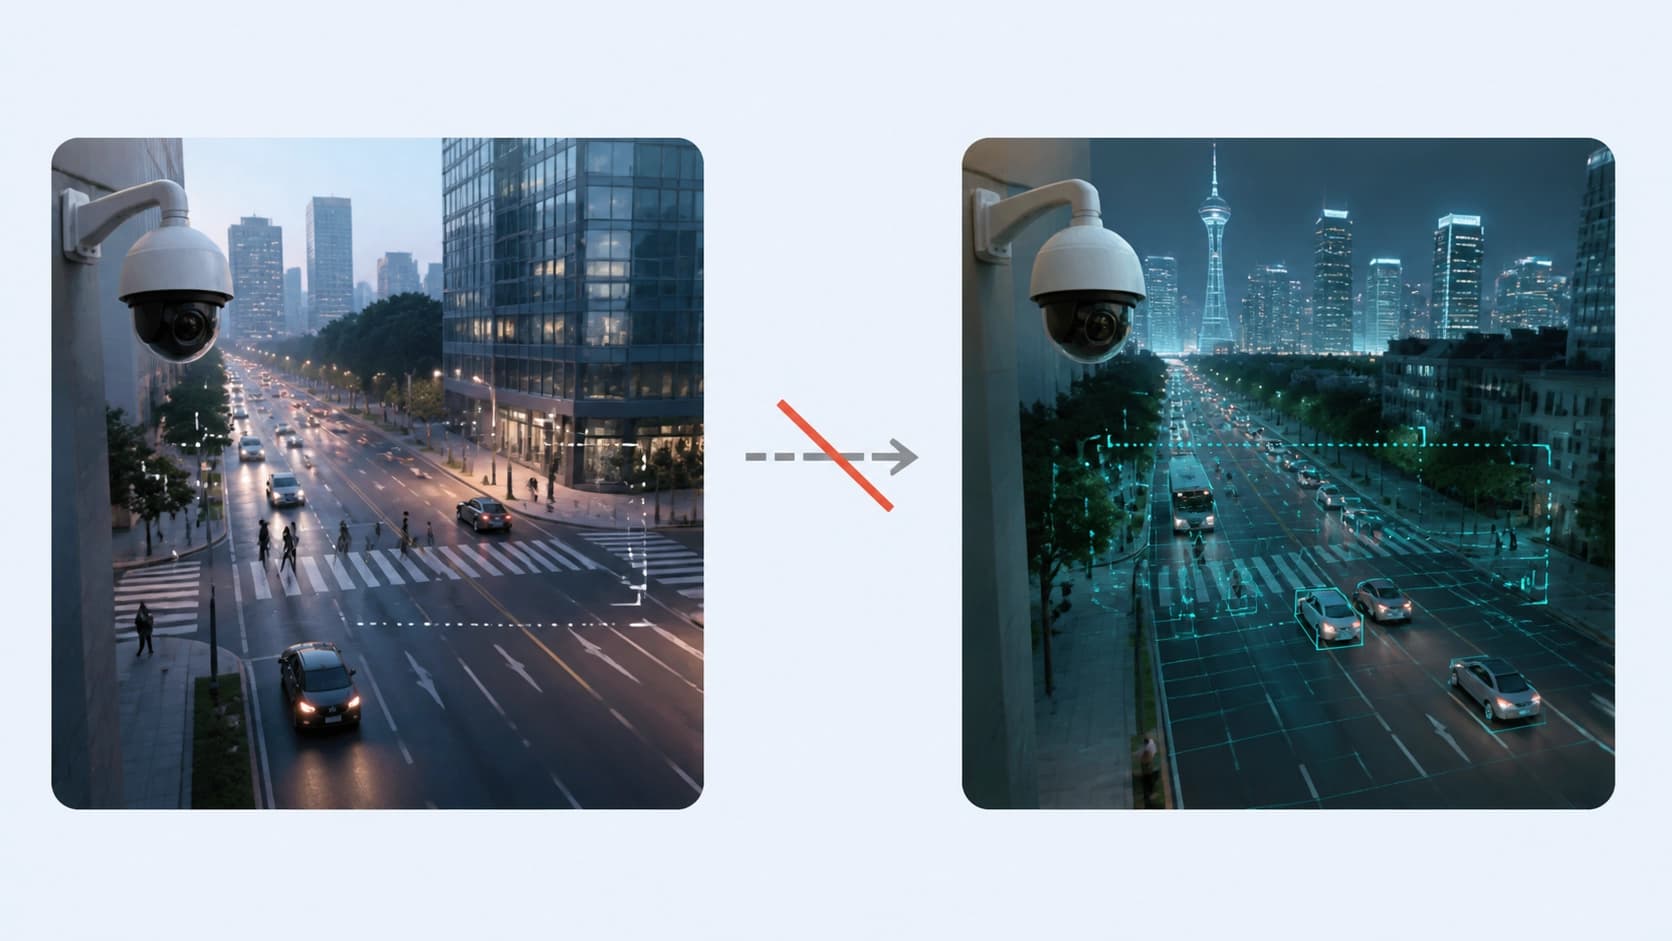
Detektor mobil, lampu lalu lintas, dan pejalan kaki yang dilatih pada rekaman kamera satu kota, saat dipindahkan ke kota lain, kehilangan akurasi secara signifikan dan dapat diprediksi. Penyebabnya bukan pada model itu sendiri, melainkan karena hampir semuanya berubah sekaligus: pencahayaan dan white balance kamera, kepadatan arus, marka jalan, warna bodi kendaraan yang umum, dan bahkan tampilan model transportasi tipikal. Secara formal ini disebut pergeseran domain geografis, dan dalam praktiknya — sakit kepala rutin bagi mereka yang menerapkan sistem pengawasan lalu lintas di beberapa wilayah sekaligus.
Solusi klasiknya adalah adaptasi domain. Namun ada sifat yang tidak menyenangkan: hampir selalu memerlukan要么 penyetelan arsitektur yang rapuh terhadap perubahan hyperparameter,要么 akses langsung ke data kota target — pembuatan profilnya, penyetelan ambang batas berdasarkan data tersebut, analisis statistik. Dan di sinilah muncul batasan yang sama sekali bukan bersifat teknis.
Apa arti siklus pelatihan "buta"
Dalam ekosistem di mana data diperlakukan sebagai informasi sensitif, kedua jalur yang biasa tersebut tertutup secara definisi. Tidak boleh mengunggah frame dari kota target ke lingkungan penelitian, tidak boleh membangun statistik darinya, tidak boleh menyetel model berdasarkan data tersebut. Yang tersisa adalah mode sepenuhnya "buta": pelatihan dan evaluasi berjalan tanpa satu pun contoh target, dan verifikasi kualitas hanya mungkin dilakukan di tempat anotasi sudah ada dan tidak pernah meninggalkan lingkaran terlindungi.
Justru dalam kerangka inilah para penulis karya baru ini menempatkan tugas mereka. Mereka tidak tertarik pada lapisan adaptasi licik lainnya, melainkan pada pertanyaan yang lebih sederhana dan lebih menarik: seberapa banyak yang bisa diperas dari apa yang sudah ada — dari pra-pelatihan dan augmentasi — jika menolak segala manipulasi terhadap data target.
Dua pilar ortogonal
Skema pelatihan yang diusulkan untuk deteksi objek dibangun di atas dua mekanisme independen. Kata "ortogonal" di sini adalah kuncinya: keduanya tidak saling menduplikasi dan menekan sumber kesalahan yang berbeda — satu bekerja dengan semantik dan struktur objek, yang kedua dengan apa yang menjadi pijakan perhatian model.
Pra-pelatihan pada beberapa dataset dengan objectness distillation
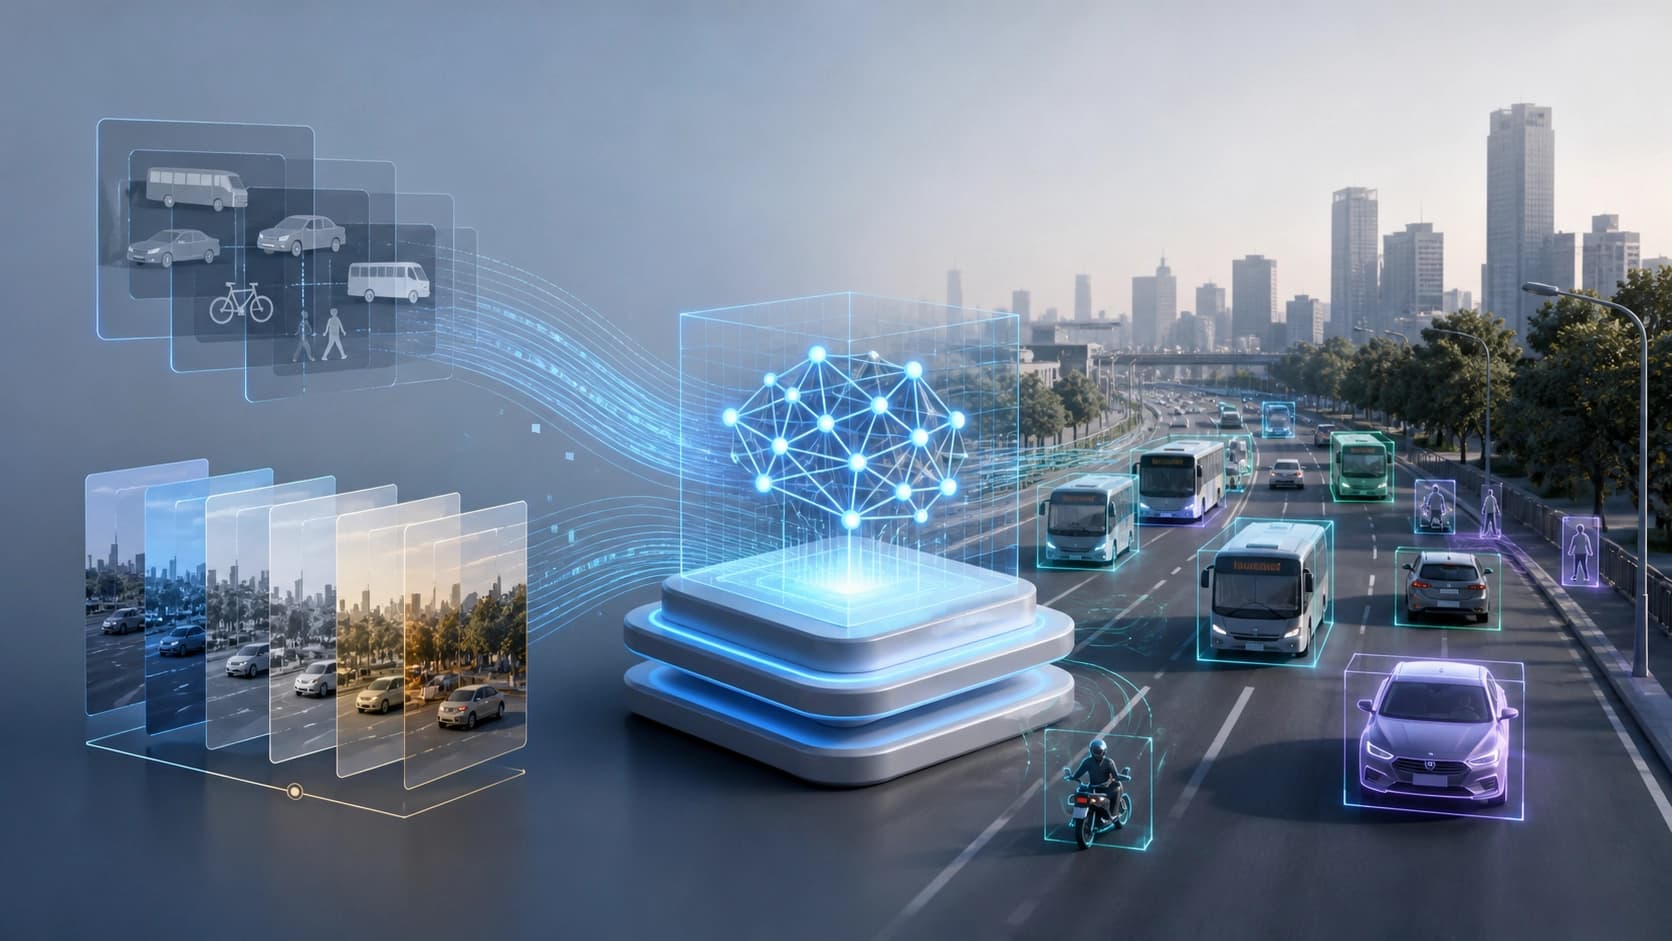
Pilar pertama adalah strategi pra-pelatihan pada beberapa kumpulan data sekaligus dengan apa yang disebut class-agnostic objectness distillation. Idenya adalah memisahkan dua hal yang dalam pelatihan biasa saling melekat: geometri struktural kendaraan dan taksonomi semantik.
Sederhananya, model terlebih dahulu belajar menjawab pertanyaan "apakah ada objek dengan bentuk khas di sini?", tanpa mempedulikan bagaimana objek itu dinamai dalam dataset tertentu. Ini penting karena taksonomi antar kumpulan data dan antar kota berbeda-beda: di suatu tempat ada kelas terpisah untuk van, di tempat lain semuanya digabung menjadi "vehicle", dan batas antara kendaraan penumpang dan barang ditetapkan secara berbeda. Jika model bersandar pada geometri yang stabil, bukan pada konvensi label lokal, perubahan kota berdampak lebih lemah padanya.
Grayworld: memaksa attention melepaskan warna
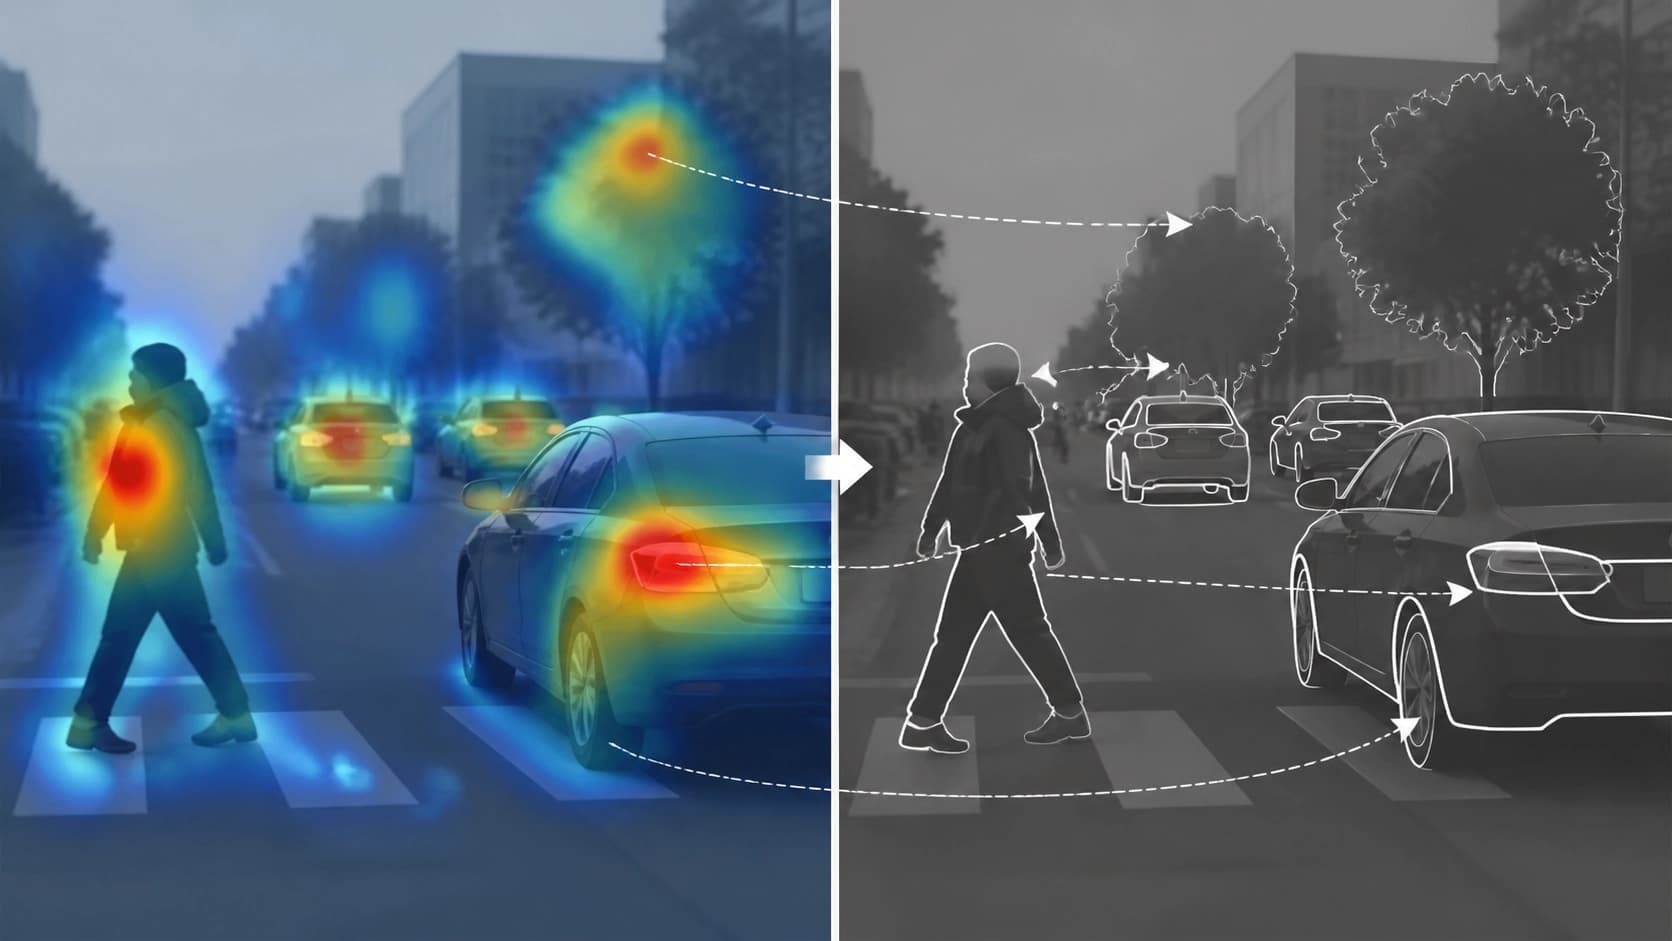
Pilar kedua adalah aliran augmentasi yang tahan domain, di mana ditambahkan transformasi baru bernama Grayworld. Tugasnya adalah mencabut pijakan model di tempat ia terbiasa curang.
Detektor sering menemukan "jalur pintas": mengaitkan kelas objek dengan warna. Mobil kuning — taksi, siluet merah — jenis transportasi tertentu, nuansa langit atau aspal yang spesifik — penanda kamera atau waktu tertentu. Di dalam satu kota, petunjuk semacam itu berfungsi, tetapi saat dipindahkan ke wilayah lain akan berantakan, karena reproduksi warna, cahaya, dan warna yang umum di sana berbeda. Grayworld menekan justru label kromatik ini, memaksa kepala attention global bersandar pada representasi bentuk yang stabil. Warna berhenti menjadi bukti, geometri — tetap ada.
Eksperimen dan hasil
Evaluasi dilakukan pada detektor transformer real-time RF-DETR. Para penulis secara khusus menekankan bahwa seluruh konstruksi masuk dalam anggaran memori GPU yang sederhana — 16 GB, artinya dapat direproduksi pada workstation biasa, bukan hanya pada klaster.
Varian yang dioptimalkan RF-DETR-HR dan RF-DETR-Grayworld memberikan peningkatan +24.29 terhadap tingkat dasar dan meraih peringkat pertama dalam papan peringkat AI City Challenge Track 6 dengan skor 47.53 mAP. Ini bukan lagi "sedikit lebih baik dari baseline" — ini perbedaan antara detektor yang hampir tidak berguna di kota baru dan yang berfungsi di sana.
Karya ini diterima di workshop AI City Challenge dalam rangka konferensi ECCV 2026; pracetak tersedia sebagai arXiv:2608.24154 (cs.CV, cs.AI), dan kode serta data tersedia di repositori SKKUAutoLab/aic26_cross_city.
Apa yang perlu diambil praktisi dari ini
Beberapa kesimpulan yang berguna di luar benchmark tertentu.
- Augmentasi bukan sekadar kosmetik. Ia mampu secara sengaja mematahkan korelasi yang tidak diinginkan, jika memahami apa yang sebenarnya menjadi pijakan model. Grayworld adalah contoh alat yang sempit namun tepat melawan jalur pintas warna.
- Pra-pelatihan dapat dirancang untuk transfer. Objectness class-agnostic dan pemisahan geometri dari taksonomi adalah teknik yang berguna di mana pun kelas dalam dataset dijelaskan secara berbeda.
- Protokol "buta" adalah pengaturan yang jujur, bukan batasan. Jika metode tidak mengintip data target, hasilnya menunjukkan ketahanan nyata, bukan kualitas penyesuaian.
- Anggaran memori adalah bagian dari hasil. Persyaratan 16 GB membuat pendekatan ini dapat diterapkan dalam praktik rekayasa, di mana perangkat keras terbaik tidak selalu tersedia.
Kewaspadaan juga tetap pantas: kesimpulan diperoleh pada satu keluarga detektor dan satu trek kompetisi, dan Grayworld — bagaimanapun juga adalah heuristik, bukan jaminan. Pergeseran geografis tetap menjadi masalah yang tidak memiliki satu solusi universal, tetapi kini jelas bahwa sebagian besar kemajuan dicapai bahkan sebelum model pertama kali melihat kota baru.