
AI menjelaskan penilaiannya terhadap keterampilan ahli bedah berdasarkan video operasi katarak
Para peneliti menciptakan platform yang secara otomatis menilai keterampilan ahli bedah berdasarkan rekaman video operasi. Sistem yang diuji pada 83 video ini menunjukkan kecocokan hingga 87% dengan para ahli dan membuat kesimpulannya transparan.
Masalah Penilaian Subjektif Keterampilan Bedah
Pelatihan ahli bedah mata tidak mungkin dilakukan tanpa umpan balik dari mentor berpengalaman. Namun, penilaian tradisional terhadap kemahiran berdasarkan video operasi masih sangat subjektif: dua ahli dapat menafsirkan gerakan instrumen yang sama secara berbeda. Hal ini memperlambat persiapan spesialis dan menciptakan risiko kesalahan dalam sertifikasi.
Sistem otomatis yang sebelumnya mencoba memecahkan masalah ini sering kali bekerja seperti "kotak hitam": sistem tersebut memberikan skor akhir, tetapi tidak menjelaskan gerakan apa yang menjadi dasar penilaian tersebut. Untuk pelatihan, jawaban seperti ini tidak berguna — ahli bedah muda tidak memahami apa yang sebenarnya perlu diperbaikinya.
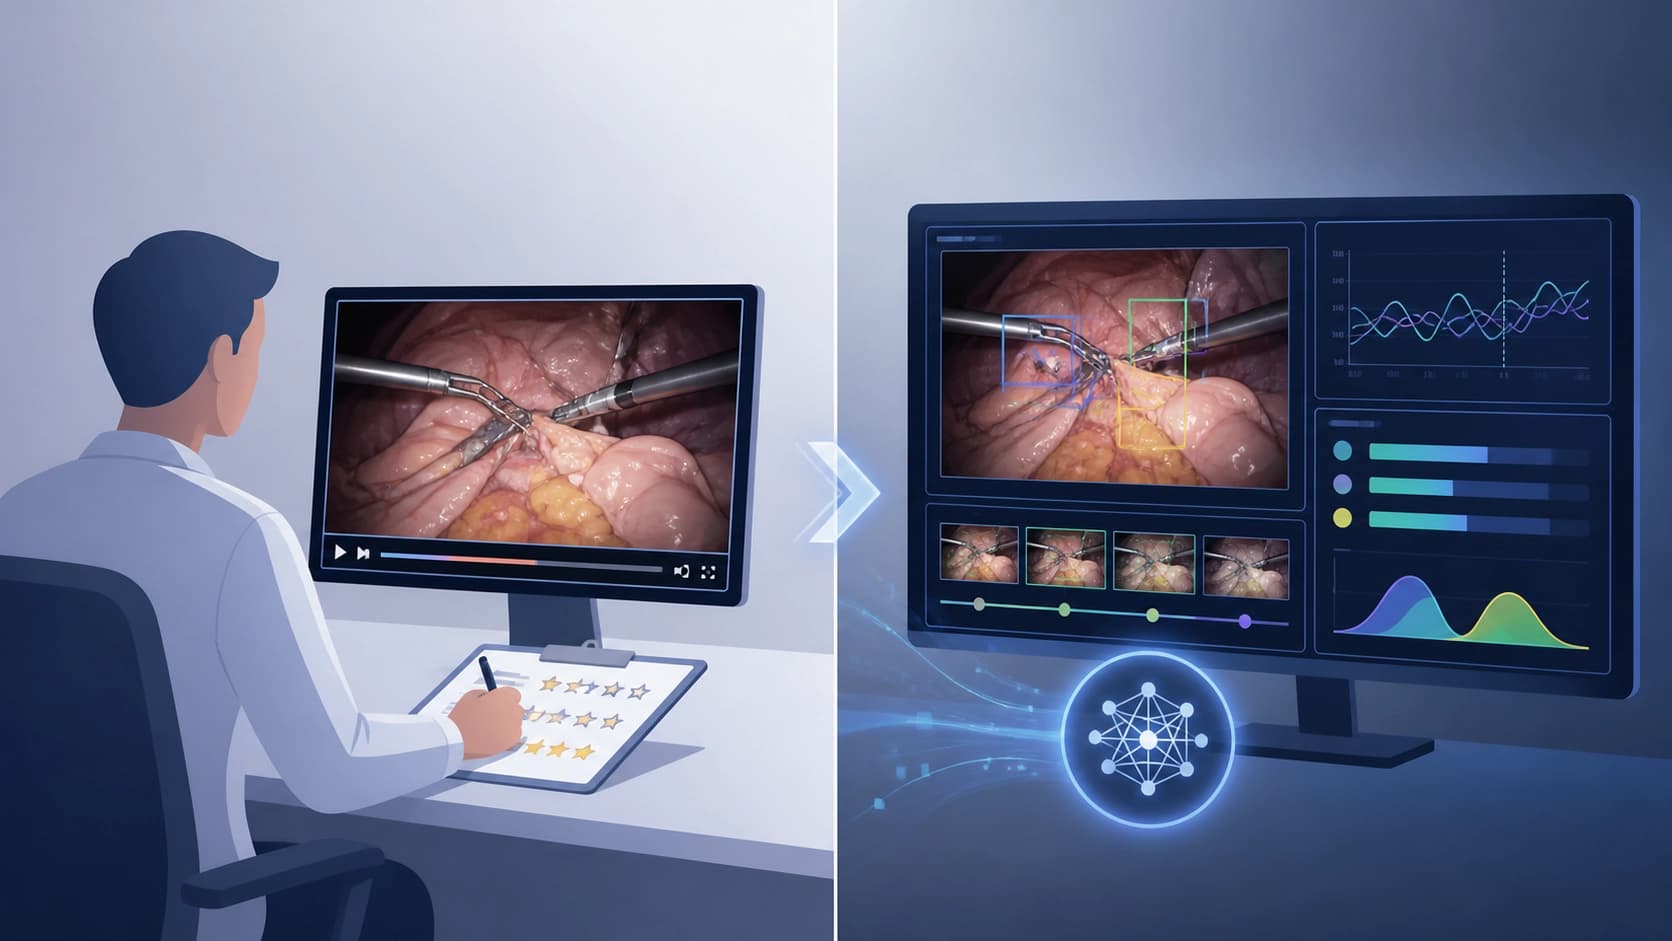
Platform AI yang Dapat Dijelaskan untuk Analisis Video Operasi
Sekelompok peneliti memperkenalkan platform baru yang menggabungkan visi komputer dan pemrosesan sinyal. Tujuannya bukan hanya menentukan tingkat kemahiran, tetapi juga menunjukkan gerakan tangan, kecepatan, dan lintasan instrumen apa yang memengaruhi penilaian. Berbeda dengan solusi "tidak transparan" sebelumnya, setiap kesimpulan di sini dapat ditelusuri hingga metrik tertentu.
Sistem ini mengandalkan kumpulan data terbesar saat ini: 2.000 rekaman operasi pengangkatan katarak. Hal ini memungkinkan algoritme belajar dari berbagai teknik dan gaya kerja, bukan hanya dari sampel terbatas.
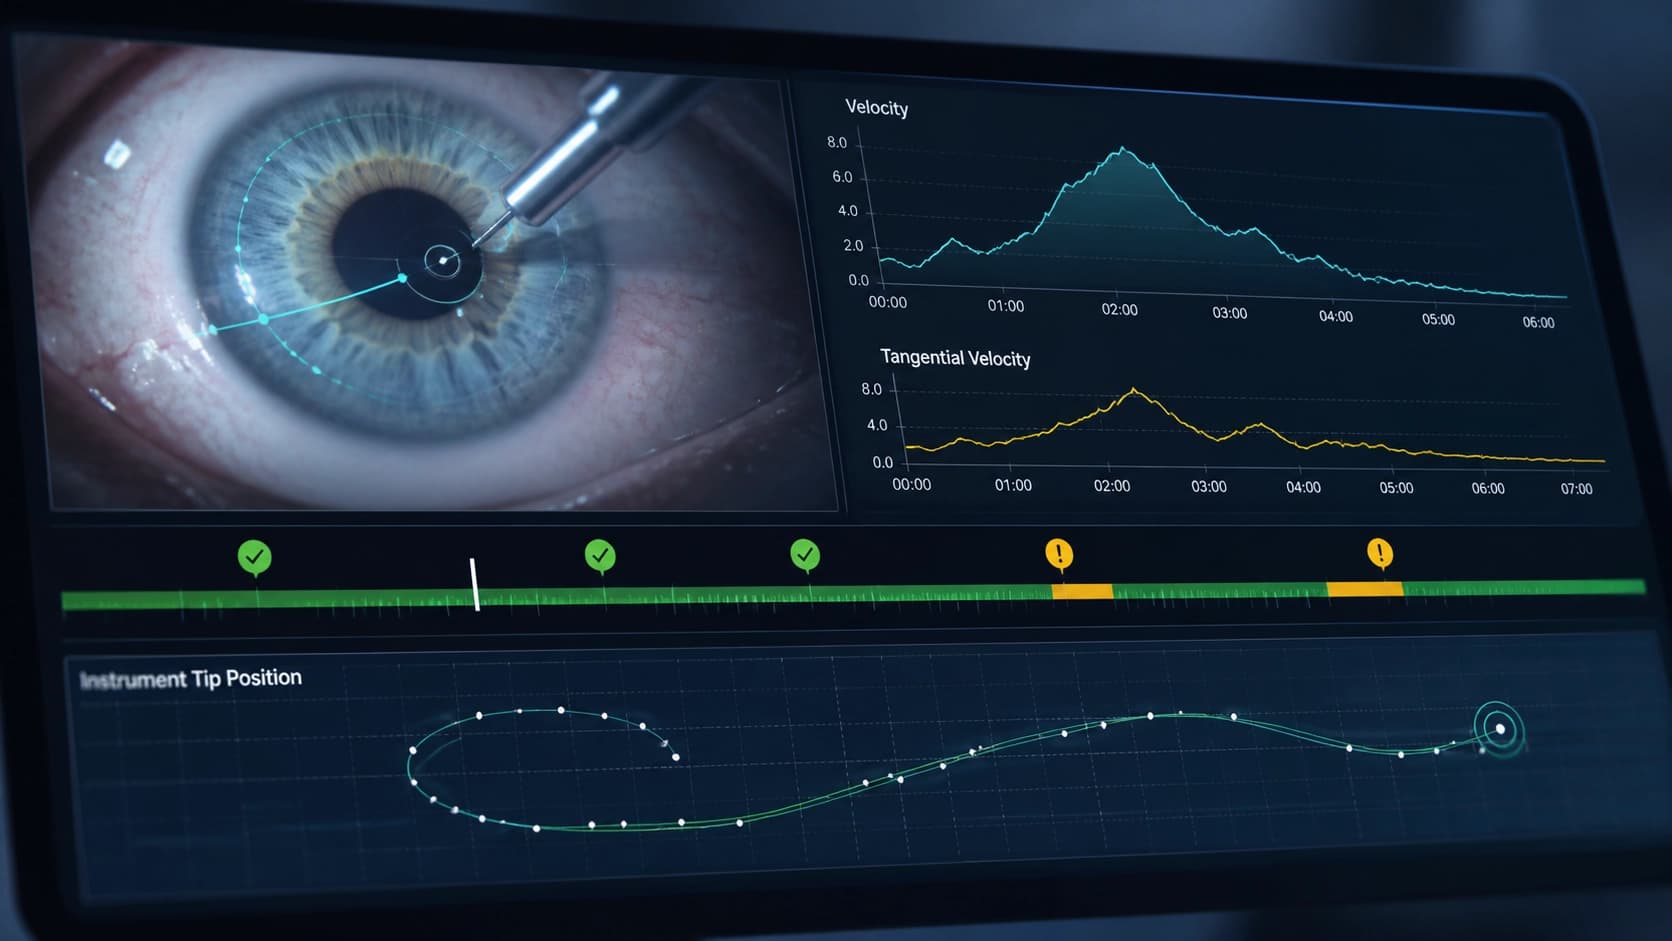
Fitur utamanya adalah keterjelasan. Platform ini mengekstrak sepuluh metrik gerakan objektif dari video, misalnya kelancaran pergerakan instrumen, kecepatan, dan akurasi lintasan. Metrik-metrik ini dibandingkan dengan penilaian para ahli, tetapi tidak seperti manusia, mesin dapat menunjukkan fragmen operasi tertentu di mana gerakan tidak yakin atau tidak optimal.
Bagaimana Akurasi Sistem Diuji
Dalam studi eksperimental, digunakan 83 rekaman video operasi. Ahli bedah menilai masing-masing rekaman menggunakan skala baru CSAS (Capsulorhexis Skill Assessment System), yang berfokus pada tahap kunci — kapsuloreksis. Penilaian subjektif ini kemudian dibandingkan dengan sepuluh metrik yang dihitung secara otomatis.
Hasilnya menunjukkan keselarasan yang tinggi antara penilaian manusia dan perhitungan algoritme. Akurasi prediksi tingkat kemahiran mencapai 87%. Yang terpenting, korelasi terlihat pada setiap metrik secara individual, bukan hanya pada skor akhir. Ini menegaskan: sistem tidak sekadar "menebak", tetapi benar-benar mengenali pola gerakan yang signifikan.
Apa Artinya untuk Praktik
AI yang dapat dijelaskan dapat menjadi alat yang berguna dalam residensi dan pendidikan kedokteran berkelanjutan. Ahli bedah muda tidak hanya menerima penilaian "di atas rata-rata", tetapi juga analisis gerakan spesifik yang perlu ditingkatkan. Komisi sertifikasi mendapatkan data kuantitatif objektif sebagai pelengkap kesan subjektif.
Para pengembang menekankan bahwa platform mereka tidak menggantikan para ahli, tetapi memberikan dukungan kuat bagi mereka. Platform ini berpotensi menyatukan standar penilaian di seluruh dunia, menjadikan pelatihan ahli bedah lebih transparan dan dapat direproduksi. Langkah berikutnya adalah memperluas validasi pada sampel yang lebih besar dan tahap operasi katarak lainnya.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan
Invarian polinomial kanonik dalam diagnostik kegagalan simulator RL: di mana sebenarnya berguna?
Studi ini menguji apakah menyertakan hukum fisika dalam model dinamika yang dapat dilatih memang sepadan: invarian yang diekstrak dari lintasan dan diubah ke bentuk kanonis melalui basis Gröbner hanya sedikit meningkatkan prediksi, tetapi sangat berguna untuk diagnosis—invarian ini dapat membantu menemukan kendala yang dilanggar dan mengidentifikasi parameter spesifik yang keliru.
10 November 2026
AURA-Eval: cara memeriksa apakah agen LLM mengenali risiko dan mengubah langkah berikutnya
Framework ini mengevaluasi perilaku agen LLM bukan berdasarkan keputusan akhir, melainkan respons terhadap risiko di titik-titik penting: rangkaian pemanggilan alat dihentikan, lalu model harus melanjutkan penalaran dan tindakan, sementara panel juri LLM menilai deteksi risiko, karakter, dan keamanan langkah tersebut. Dalam 1.249 tugas yang dikumpulkan dari 157 rangkaian R-Judge, 20 model lebih sering melakukan tindakan tidak aman saat jalur aman tidak tersedia, dan penghapusan pengawasan sebelum eksekusi mengubah 52,3% kasus yang semula aman menjadi tidak aman.
10 November 2026
Memori reservoir Chern–Simons: dinamika konektivitas mandiri dan transfer densitas
Artikel ini membahas bagaimana reservoir menyimpan riwayat sinyal masukan secara bersamaan dalam distribusi densitas dan derajat kebebasan geometris. Perbandingan empat mekanisme menunjukkan bahwa arus menciptakan komponen keterhubungan tersendiri yang mengubah respons densitas berikutnya, sementara penggunaan semua fitur yang terukur memberikan sedikit peningkatan dalam dekode urutan pulsa.
10 November 2026