
Bisakah agen AI menciptakan sesuatu yang benar-benar baru: tinjauan penelitian tentang solusi algoritmik
Para penulis penelitian memeriksa bagaimana metode yang dibuat oleh agen LLM dibandingkan dengan pengembangan manusia: dalam kasus yang jarang terjadi, agen mencapai atau melampaui tingkat manusia, namun hampir semua solusi mereka tetap berada dalam kerangka pendekatan algoritmik yang sudah dikenal dan sering mengulangi yang sudah ada.
Tentang Penelitian
Dapatkah agen AI secara mandiri menemukan metode baru untuk memecahkan masalah kompleks — atau hanya menyusun ulang fragmen dari solusi yang sudah dikenal? Pertanyaan inilah yang menjadi fokus penelitian terbaru berjudul "When AI Designs AI: Innovation or Imitation?" (arXiv:2608.17471), ditulis oleh Yikang Yang, Zhengxin Yang, Luzhou Peng, dan rekan-rekan. Tim peneliti mengirimkan makalah ini pada 18 Agustus 2026; makalah ini mencakup dua bagian sekaligus: cs.AI dan cs.LG.
Para penulis berangkat dari gagasan sederhana namun penting: menunjukkan bahwa agen berhasil menyelesaikan tugas saja tidak cukup. Kita juga perlu memahami seberapa orisinal pendekatan yang digunakannya. Oleh karena itu, penelitian ini merumuskan dua pertanyaan:
- apakah metode yang diusulkan agen benar-benar bekerja tidak lebih buruk daripada metode manusia;
- apakah metode-metode ini berbeda dalam struktur algoritmiknya dari apa yang biasanya dibuat manusia.
Bagaimana Analisis Dilakukan
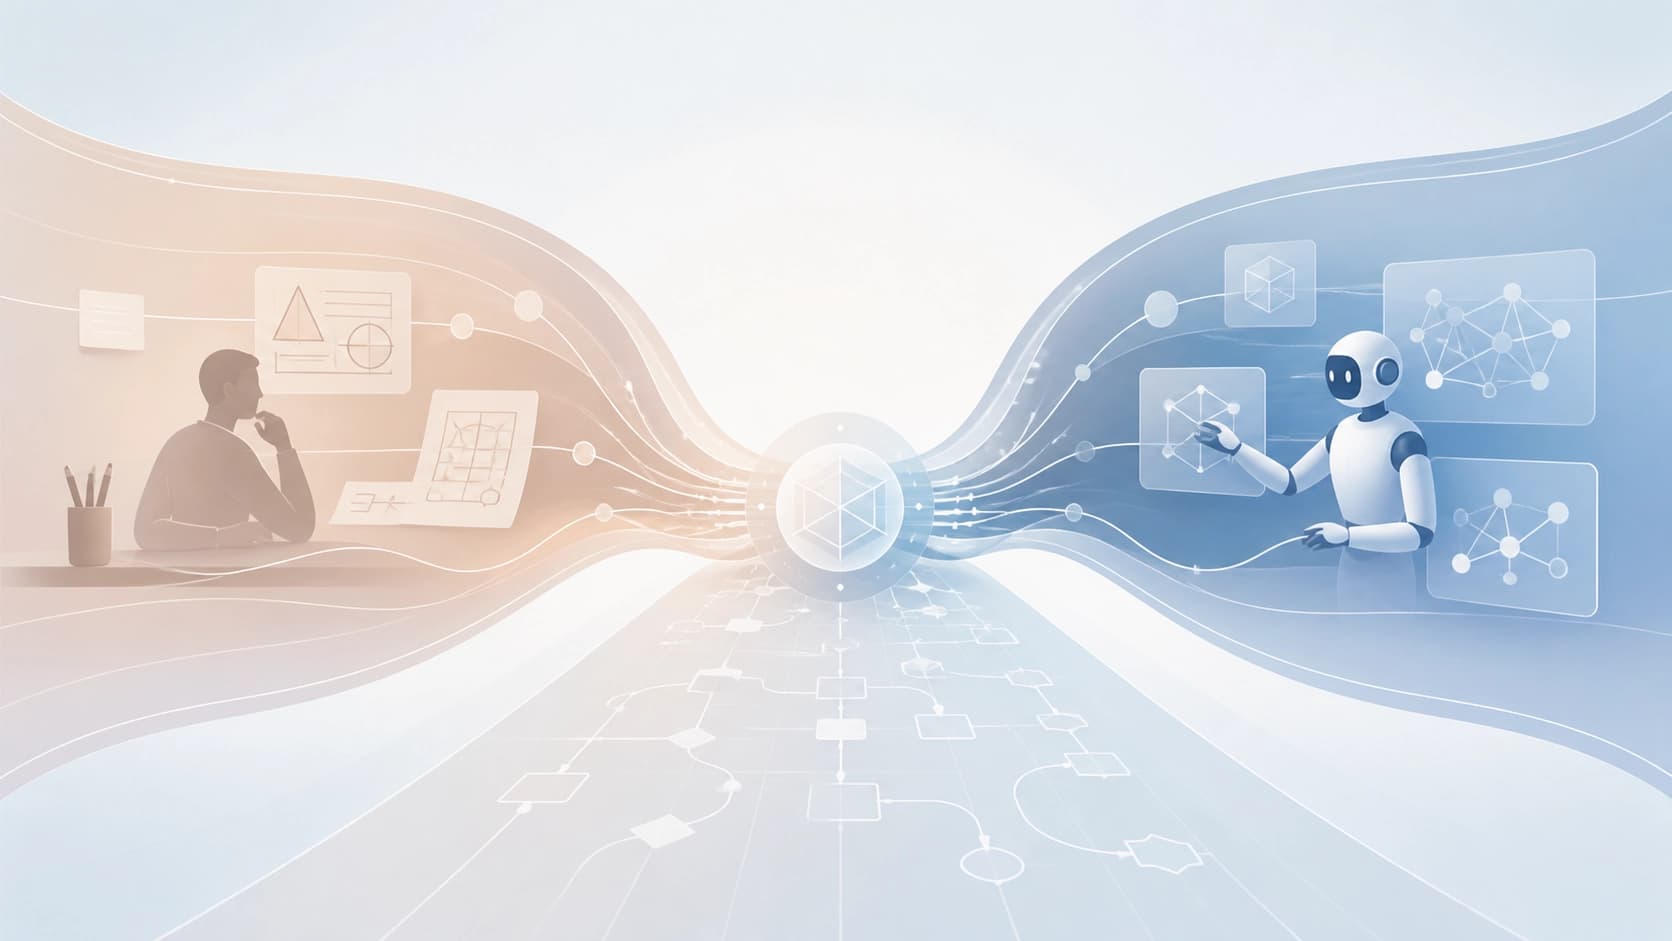
Untuk menjawab pertanyaan-pertanyaan tersebut, para peneliti membangun kerangka kerja khusus. Pertama, dari kumpulan metode manusia untuk tugas tertentu, diturunkan apa yang disebut ruang desain algoritmik — yaitu kumpulan modul tipikal dan hubungan antar modul yang menjadi ciri solusi yang dirancang manusia. Metode manusia dan agen kemudian dipetakan ke dalam ruang-ruang ini. Perbedaan di antara keduanya diukur pada tingkat modul individual — ini memungkinkan kita melihat bagian solusi mana yang sama dan mana yang muncul baru.
Eksperimen dilakukan pada beberapa agen LLM yang banyak digunakan dan kumpulan tugas AI terbuka yang mencakup berbagai modalitas: teks, gambar, dan lainnya. Untuk setiap metode yang dihasilkan agen, dua parameter dievaluasi: kualitas solusi tugas dan tingkat perbedaan algoritmik dari padanan manusia.
Apa Manfaatnya dalam Praktik
Pendekatan ini memungkinkan kita tidak sekadar mengatakan "agen menang" atau "agen kalah", tetapi memisahkan keberhasilan dari kebaruan. Sistem dapat menghasilkan hasil yang sangat baik, tetapi sepenuhnya menyalin skema yang sudah dikenal. Sebaliknya — dapat mengusulkan desain yang tidak biasa, tetapi bekerja lebih buruk. Dualitas inilah yang coba diabadikan oleh para penulis.
Apa yang Ditunjukkan Hasil
Bagian pertama dari hasil terdengar menggembirakan: dalam beberapa kasus, agen modern mencapai tingkat state-of-the-art manusia dan bahkan melampauinya. Ditemukan 10 dari 72 konfigurasi sukses seperti itu. Namun, tidak ada stabilitas: keberhasilan tidak dapat ditransfer secara andal ke tugas lain maupun ke agen lain. Dengan kata lain, agen yang menangani satu tugas dengan cemerlang dapat gagal total pada tugas tetangganya — pola yang dapat memprediksi keberhasilan belum terlihat.
Bagian kedua ternyata jauh lebih signifikan. Hampir semua metode yang dihasilkan agen — 96,8% — masuk ke dalam ruang desain algoritmik yang diturunkan dari solusi manusia. Agen tidak melampaui apa yang sudah ditemukan manusia; mereka sebagian besar menggabungkan dan menyusun ulang blok algoritmik yang sudah dikenal. Terlebih lagi, sekitar separuh metode yang dihasilkan benar-benar identik dengan desain manusia yang sudah ada.
Kesimpulan
Para penulis penelitian sampai pada kesimpulan ganda. Di satu sisi, agen LLM modern sudah mampu menciptakan solusi yang sebanding dengan pengembangan manusia terbaik, dan terkadang bahkan melampauinya. Di sisi lain, masih terlalu dini untuk berbicara tentang kebaruan "sejati" mereka. Hampir semua yang mereka lakukan adalah penggunaan ulang dan rekombinasi yang cermat dari ide-ide algoritmik yang sudah ditemukan. Terobosan nyata melampaui ruang desain manusia — adalah pengecualian langka, bukan aturan.
Ini tidak berarti agen tidak berguna: kemampuan untuk dengan cepat menemukan kombinasi yang berfungsi dari metode yang sudah dikenal itu sendiri berharga. Tetapi jika tujuannya adalah mendapatkan algoritma yang benar-benar baru, mengandalkan hanya pada generasi agen saat ini, berdasarkan hasil, tidak disarankan. Mungkin, langkah berikutnya bukan sekadar agen yang "lebih cerdas", tetapi agen yang dilatih untuk secara sadar melampaui pola yang sudah dikenal.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan
Memori reservoir Chern–Simons: dinamika konektivitas mandiri dan transfer densitas
Artikel ini membahas bagaimana reservoir menyimpan riwayat sinyal masukan secara bersamaan dalam distribusi densitas dan derajat kebebasan geometris. Perbandingan empat mekanisme menunjukkan bahwa arus menciptakan komponen keterhubungan tersendiri yang mengubah respons densitas berikutnya, sementara penggunaan semua fitur yang terukur memberikan sedikit peningkatan dalam dekode urutan pulsa.
10 November 2026
STAR: normalisasi adaptif konteks temporal dan graf layanan untuk manajemen insiden end-to-end
Framework STAR mempelajari representasi dari metrik, log, dan trace dengan menerapkan normalisasi yang dapat dilatih, yang memperhitungkan dinamika temporal multiskala dan struktur dependensi antarservice. Pada dua dataset dunia nyata, pendekatan ini secara konsisten meningkatkan kualitas deteksi anomali, pemeringkatan kegagalan, dan penelusuran akar penyebab dibandingkan metode baseline mutakhir.
10 November 2026
Verifikasi kandidat lebih mahal daripada generasinya: honeypot untuk melawan pencarian kerentanan berbasis LLM
Karya ini mengulas asimetri biaya dalam pencarian bug oleh agen: menghasilkan kandidat itu murah, sedangkan mengonfirmasinya melalui analisis keterjangkauan, eksekusi, dan PoC membutuhkan sebagian besar anggaran, sehingga verifikasi dapat dijadikan sasaran pertahanan tersendiri. RedHerring yang diusulkan—umpan yang disesuaikan dengan repositori dan dilengkapi sertifikat tertutup—mengurangi jumlah kerentanan nyata yang ditemukan sebesar 38,7–60,4% dengan biaya yang sama di 33 proyek OSS-Fuzz; bahkan setelah agen diperingatkan, penurunannya tetap mencapai 37,2%.
9 November 2026