Hadiah berdasarkan hasil — dan titik buta di dalamnya
Dalam penelitian agen GUI, terjadi pergeseran penekanan yang nyata: semakin banyak karya yang dikhususkan untuk pemodelan hadiah berdasarkan hasil (outcome reward modeling). Logikanya sederhana — agen menerima skor bergantung pada apakah trajektorinya mengarah ke keadaan yang dimaksudkan oleh instruksi pengguna. Ada tindakan, ada layar, ada hasil akhir, ada penilaian.
Tetapi di sinilah letak jebakannya. Jika agen menerima hadiah "atas hasil", seseorang harus merumuskan apa sebenarnya yang dianggap sebagai hasil. Dalam skema tipikal, langkah ini entah dilewati dengan menggantinya dengan rumusan umum, atau diserahkan pada kebijaksanaan model itu sendiri: model "bernalar" selama proses verifikasi, tanpa kriteria yang ditetapkan secara eksplisit. Keduanya tampak berfungsi tepat sampai saat harus menilai puluhan tugas berbeda dengan verifikator yang sama.
Tiga kesalahan tipikal rubrik yang digeneralisasi
Penulis karya arXiv:2608.24174 "Task-Adaptive Rubrics for GUI Reward Modeling" (Tao Xiong dan rekan penulis) menjelaskan apa yang diakibatkan oleh bersandarnya pada templat universal atau pada penalaran implisit model. Masalahnya dapat diprediksi:
- Pemindahan pemeriksaan antar tugas. Kriteria yang pernah diturunkan untuk satu skenario secara mekanis diterapkan pada skenario lain, di mana kriteria itu sama sekali tidak masuk akal.
- Hilangnya batasan. Persyaratan spesifik dari instruksi saat ini — nilai yang diperlukan, bidang tertentu, langkah-langkah tertentu — luput dari perhatian, karena rubrik umum tidak membedakannya.
- Kekakuan berlebihan. Verifikator mulai menuntut hal-hal yang tidak diminta pengguna, dan menolak tugas yang sebenarnya dikerjakan dengan benar.
Penyebab umum dari ketiganya sama: rubrik hidup terpisah dari tugas. Rubrik tidak diturunkan dari instruksi, melainkan dilekatkan padanya dari luar.
Bagaimana AdaptRubric disusun
Kerangka kerja yang diusulkan memang dinamai demikian — kerangka rubrik "dari kasar ke halus" (Coarse-to-Fine Rubrics Framework). Tugasnya bukan menyimpan seperangkat kriteria yang sudah jadi, melainkan membangunnya untuk setiap instruksi tertentu, bergerak dari tingkat yang luas ke tingkat yang sempit. Dua tahap menyelesaikan dua masalah berbeda, dan ini adalah detail kunci dari konstruksinya.
Tahap kasar: pahami dulu ini kelas tugas apa
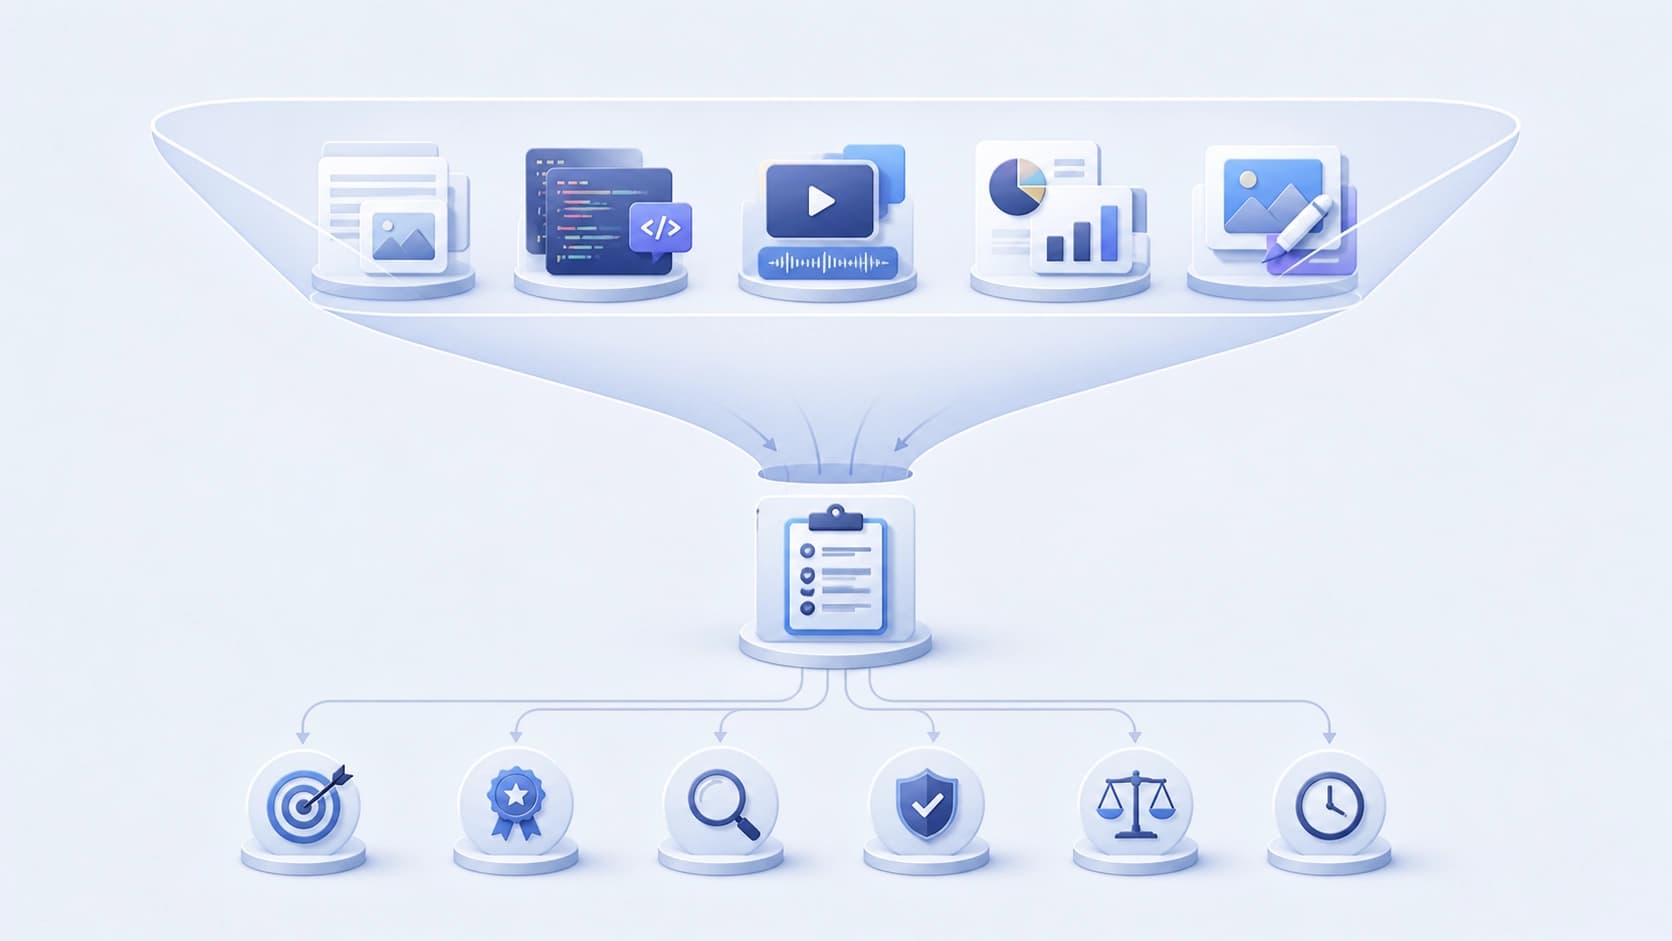
Langkah pertama adalah perutean. Instruksi dikaitkan dengan keluarga tugas GUI tertentu, dan dari keluarga ini ditarik kriteria yang dapat digunakan kembali. Maknanya adalah bahwa tindakan serupa memiliki tanda-tanda keberhasilan yang stabil: tanda-tanda itu sudah diketahui dan tidak perlu ditemukan kembali untuk setiap permintaan baru. Rubrik kasar menetapkan kerangka — kerangka, bukan putusan akhir.
Tahap halus: tarik detail dari instansi tertentu
Langkah kedua bekerja dengan instruksi individual. Dari instruksi itu diekstraksi petunjuk-petunjuk ringkas — nilai spesifik, cakupan tindakan, batasan yang menjadi prinsip dalam tugas ini. Di sinilah rubrik berhenti menjadi umum dan menjadi milik kasus ini. Persyaratan yang tidak diajukan pengguna tidak muncul; persyaratan yang dia ajukan tidak hilang.
Pemisahan semacam ini menghilangkan keberatan utama terhadap skema universal: generalisasi tetap ada, tetapi tidak lagi menggantikan spesifikasi.
Hasil: offline dan dalam pembelajaran penguatan
AdaptRubric diuji dalam dua mode. Pertama — evaluasi hadiah secara offline, yaitu seberapa baik verifikator membedakan trajektori yang berhasil dan yang tidak. Kedua — optimasi online dengan pembelajaran penguatan, di mana rubrik sudah berfungsi sebagai sumber sinyal untuk melatih agen.
Angka yang diklaim: dengan anggaran gambar yang sebanding, skor F1 naik 3,6 poin dibandingkan nilai rata-rata solusi dasar, dan peningkatan keberhasilan penyelesaian tugas mencapai 4,23 poin. Penulis menekankan bahwa keunggulan ini konsisten tereproduksi, bukan bertumpu pada beberapa percobaan yang kebetulan berhasil.
Apa yang secara mendasar berubah
Penilaian agen berhenti menjadi pertanyaan "verifikatornya bagus atau buruk". Penilaian menjadi pertanyaan prosedural: siapa dan atas dasar apa merumuskan kriteria untuk tugas tertentu ini. Selama kriteria diturunkan secara implisit, kesalahan penilaian hampir tidak mungkin dipisahkan dari kesalahan agen itu sendiri — keduanya tampak sama dalam laporan akhir.
Pendekatan dengan rubrik adaptif membuat lapisan perantara menjadi eksplisit, sehingga dapat diperiksa, didiskusikan, dan diperbaiki secara terpisah dari model. Untuk pengembangan, ini juga kemudahan praktis: jika rubrik dibangun berdasarkan instruksi, maka perubahan rumusan tugas secara otomatis mengubah cara penilaiannya, tanpa perlu menulis ulang verifikator.
Pertanyaan terbuka tetap ada — seberapa baik perutean menangani tugas-tugas di persimpangan keluarga, bagaimana tahap halus berperilaku pada instruksi yang sengaja ambigu. Tetapi perumusan masalahnya sendiri sudah tampak lebih bermanfaat daripada upaya lain untuk membuat templat universal sedikit lebih rapi.