
Qwen2-VL-72B-Instruct
Multimodal Alibaba jaringan saraf dengan 73,4 miliar parameter gambar dan video.
Tinjau
Keterangan jaringan saraf Qwen2- VL-72B- Instruct
Qwen2- VL-72B- Instruct adalah multimodal lesu - model dirancang Tim Alibaba. Jaringan saraf dirancang untuk menganalisis informasi visual yang kompleks: dia menerima Masuk sebagai gambar statis dengan baik dan urutan video. Arsitektur model memiliki 73,4 miliar parameter apa yang memungkinkan untuk diproses adegan kompleks Ekstrak rincian dan membangun rantai logis berdasarkan apa yang Anda lihat.
# # # Technological yayasan
Model didasarkan pada mekanisme resolusi dinamis yang menyesuaikan pemrosesan ke ukuran berkas tertentu. Hal ini meningkatkan akurasi objek kecil. Selain itu digunakan peningkatan posisi emblem M-ROPE yang membantu model untuk menavigasi dengan benar dalam ruang dan waktu dalam analisis urutan video.
Rilis tanggal dan posisi
Model diumumkan pada akhir Agustus 2024. Ini diposisikan. solusi instrumental terkait tugas tentang Memahami isi berkas media: dari autodescription sebelum menganalisis konten video dengan elemen penalaran dan interaksi.
Qwen2-VL-72B- Instruct
| Karakter | Nilai |
|---|---|
| Pengembang | Alibaba |
| Tipe | Model multimodal |
| Parameter | 73.4 miliar (73.4B) |
| Tanggal rilis | 29 Agustus 2024 |
| Nilai rata-rata | 75.8% |
| Lisensi | tongyi\ qianwen |
| Batas Pengetahuan | 30 Juni 2023 |
| Data masukan | Gambar, video |
Untuk siapa Qwen2-VL-72B- Instruct jaringan saraf cocok?
Alat ini ditujukan pada berbagai macam pengguna yang membutuhkan konten visualisasi otomatis.
Pengembang dan peneliti
Spesialis pembelajaran mesin dapat menggunakan model ini sebagai dasar untuk membuat aplikasi komputer- visi: pencarian sistem analisis video gambar, konten moderasi. Buka arsitektur dan dokumentasi teknis mengizinkannya untuk diintegrasikan ke dalam jaringan pipa yang ada.
Pengelola Bisnis dan Isi
Untuk perusahaan. bekerja pada skala besar Model ini berguna dalam memecahkan katalog masalah penciptaan otomatis dari deskripsi informasi ekstraksi teks dari foto-foto dokumen atau tanda-tanda. Analisis video membantu dalam memproses rekaman dari kamera pengawas atau Webinars.
Bagaimana menggunakan Qwen2-VL-72B- Instruksikan jaringan saraf?
Pendekatan untuk digunakan Hal ini tergantung pada pelatihan teknis pengguna dan tujuan akhir.
Cara akses
Model ini menyebar. sebagai produk perangkat lunak open source. Pekerjaan akan membutuhkan bobot model Unduh dan menjalankannya secara lokal di server dengan daya komputasi yang cukup (GPU dengan memori video dalam jumlah besar). Pilihan alternatif - gunakan melalui platform API pihak ketiga yang menyediakan akses ke model dengan berlangganan.
# # # Dasar script
Pengguna mengunggah berkas gambar atau video, mengatur permintaan teks dan model mengembalikan jawabannya. Untuk memperoleh kualitas Sangat penting untuk merumuskan pertanyaan dengan jelas.: misalnya, "Dengarkan semua obyek dalam foto ini" atau "Kenali teks pada gambar dan menerjemahkannya dalam bahasa Inggris? Model ini mendukung penalaran langkah demi langkah yang memungkinkan Anda menganalisis adegan kompleks secara bertahap.
Dasar Qwen2- VL-72B- Instruct
Model ini menawarkan serangkaian fungsi yang meliputi skenario kunci dari data pemrosesan visual.
Video pemrosesan gambar
Jaringan saraf menerima kedua jenis file tanpa perlu untuk pre-coding.. Resolusi dinamis memungkinkan Anda untuk bekerja efektif sebagai kecil gambar baik dan pada Ini adalah banyak video.
Langkah demi langkah penalaran dan analisis visual
Alih-alih deskripsi sederhana, model dapat membangun logika menjawab Pertanyaan tentang penyebab peristiwa video membandingkan objek menarik kesimpulan berdasarkan apa yang Anda lihat.
Pengakuan teks multibahasa
Pembangunan modul OCR mengambil teks dari gambar dengan bahasa yang berbeda. Ini berguna untuk pemrosesan dokumen. Foto layar dengan subtitle atau tanda-tanda.
Agen interaksi
Model dapat bertindak sebagai agen. melakukan instruksi ke dalam konteks Video. Sebagai contoh, Hal ini dapat melacak perubahan pada objek dalam bingkai atau menanggapi pertanyaan, membutuhkan pertimbangan dinamika sementara.
Keuntungan Qwen2- VL-72B- Instruct
Kekuatan kunci dari model membedakannya dari alat-alat dari generasi sebelumnya.
Akurasi tinggi dan skala
Dengan 73,4 miliar parameter, model menunjukkan pemahaman yang mendalam. konteks visual. Dia mengatasi. pada tugas, yang membutuhkan pertimbangan banyak rincian dan hubungan antara objek.
# # Universalitas dan multibahasa
Menggabungkan analisis gambar Video dan pengenalan teks pada bahasa yang berbeda dalam satu model menyederhanakan pengembangan produk kompleks. Tidak perlu menghubungkan beberapa layanan khusus.
Fleksibilitas yang digunakan
Resolusi dinamis dan peningkatan posisi embedding memungkinkan model untuk beradaptasi dengan ukuran masukan sewenang-wenang tanpa kehilangan kualitas. Ini penting ketika bekerja dengan format berkas tidak standar.
Kekecewaan Qwen2- VL-72B- Instruct
Meskipun keuntungan Ketika memilih model, memperhitungkan keterbatasan tertentu.
Peralatan tuntutan tinggi
Untuk meluncurkan 73 miliar model yang diperlukan server beberapa prosesor grafis yang kuat. Hal ini membuat penggunaan lokal mahal untuk tim kecil dan pengembang individu.
# # # Perbatasan terbatas
Model dilatih pada data yang relevan sampai 30 Juni 2023. Mereka mungkin disalahartikan atau tidak dikenali ketika menganalisa konten.
Qwen2-VL-72B- Instruct
Ruang lingkup model mencakup berbagai tugas yang berhubungan dengan konten visual.
# # Pengakuan teks dan dokumen
Model secara efektif mengekstrak dan mengenali teks dari foto, pemindaian, dan cuplikan layar. Ini adalah permintaan dalam tugas digitalisasi otomatis Moderasi konten dan pengolahan kuesioner.
Analisa isi video
Kemungkinan pemrosesan video memungkinkan memecahkan pemantauan tugas kualitas kontrol eh membuat deskripsi otomatis video dan subtitle.
Kompleks. alasan visual
Model mampu menanggapi pertanyaan menuntut fasilitas analisis mereka interaksi dan perubahan tanpa batas. Ini digunakan. membantu sistem keamanan dan layanan analisis.
Qwen2- VL-72B- Instruct Price
Informasi resmi tentang biaya model dari pengembang di mata air terbuka Itu tidak diterbitkan. Model ini menyebar. di bawah lisensi tongyi\ qianwen yang menyediakan akses terbuka untuk download berat badan. Namun, pengguna harus secara independen menutupi biaya komputasi sumber daya Menyewa server GPU atau membeli perangkat keras Anda sendiri. Biaya akhir tergantung pada penyedia awan yang dipilih dan durasi model.
Kondisi Qwen2-VL-72B- Instruct
Model ini menyebar. di bawah lisensi tongyi qianwen dikembangkan oleh Alibaba. Lisensi ini berbaring pembatasan pemodelan tujuan komersial juga mengatur modifikasi dan produk turunan distribusi. Sebelum digunakan dianjurkan melihat teks penuh dari persetujuan lisensi jadi verifikasi sesuai dengan persyaratan skenario Anda dari pemegang hak cipta.
Qwen2-VL-72B- Instruct
Model saat ini tersedia untuk diunduh. melalui saluran resmi Alibaba dan repositori model. Informasi pada daerah tertentu di mana tersedia terbatas dalam bahan referensi tidak diberikan. Pendaftaran mungkin diperlukan untuk mengakses platform Pengembang bobot dan penerimaan persyaratan lisensi. Selain itu, model dapat diintegrasikan ke dalam layanan ketiga partai. menyediakan akses API untuk itu.
Apa yang membedakan Qwen2-VL-72B- Instruct dari analogues
Ada beberapa produk multimodal di pasaran. Model yang sebanding dengan Qwen2-VL-72B- Instruct. Di antara versi analog terbaru Qwen3 32B Thinking, Qwen2,5 VL 72B Instruct, Qwen2,5 VL 32B Instruct, dan QvQQ-72B-Preview dan Qwen2,5 VL 7B Instruct.
Perbandingan dengan versi sebelumnya
Perbedaan utama dari Qwen2,5 adalah peningkatan arsitektur dalam penggelapan posisi dan persyaratan dinamis. Qwen2-VL-72B- Instruct adalah satu model. baris pertama-up Namun, model sebelumnya berfokus pada gambar.
Perbedaan dari model dengan parameter lebih sedikit
Sebagai perbandingan. pada compact Qwen2,5 VL 7B Instruct Versi 73--milyar dolar menunjukkan akurasi yang lebih tinggi pada tugas visual yang kompleks dan mengatasi lebih baik pada Pengakuan rincian kecil. Namun, ini dicapai dengan biaya persyaratan yang jauh lebih besar terhadap sumber daya perangkat keras.
Perbedaan dari pengembang model lain
Tidak seperti banyak. keputusan komersial tertutup Qwen2- VL-72B- Instruct tersedia dengan berat badan terbuka apa yang memungkinkan Anda untuk beradaptasi itu ke kebutuhan spesifik dari proyek tanpa referensi ke penyedia API. Peserta terdekat dalam fungsionalitas adalah Qwen3.6 Plus. Namun, perbandingan kinerja rinci memerlukan pengujian terpisah. target tugas.
Kesimpulan
Qwen2- VL-72B- Instruct adalah kuat model multimodal dari Alibaba. yang mencakup berbagai tugas terkait pada analisis Gambar dan video. 73.4 miliar parameter Dengan resolusi dinamis dan peningkatan embedding posisi, dapat melakukan tahap-by- langkah penalaran. Kenali teks dalam berbagai bahasa dan berinteraksi pada konten video. Model ini cocok untuk pengembang dan perusahaan yang siap menyediakan sumber daya komputasi yang diperlukan untuk menjalankannya. Batas utama adalah peralatan tingkat tinggi dan perbatasan pengetahuan terbatas pertengahan 2023. Umumnya kanan Pilihan antara model ini dan analog saat ini dari baris Qwen tergantung pada tugas-tugas tertentu dan kapasitas yang tersedia.
Pertanyaan yang sering ditanyakan
Lihat juga
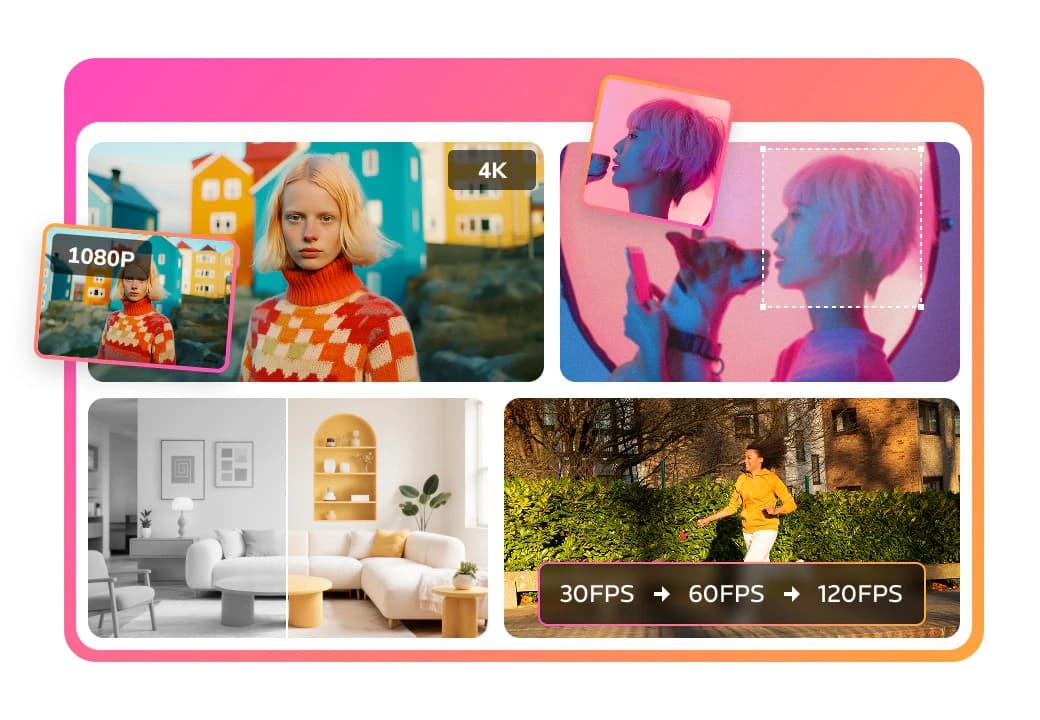
Sebuah peralatan AI multimedia untuk menyunting dan meningkatkan foto, video, dan dokumen PDF.

Krom ekstensi yang membantu mengelola tab, sejarah, dan penanda dengan asisten AI.

Sebuah layanan online yang mengenali teks pada halaman manga dan manhwa, menerjemahkannya ke dalam bahasa yang berbeda, dan membuatnya kembali ke gambar tanpa merusak karya seni asli.

Al toolkit untuk pembuatan video dan editing, termasuk avatar, lip- sync, and voice cloning.

Platform untuk menciptakan multi- agen sistem AI dan chatbots untuk otomatis dukungan pelanggan dan generasi memimpin.

Platform manajemen projek dengan tugas, pelacakan waktu, dan fitur pemantauan pekerja.

Perpustakaan TypeScript yang memungkinkan Anda menggunakan GPT-4 sebagai waktu jalan untuk fungsi yang dijelaskan oleh komentar.
Panel AI sisi yang membantu menjawab pertanyaan, bekerja dengan dokumen, dan menghasilkan gambar.