
लोग समझने योग्य हैं, LLM नहीं: विशेषज्ञ मॉडलों के तर्क को समझा नहीं सके
शोधकर्ताओं ने मात्रात्मक तर्क और रसायन विज्ञान के कार्यों पर लोगों और छह भाषा मॉडलों के उत्तरों के पीछे छिपे कारकों की तुलना की। मानव उत्तरों से निकाले गए कारकों की विशेषज्ञों द्वारा सफलतापूर्वक व्याख्या की गई, जबकि अधिकांश मॉडल निर्माण उनके लिए अपारदर्शी साबित हुए।
लोग समझ में आते हैं, LLM — नहीं: विशेषज्ञ मॉडलों के तर्क को समझा नहीं पाए
जब हम परीक्षणों के परिणामों को देखते हैं, तो यह मान लेना स्वाभाविक लगता है कि कृत्रिम बुद्धिमत्ता कार्यों को «मनुष्यों की तरह» हल करती है: वही अवधारणाओं, नियमों और तर्कों का उपयोग करती है। हालाँकि, एक नया शोध इस धारणा पर प्रश्नचिह्न लगाता है। वैज्ञानिकों ने पाया कि छिपी हुई संरचनाएँ जो LLM के उत्तरों को निर्धारित करती हैं, अधिकांश मामलों में मानवीय व्याख्या के योग्य नहीं होतीं — यहाँ तक कि क्षेत्र के विशेषज्ञों के लिए भी नहीं।
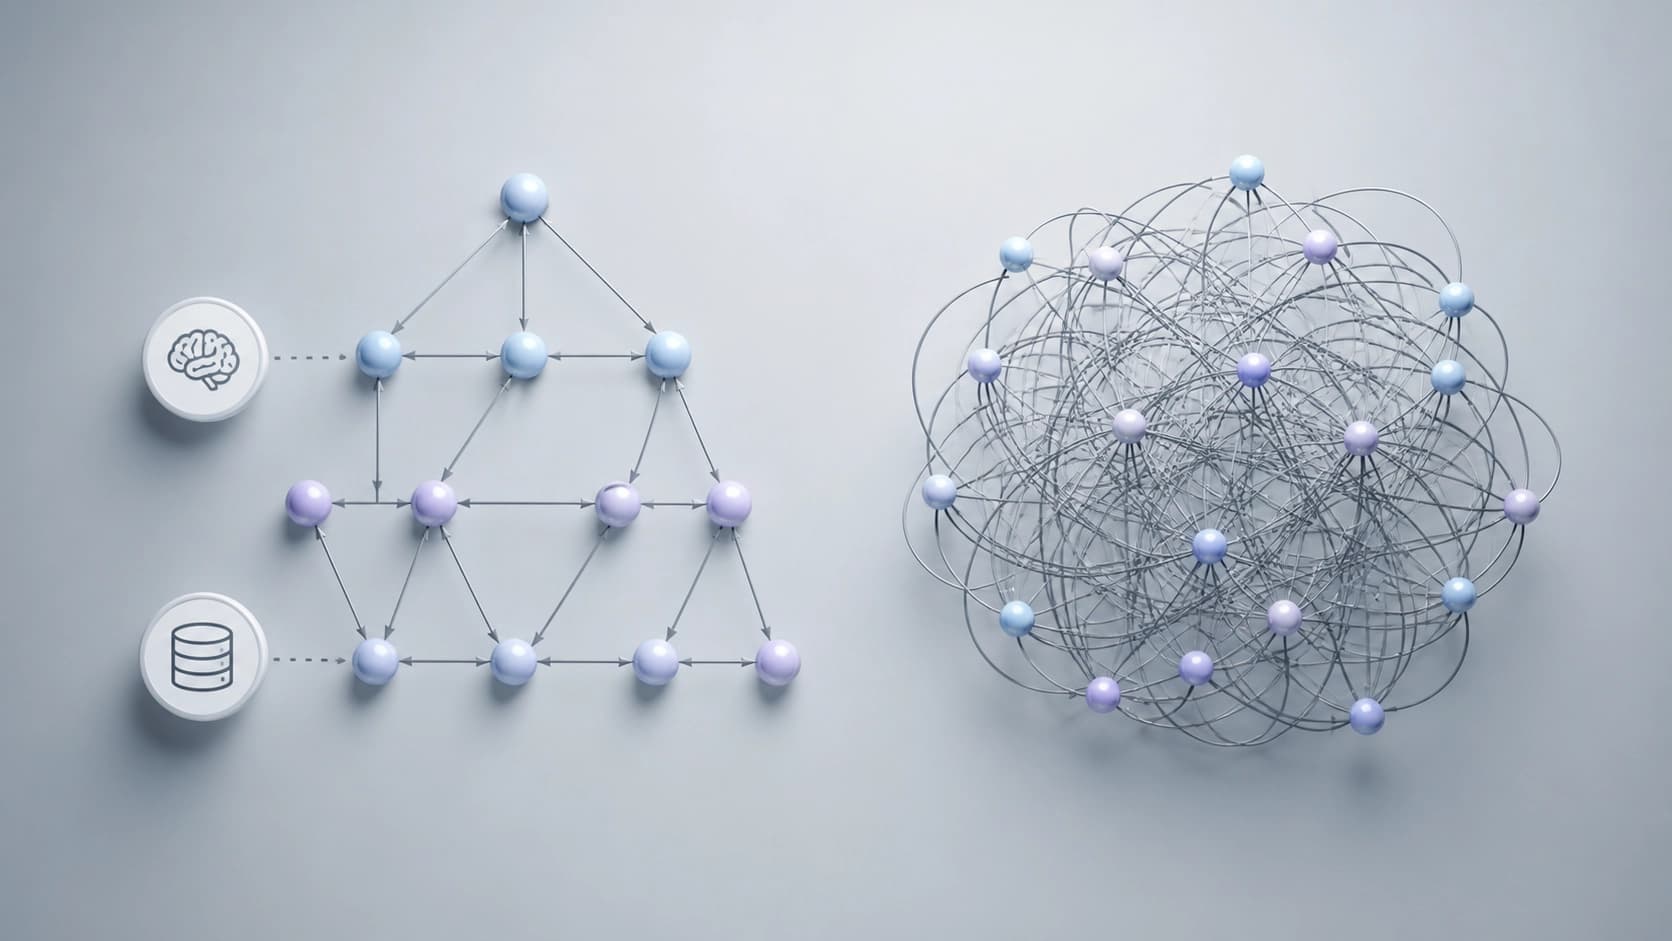
वास्तव में क्या जाँचा गया
कार्य के लेखकों (arXiv:2608.17810) — अलोना स्ट्रुगात्स्की, लिकोल ज़ेइनफेल्ड, जेसन कूपर और उनके सहयोगियों — ने मात्रात्मक तर्क और रसायन विज्ञान के कार्यों पर मनुष्यों और छह अलग-अलग LLM के उत्तर लिए। खोजपूर्ण कारक विश्लेषण की मदद से, उन्होंने प्रत्येक समूह के लिए छिपे हुए अव्यक्त कारकों की पहचान की, जो संभवतः इन कार्यों की सफलता के पीछे हैं।
फिर विषय विशेषज्ञों ने आँख मूँदकर प्राप्त संरचनाओं का अध्ययन किया और कारकों को शैक्षणिक अर्थ देने का प्रयास किया: उदाहरण के लिए, «सूत्रों के साथ काम करने की क्षमता» या «स्टोइकियोमेट्री की समझ»। अंधा प्रारूप किसी भी संकेत को समाप्त कर देता था — विशेषज्ञों को नहीं पता था कि ग्राफ़ मनुष्यों से संबंधित हैं या मॉडलों से।
परिणाम: व्याख्यात्मकता में अंतर
विशेषज्ञों ने मानवीय उत्तरों के आधार पर प्राप्त कारकों को लगभग बिना किसी समस्या के समझ लिया। अधिकांश निर्माणों को सार्थक स्पष्टीकरण मिला, जिसे आसानी से सीखने या निदान के लिए सिफारिशों में बदला जा सकता था।
LLM के साथ तस्वीर अलग थी:
- मात्रात्मक तर्क में, विशेषज्ञ मॉडलों के लिए पहचाने गए कारकों में से किसी एक की भी सार्थक व्याख्या नहीं कर सके।
- रसायन विज्ञान में स्थिति थोड़ी बेहतर थी, लेकिन फिर भी आदर्श से दूर: केवल लगभग आधी संरचनाओं को ही समझाया जा सका।
इसका क्या मतलब है
लेखक एक महत्वपूर्ण निष्कर्ष निकालते हैं: जब LLM परीक्षणों में उच्च परिणाम दिखाते हैं, तो इसका मतलब यह नहीं है कि वे हमारे परिचित तरीके से तर्क करते हैं। मॉडल सांख्यिकीय रूप से प्रभावी, लेकिन मनुष्यों के लिए पूरी तरह से «अलग» समाधान खोज सकते हैं। उनके आंतरिक तंत्र पैटर्न के स्तर पर काम करते हैं, जो समझने योग्य शैक्षणिक या संज्ञानात्मक अर्थ नहीं रखते।
यह अवलोकन आम प्रथा को चुनौती देता है, जब AI के परिणामों से ज्ञान या दक्षताओं के स्तर के बारे में निष्कर्ष निकालने की कोशिश की जाती है। यदि हम यह नहीं समझा सकते कि उत्तरों के पीछे वास्तव में कौन सी संरचनाएँ हैं, तो हम मॉडलों को अस्तित्वहीन क्षमताओं का श्रेय देने का जोखिम उठाते हैं — या इसके विपरीत, वास्तविक सीमाओं को अनदेखा कर देते हैं।
आगे कहाँ जाना है
शोध यह दावा नहीं करता कि LLM की व्याख्या करना सैद्धांतिक रूप से असंभव है। यह केवल दिखाता है कि मानवीय अनुभूति के अध्ययन के लिए बनाया गया शास्त्रीय दृष्टिकोण सीधे मॉडलों पर लागू नहीं होता। संभवतः, मौलिक रूप से नए विश्लेषण तरीकों को विकसित करने की आवश्यकता होगी — ऐसे तरीके जो अव्यक्त संरचनाओं की «गैर-मानवीय» प्रकृति को ध्यान में रखते हैं।
फिलहाल, प्रश्न खुला रहता है: यदि विशेषज्ञ मॉडलों के तर्क को नहीं समझा सकते, तो क्या हम शिक्षा और ज्ञान मूल्यांकन में उनके उपयोग पर भरोसा कर सकते हैं? उत्तर, संभवतः, AI की जाँच के दृष्टिकोणों और मशीनों की «बुद्धिमत्ता» से हमारी अपेक्षाओं दोनों के पुनर्विचार की माँग करेगा।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री
बिना फ़ाइन-ट्यूनिंग के स्रोतों के SQL व्यू के ज़रिए LLM के भ्रमों की जाँच
यह काम जाँचता है कि क्या LLM मतिभ्रम का पता लगाने के लिए बिना पर्यवेक्षण के स्रोत से जोड़ने हेतु एक बुनियादी प्रतीकात्मक कौशल—स्रोत दस्तावेज़ों के आधार पर SQL डेटाबेस बनाना—का उपयोग कर सकता है। RAGTruth और DiaHalu पर यह न्यूरो-सिम्बॉलिक पाइपलाइन सीधे भविष्यवाणी करने से अधिक सटीक साबित होती है और अत्याधुनिक तरीकों के बराबर प्रदर्शन करती है, जबकि इसके लिए डोमेन-विशिष्ट फ़ाइन-ट्यूनिंग की आवश्यकता नहीं होती।
9 नवम्बर 2026
MathAdv: मशीन-निर्मित प्रमाणों की अंतिम सटीकता के पीछे क्या छिपा है?
गणित के 13 स्नातक और स्नातकोत्तर विषयों के कार्यों का यह नैदानिक समूह Lean 4 में स्वचालित प्रमेय-प्रमाणन प्रणालियों का मूल्यांकन केवल अंतिम परिणाम के आधार पर नहीं, बल्कि विषय पर उनकी पकड़, अनौपचारिक तर्क की गुणवत्ता और शर्तों को नए शब्दों में प्रस्तुत किए जाने पर उनकी मजबूती के आधार पर भी करता है। घटक-वार विश्लेषण से पता चलता है कि किसी समस्या को औपचारिक रूप में बदलना अब भी सबसे बड़ी बाधा है, और सफलता गणित के क्षेत्र तथा समस्या को प्रस्तुत करने के तरीके पर बहुत अधिक निर्भर करती है।
9 नवम्बर 2026
AffordanceWAM: दृश्य पूर्वानुमान और मैनिपुलेटर नियंत्रण के बीच मध्यस्थ के रूप में अफ़ॉर्डेंस
यह कार्य एक जनरेटिव मॉडल का वर्णन करता है, जो मानव वीडियो का उपयोग करके बिना क्रिया एनोटेशन और रीटार्गेटिंग के अंतःक्रियाओं की विविधता बढ़ाते हुए, भविष्य के RGB अवलोकनों, स्केलर फ़ील्ड्स और अफ़ॉर्डेंस हीटमैप्स तथा रोबोट के सतत कमांड्स का एक साथ पूर्वानुमान लगाता है। RoboCasa, CALVIN ABC→D और वास्तविक दुनिया के कार्यों पर, यह दृष्टिकोण केवल-RGB और केवल-रोबोट डेटा वाले बेसलाइन की तुलना में लगातार बेहतर प्रदर्शन करता है।
9 नवम्बर 2026