
आर्किटेक्चर कैसे काम करता है
SymbolicLight V1 दो पथों वाला एक भाषा मॉडल है: Leaky Integrate-and-Fire (LIF) की बाइनरी डायनेमिक्स और एक सतत अवशिष्ट प्रवाह।
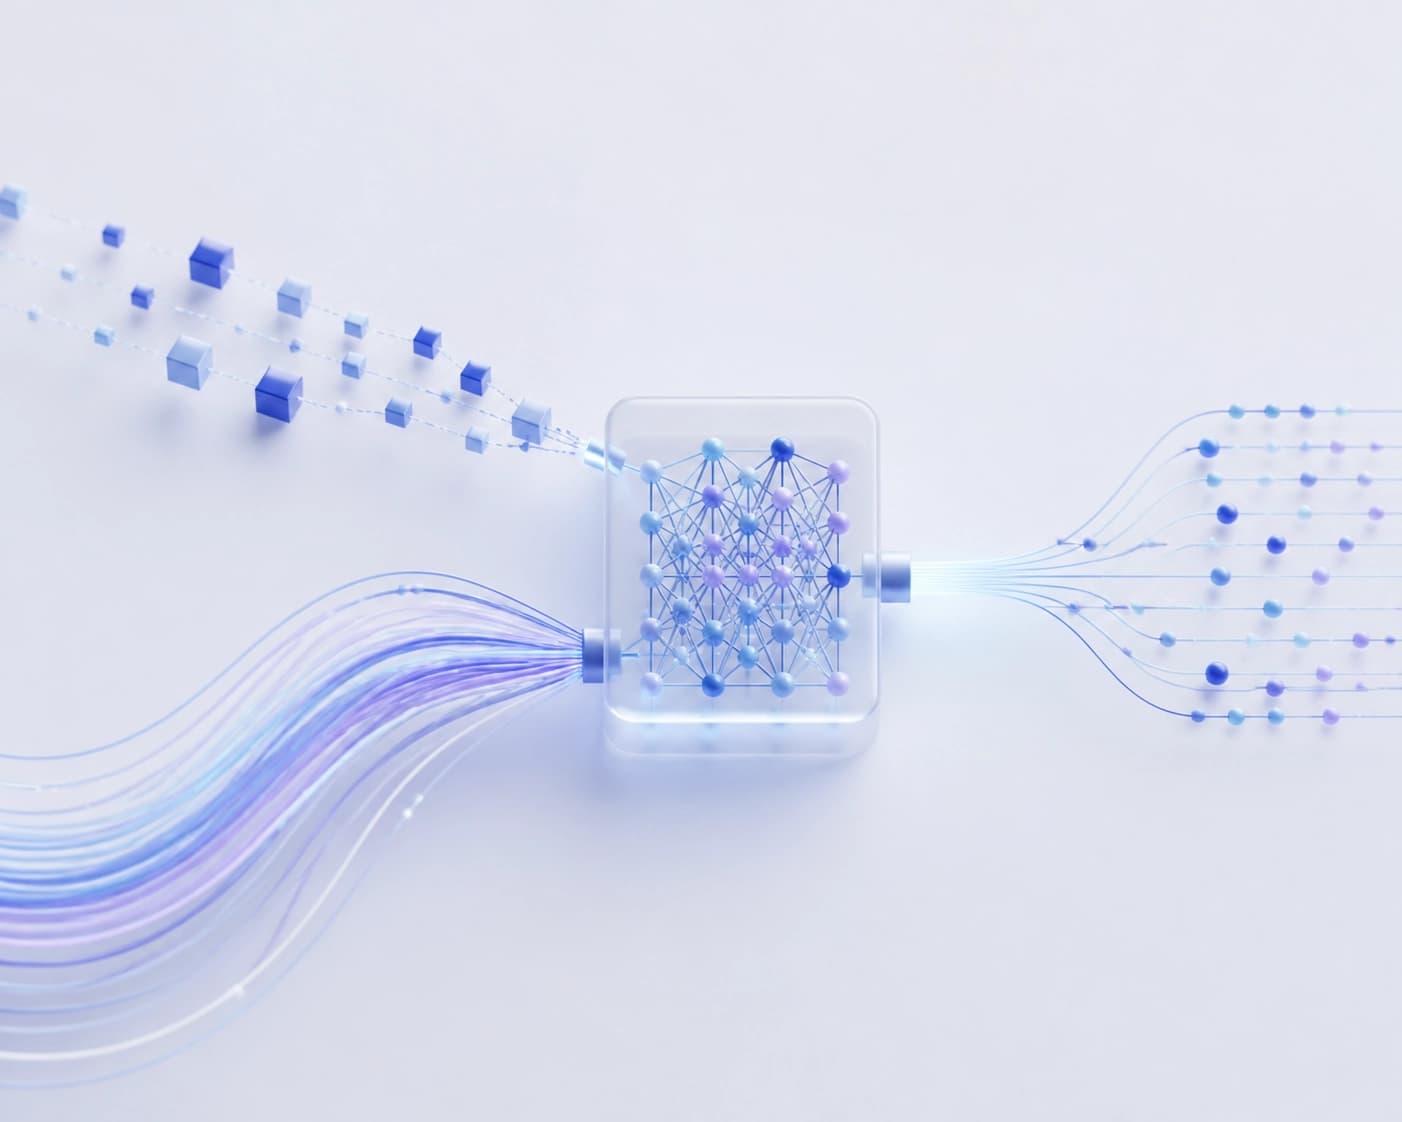
- Dual-Path SparseTCAM मिक्सर, प्रथम-क्रम के घातीय क्षय वाली अवस्था और स्थानीय विंडो अटेंशन को एक साथ जोड़ता है।
- दोनों घटक सतत अवशिष्ट प्रवाह में काम करते हैं।
- मिक्सर के बाद, मॉडल संदर्भ-अनुकूलित डिकोडिंग हेड का उपयोग करता है।
व्यावहारिक कसौटी: यह आर्किटेक्चर विरल स्पाइक डायनेमिक्स और सतत प्रवाह के संयोजन का अध्ययन करने के लिए दिलचस्प है। यह अपने आप में गति या सटीकता में बढ़त की पुष्टि नहीं करता।
मॉडल को किन डेटा पर प्रशिक्षित और मूल्यांकित किया गया
SymbolicLight V1 के चार मॉडलों को शुरू से प्रशिक्षित किया गया। प्रत्येक में 194M पैरामीटर हैं।
- प्रशिक्षण कॉर्पस में चीनी और अंग्रेज़ी के 3B टोकन शामिल हैं।
- कॉर्पस में 10 डोमेन शामिल हैं।
- एक निश्चित टोकन-भारित मूल्यांकन सेट पर PPL 8.88–8.93 रहा। औसत 8.904 और नमूना मानक विचलन 0.019 था।
- मूल्यांकन सेट और प्रशिक्षण स्ट्रीम के बीच ओवरलैप की जाँच नहीं की गई।
कोड टोकन मूल्यांकन सेट का 43.7% हैं। दस डोमेन पर PPL का अनभारित औसत 29.38 है। एनकोडर के प्रशिक्षण परीक्षणों में शून्य स्पाइक्स का औसत अनुपात 89.96% था; यह पूरे मॉडल के विरलता का आकलन नहीं है।
व्यावहारिक कसौटी: PPL परिणामों पर मूल्यांकन सेट की संरचना और डेटा के बीच ओवरलैप की जाँच न किए जाने को ध्यान में रखकर विचार करना चाहिए। शून्य स्पाइक्स के अनुपात को पूरे मॉडल पर लागू नहीं किया जा सकता।
मॉडल की GPT-2 से तुलना कैसे की गई
एक ही कॉर्पस, टोकनाइज़र, टोकन बजट और हार्डवेयर के साथ, SymbolicLight V1 का टोकन-भारित औसत PPL, GPT-2 201M से 7.7% अधिक था।
| कसौटी | परिणाम |
|---|---|
| PPL | SymbolicLight: औसतन 8.904; GPT-2 201M: 8.27 |
| ज़ीरो-शॉट | पाँच बेंचमार्क पर 200M के पैमाने वाले दोनों मॉडलों की सटीकता में कोई स्पष्ट अंतर नहीं दिखा |
| 4-ग्राम दोहराव | temperature 0.7 और top-k 50 पर SymbolicLight कम दोहराव उत्पन्न करता है |
| एंट्रॉपी मॉड्यूलेशन | यह नियम दोहराव के मामले में मॉडलों की रैंकिंग को उलट देता है |
व्यावहारिक कसौटी: चुनाव इस बात पर निर्भर करता है कि किस मापदंड का मूल्यांकन किया जा रहा है। PPL के मामले में GPT-2 बेहतर था, जबकि दोहराव का परिणाम जनरेशन नियम पर निर्भर था।
गति और ऊर्जा खपत के मापन से क्या पता चला
RTX 2080 Ti पर SymbolicLight V1 और GPT-2 की जनरेशन गति मापी गई। ऊर्जा खपत के अनुमान जनरेशन के बाद के पावर रीडिंग से प्राप्त किए गए, जनरेशन के दौरान पावर को समाकलित करके नहीं।
| मॉडल | जनरेशन गति | ऊर्जा खपत का अनुमान |
|---|---|---|
| SymbolicLight V1 | 22.8 टोकन/सेकंड | लगभग 2,848 mJ/टोकन |
| GPT-2 | 91.5 टोकन/सेकंड | लगभग 905 mJ/टोकन |
इन मापों में GPT-2 ने तेज़ी से जनरेट किया और उसकी ऊर्जा खपत का अनुमान कम था। ऊर्जा खपत के ये अनुमान जनरेशन के दौरान पावर को समाकलित करने पर आधारित नहीं हैं।
व्यावहारिक कसौटी: गति और ऊर्जा खपत की तुलना के लिए केवल RTX 2080 Ti पर किए गए इस मापन के परिणाम उपलब्ध हैं।


