
संक्षेप में मुख्य बात
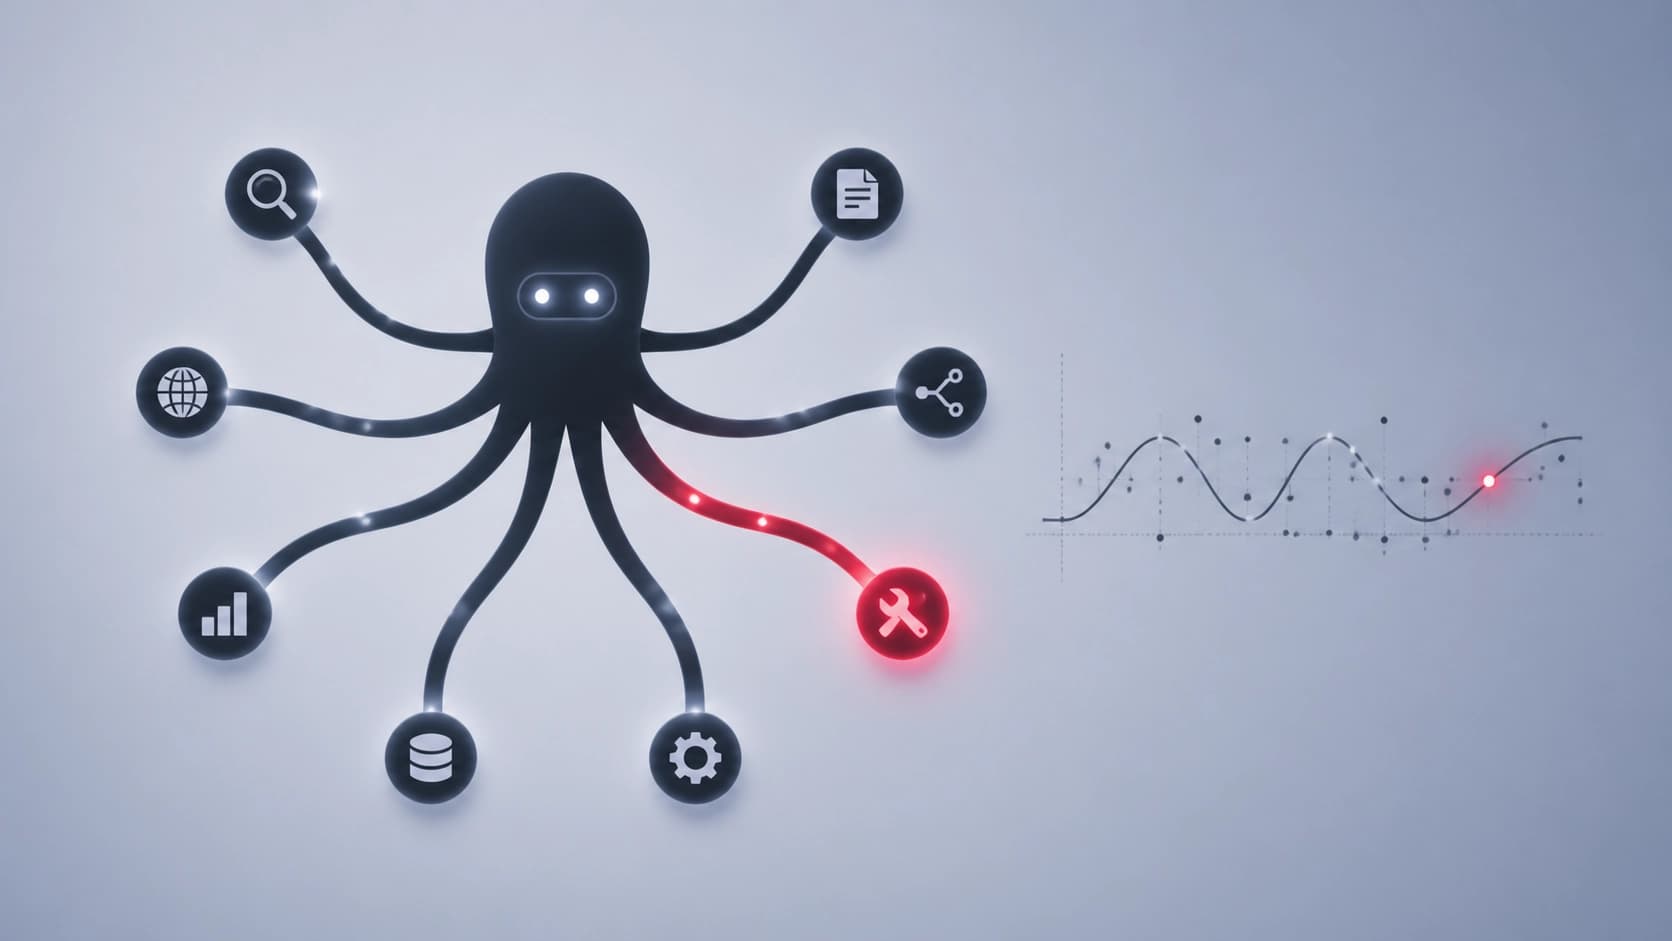
एक प्रकार के हमले होते हैं, जिन्हें आमतौर पर अप्रत्यक्ष प्रॉम्प्ट इंजेक्शन (indirect prompt injection, IPI) कहा जाता है: मॉडल को चैट में नहीं, बल्कि किसी बाहरी टूल के नतीजे में — वेब पेज, ईमेल, फ़ाइल या API रिस्पॉन्स में — हानिकारक निर्देश चुपके से दिया जाता है। एजेंट इसे ईमानदारी से डेटा की तरह पढ़ता है और किसी और का साइड-टास्क पूरा कर सकता है।
चीन के शोधकर्ताओं की एक टीम (Jianshuo Dong, Yiming Liu, Maosen Zhang, Nan Deng, Peng Xu, Xiaoping Zhang, Tianwei Zhang, Jie Zhang, Han Qiu) ने दिखाया: जिस पल एजेंट "इंजेक्शन की चपेट में आया", वह उसके आंतरिक प्रतिनिधित्वों में पहले से दर्ज हो चुका होता है — इससे भी पहले कि उसने पहला टोकन जारी किया हो। यह काम arXiv पर प्रकाशित हुआ है (2608.02657, v1 — 1 अगस्त 2026, v2 — 24 अगस्त 2026), DOI: 10.48550/arXiv.2608.02657, कोड खुले तौर पर उपलब्ध है।
मुख्य आश्चर्य भेद्यता में नहीं है — यह तो बहुत पहले से ज्ञात है — बल्कि इस बात में है कि भेद्यता का संकेत रैखिक रूप से, स्थिर रूप से, और सैकड़ों अरब तथा खरबों पैरामीटर के पैमाने वाले मॉडलों पर भी निकाला जा सकता है। यानी यह किसी एक डेटासेट का नाज़ुक, कृत्रिम सहसंबंध नहीं है।
IPI exposure: प्रोब असल में क्या ढूँढते हैं
लेखक एक कार्यशील अवधारणा पेश करते हैं — "IPI exposure" — यानी प्रोसेसिंग के दौरान मॉडल की वह स्थिति, जो इस बात से मेल खाती है कि उसके कॉन्टेक्स्ट में कोई अवांछित बाहरी निर्देश आ गया है। यह सफल हमले के तथ्य के समान नहीं है: मॉडल खतरे को "नोटिस" करके भी उसे अंजाम दे सकता है। यहाँ बात सिर्फ़ exposure की आंतरिक स्थिति की है।
यहाँ मुख्य शब्द है — "जनरेशन से पहले"। प्रोब डिकोडर में प्रवेश के समय की छिपी हुई अवस्थाओं को देखता है, न कि पहले से जारी किए गए उत्तर को। यह दो कारणों से महत्वपूर्ण है: पहला, संकेत वहाँ भी मौजूद होता है जहाँ अंतिम व्यवहार हानिरहित दिखता है; दूसरा, निदान उससे पहले किया जा सकता है कि मॉडल ने साइड-इफ़ेक्ट वाला कोई टूल कॉल कर लिया हो।
प्रयोग: आठ मॉडलों पर रैखिक प्रोब
पैमाना और दायरा
जाँच आठ मॉडलों पर की गई। इनमें GLM-5.2 — 753 अरब पैरामीटर, और Kimi-K3 — 2.8 खरब पैरामीटर शामिल हैं; इस मॉडल के नतीजे लेख के दूसरे संस्करण में जोड़े गए हैं। छिपी हुई अवस्थाओं पर प्रशिक्षित सरल रैखिक प्रोब (linear probes) इस्तेमाल किए गए — यानी मूल रूप से वेक्टर के ऊपर एक रैखिक क्लासिफ़ायर।
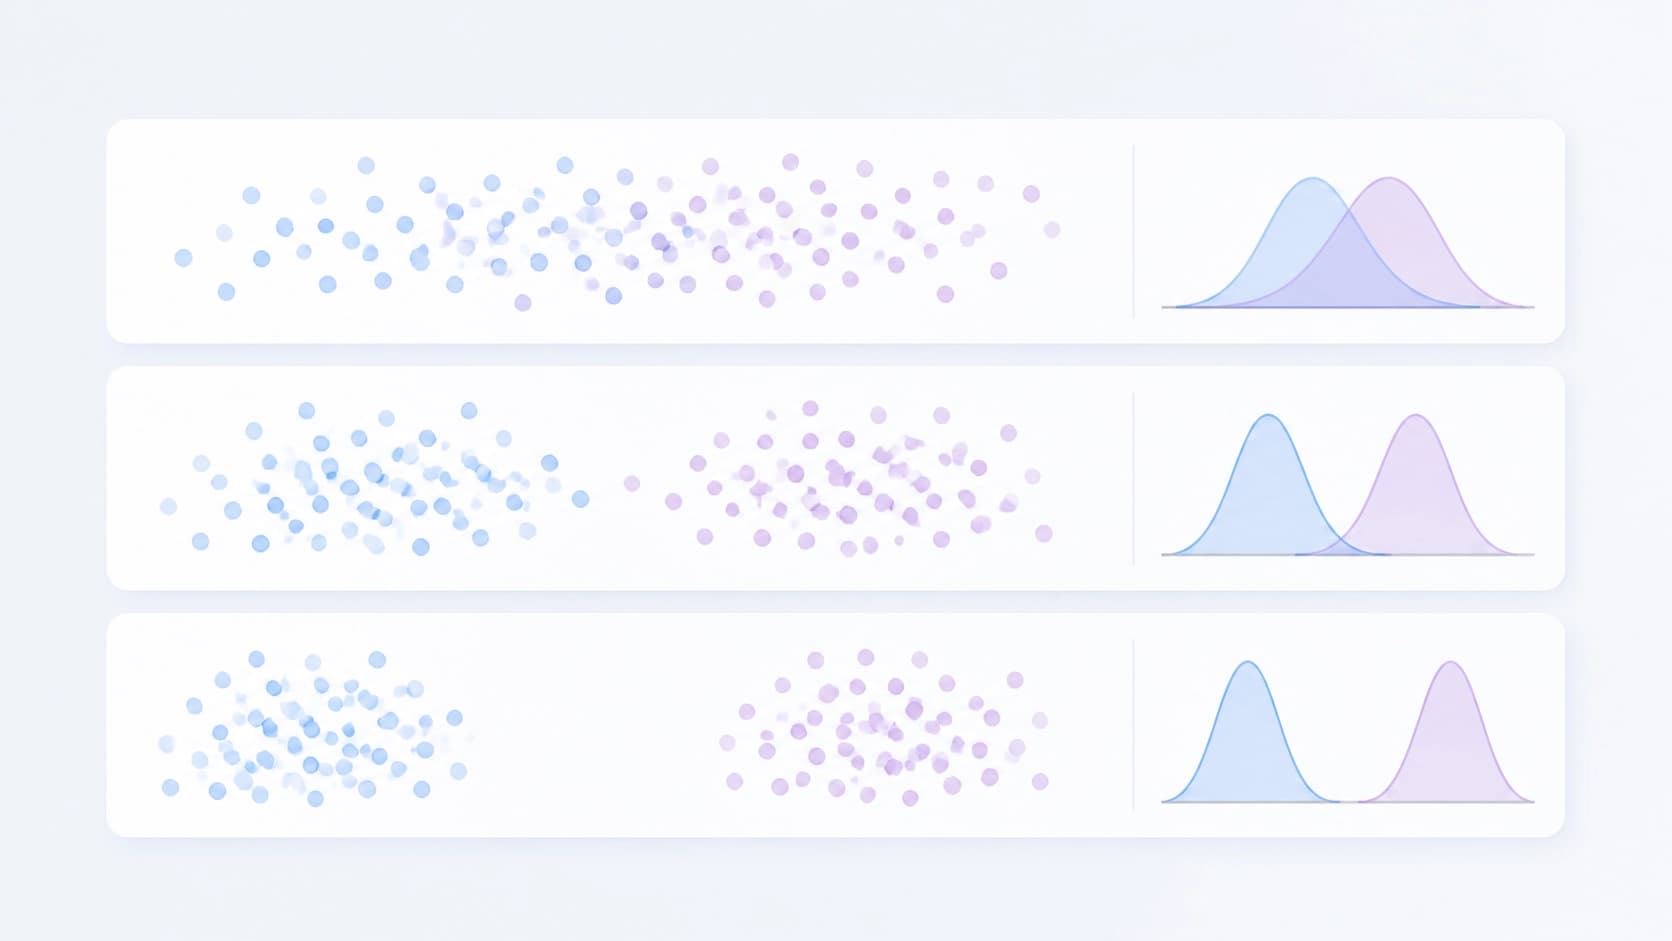
यहाँ AUROC का मतलब है दो वर्गों को अलग करने की गुणवत्ता: एक डेटा पर प्रशिक्षित प्रोब ने उन हमलों, एजेंटिक निर्देशों और टास्क-सेटों पर 0.90+ दिखाया, जिन्हें उसने पहले कभी नहीं देखा था। दूसरे शब्दों में, प्रशिक्षण किसी एक ख़ास हमले के परिदृश्य के हिसाब से नहीं ढाला गया था।
संकेत की स्थिरता
v2 में प्रयोगों की एक अलग शृंखला सामान्यीकरण को समर्पित है। प्रोब अपनी भविष्यवाणी क्षमता बनाए रखते हैं:
- अनुकूली हमलों के विरुद्ध, यानी जब हमलावर ख़ुद प्रोब को धोखा देने की कोशिश करता है;
- क्रॉस-लिंगुअल परिस्थितियों में, जब प्रशिक्षण और परीक्षण के उदाहरण अलग-अलग भाषाओं में हों;
- नए प्रकार के टास्क और निर्देशों पर, जो प्रशिक्षण के दौरान नहीं मिले थे।
यही तिकड़ी आमतौर पर आंतरिक प्रतिनिधित्वों पर आधारित किसी भी डिटेक्टर की सबसे कमज़ोर कड़ी होती है, इसलिए इसकी जाँच AUROC के आँकड़े से भी ज़्यादा अहम है।
जानने और करने के बीच की खाई
लेख की सबसे अप्रिय खोज है तथाकथित knowledge-action gap। आधुनिक मॉडल पोस्ट-ट्रेनिंग के बाद वाकई ऐसे संकेत एन्कोड करते हैं जो IPI exposure की भविष्यवाणी करते हैं, लेकिन सुरक्षित व्यवहार के लिए भरोसेमंद ट्रिगर की तरह उनका इस्तेमाल नहीं करते। मॉडल समस्या को "महसूस" करता है और फिर भी आगे बढ़ता जाता है।
कारण, काम करने के तर्क को देखते हुए, यह है कि संकेत प्रतिनिधित्वों में मौजूद तो है, लेकिन कार्रवाई की नीति से स्थिर संबंध से जुड़ा नहीं है। न सामान्य इनकार, न सिस्टम प्रॉम्प्ट में दिए निर्देश इस खाई को भरते हैं — वे किसी और स्तर पर काम करते हैं।
प्रोब-नियंत्रित सुरक्षा
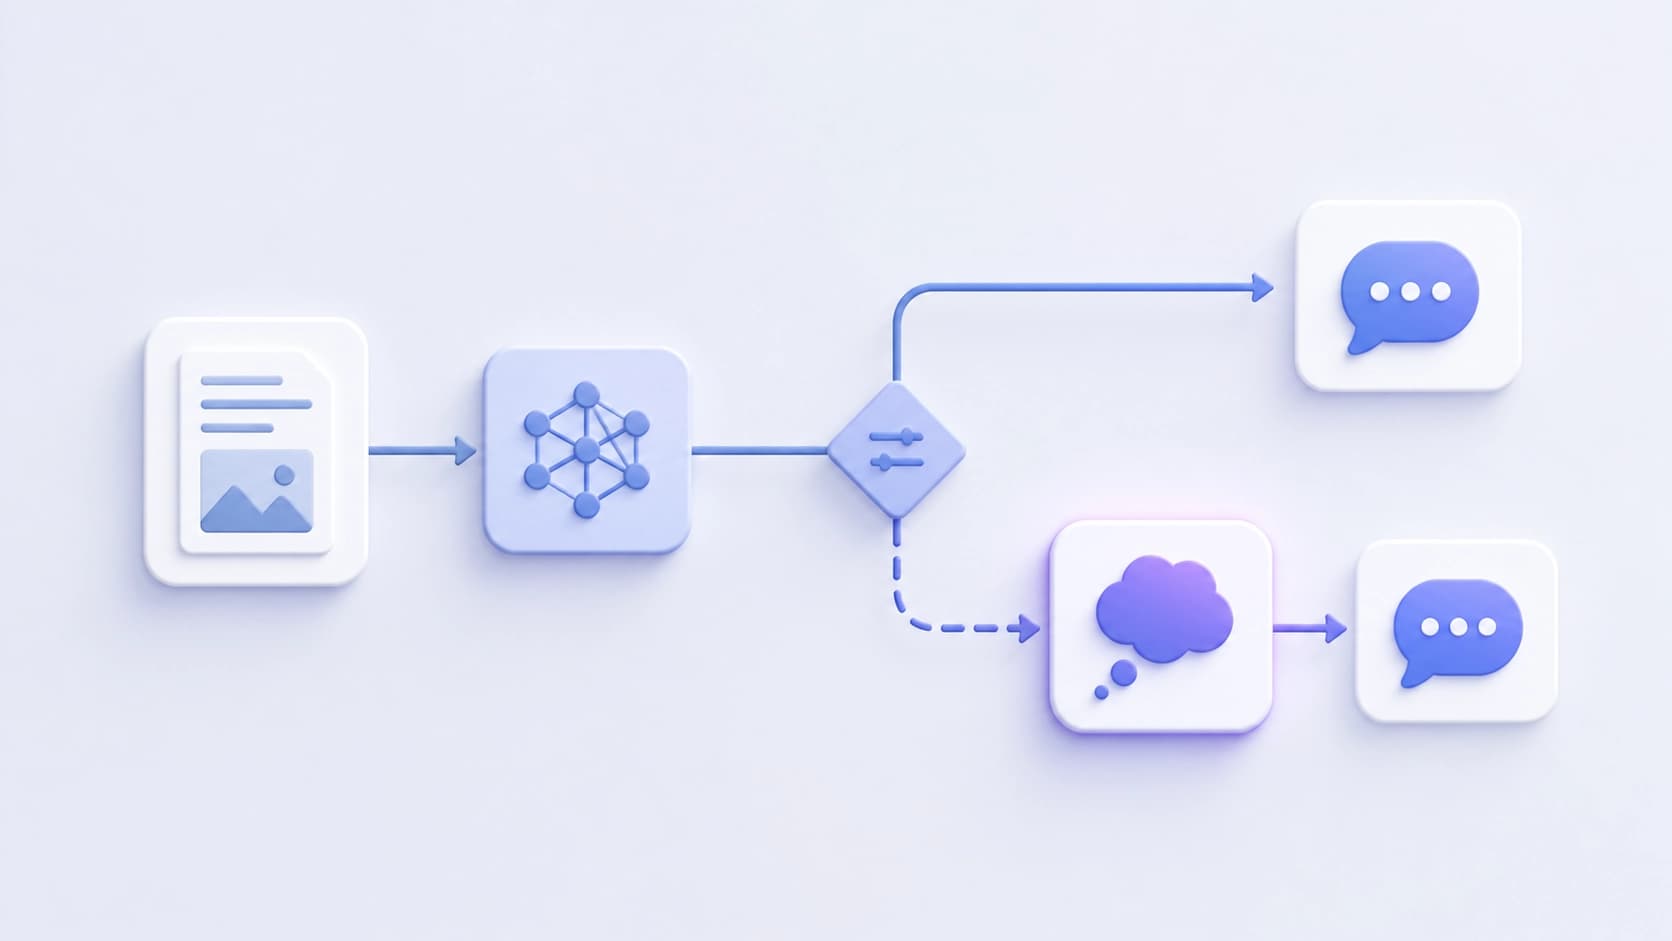
जब संकेत मौजूद है, तो तर्कसंगत है कि उसका सीधे उपयोग किया जाए। लेखक एक ऐसी सुरक्षा प्रस्तावित करते हैं जिसमें मॉडल का रीज़निंग तभी चालू होता है जब प्रोब exposure दर्ज करता है। सरल शब्दों में: डिटेक्टर कम बार और सटीकता से सक्रिय होता है, और महँगी विश्लेषण प्रक्रिया उसके इशारे पर चलती है, हर बार नहीं।
बेंचमार्क AgentDojo की जटिल कॉन्फ़िगरेशनों पर यह तरीका सफल हमलों का अनुपात स्पष्ट रूप से घटाता है — उदाहरण के लिए, Qwen3.5-27B पर 34.6% से शून्य तक। एक महत्वपूर्ण ब्यौरा: "साफ़" टास्कों पर, जहाँ कोई इंजेक्शन नहीं है, यह विधि बुनियादी सुरक्षाओं की तुलना में उपयोगिता बेहतर बनाए रखती है। यही चीज़ आमतौर पर डिटेक्टरों में कमी होती है — वे या तो कम पकड़ते हैं, या हमेशा काम में बाधा डालते हैं।
छिपी हुई अवस्थाएँ शब्दों में क्या "कहती" हैं
काम का तीसरा हिस्सा एक व्याख्यात्मक फ़्रेमवर्क है। लेखक प्राकृतिक भाषा में ऐसी अभिव्यक्तियाँ ढूँढते हैं जो प्रोब के संकेतों से गहरा सहसंबंध रखती हैं। इससे एक तरह के टेक्स्टुअल प्रोफ़ाइल बनते हैं: वे दिखाते हैं कि डिटेक्टर के सक्रिय होने के साथ कौन-से "विचार" चलते हैं।
यहाँ विषमता दिलचस्प है। कुछ मॉडलों में लेटेंट संकेत खतरे की सीधी अनुभूति से मेल खाता है — कुछ ऐसा जैसे "इस टेक्स्ट में ऐसा निर्देश है जो मुझे नहीं दिया गया था"। दूसरों में यह अप्रत्यक्ष परिचालनात्मक संकेतों से जुड़ा होता है: डेटा का असामान्य प्रारूप, संदिग्ध स्रोत, मौजूदा टास्क से टकराव। यानी एक ही डिटेक्टर मॉडल के आधार पर अलग-अलग आंतरिक तंत्रों पर निर्भर हो सकता है।
व्यवहार में इसका क्या मतलब है
जो लोग एजेंटिक सिस्टम बनाते हैं, उनके लिए निष्कर्ष काफ़ी व्यावहारिक हैं:
- कार्रवाई से पहले जाँच संभव है। संकेत जनरेशन में प्रवेश के समय उपलब्ध है — यानी इसे पाइपलाइन में उससे पहले जोड़ा जा सकता है कि एजेंट कोई टूल चलाए।
- रैखिक प्रोब सुरक्षा की एक सस्ती परत है। यह मॉडल के दूसरे पास या हर अनुरोध पर बाहरी क्लासिफ़ायर की तुलना में बेहद हल्की है।
- सिर्फ़ प्रॉम्प्ट पर भरोसा न करें। knowledge-action gap का मतलब है कि "कृपया दस्तावेज़ों के निर्देशों को अनदेखा करें" कोई गारंटी नहीं है, भले ही मॉडल सब समझता हो।
- झूठे सक्रियणों की कीमत गिनें। इस विधि का मुख्य तर्क यह है कि यह साफ़ टास्कों पर काम में बाधा नहीं डालती, और यह अपने ट्रैफ़िक पर जाँचने लायक है।
खुले प्रश्न
लेख "क्या संकेत मौजूद है" इस सवाल का जवाब विश्वसनीय ढंग से देता है, लेकिन कुछ असहज पहलू छोड़ जाता है। छिपी हुई अवस्थाओं पर आधारित डिटेक्टर ख़ुद एक और हमले की सतह है: अगर हमलावर को प्रोब के बारे में पता हो, तो वह इंजेक्शन को इस तरह अनुकूलित कर सकता है कि संकेत पैदा ही न हो। क्रॉस-लिंगुअल स्थिरता की जाँच तो हुई है, लेकिन भाषाई और डोमेन दायरा फिर भी प्रयोगों में शामिल डेटा तक सीमित है।
एक और सवाल है पोर्टेबिलिटी। प्रोब किसी ख़ास मॉडल के लिए प्रशिक्षित होता है: हर आर्किटेक्चर के अपने प्रतिनिधित्व होते हैं, और लेख से ऐसा कोई सार्वभौमिक "सेंसर" नहीं निकलता जिसे बस किसी भी API से जोड़ दिया जाए। सिर्फ़ टेक्स्ट तक पहुँच वाले बंद मॉडलों के लिए यह विधि सिद्धांत रूप से लागू ही नहीं होती — छिपी हुई अवस्थाएँ ज़रूरी हैं।
फिर भी यह दिशा आशाजनक दिखती है। इस बहस के बजाय कि मॉडल निर्देशों का कितनी अच्छी तरह पालन करता है, शोधकर्ता उसकी आंतरिक स्थिति पर नज़र डालने और यह पक्का करने का सुझाव देते हैं कि वहाँ ज़रूरी संकेत पहले से मौजूद है। आगे का सवाल इंजीनियरिंग का है: इस जानकारी को भरोसेमंद तरीके से कार्रवाई में कैसे बदला जाए।


