
ओपन सोर्स में क्या जारी किया गया
"कौन सा मॉडल बेहतर है" — इस बहस में लगभग हमेशा एक ही समस्या आती है: आंकड़े किसी ने जाँचे ही नहीं। मापन अलग मशीन पर, अलग क्वांटाइज़ेशन में, रनटाइम के अलग बिल्ड में किए जाते हैं — और उनकी आपस में तुलना करना निरर्थक है। कंपनी Liquid AI ने इसे खुलापन और पुनरुत्पादकता से ठीक करने का प्रस्ताव रखा: उसने Pipette जारी किया, जो एज-डिवाइस पर फ़ाउंडेशनल मॉडल्स की बेंचमार्किंग के लिए एक प्लेटफ़ॉर्म है। इस पद्धति को Artificial Analysis ने स्वतंत्र रूप से मान्य किया।
पूरी संरचना जिस मुख्य विचार पर टिकी है: डिवाइस पर व्यवहार तैनात सिस्टम का गुण है, न कि अलग-थलग मॉडल का। यानी माप की इकाई भी "मॉडल" नहीं, बल्कि पूरा कॉन्फ़िगरेशन होना चाहिए: वेट्स प्लस क्वांटाइज़ेशन स्कीम प्लस रनटाइम एनवायरनमेंट प्लस ठोस हार्डवेयर। इसी थीसिस से डेटासेट की संरचना भी निकलती है, और नीचे दी गई सभी तुलनाओं को पढ़ने का तरीका भी।
शुरुआती डेटासेट में क्या शामिल हुआ
- डिवाइस पर प्रदर्शन के पाँच मेट्रिक्स;
- मॉडल × क्वांटाइज़ेशन × रनटाइम एनवायरनमेंट × डिवाइस × कॉन्टेक्स्ट लंबाई के संयोजन में एक हज़ार से अधिक कॉन्फ़िगरेशन;
- 30 से अधिक मॉडल और कई क्वांटाइज़ेशन फ़ॉर्मैट;
- macOS, iOS, Windows और Android के लिए llama.cpp के बिल्ड;
- 256 से 8 192 टोकन तक की कॉन्टेक्स्ट लंबाई।
पहले प्रकाशित मापन MacBook Pro (M5 Max), iPhone 17 Pro और Galaxy S26 Ultra पर किए गए। AMD Ryzen AI Max+ 395 और Radeon 8060S के नतीजे अभी "coming soon" के रूप में चिह्नित हैं — यानी प्लेटफ़ॉर्म शुरू से ही क्रॉस-प्लेटफ़ॉर्म घोषित है, लेकिन हार्डवेयर कवरेज अभी बढ़ रहा है।
पहले रनों से चार निष्कर्ष
समान पैरामीटर — लंबे कॉन्टेक्स्ट पर अलग व्यवहार
यह अच्छी तरह दिखाता है कि ऐसा मापन आख़िर क्यों ज़रूरी है। 350M पैरामीटर वाले दो मॉडल, एक ही Q4_K_M पर, एक ही फ़ोन पर, इनपुट टोकन बढ़ने पर अलग-अलग व्यवहार करते हैं: Granite-4.0-H-350M, 256 से 4 096 इनपुट टोकन पर जाने पर डिकोडिंग थ्रूपुट का 78.4% बनाए रखता है, जबकि Granite-4.0-350M — केवल 33.8%। पैरामीटर की संख्या यहाँ कुछ नहीं बताती: अंतर आर्किटेक्चर में है और इसमें कि वह किसी ख़ास रनटाइम और चिप पर कैसे बैठता है।
स्पार्स एक्टिवेशन गणना बचाता है, पर मेमोरी नहीं
उसी फ़ोन पर 2 048 इनपुट टोकन पर LFM2.5-8B-A1B, Qwen3.5-4B से 2.4 गुना तेज़ डिकोड करता है, और Ministral-3-3B-Instruct-2512 से 2.6 गुना तेज़। राज़ स्पार्स एक्टिवेशन में है: हर टोकन पर 8.5B पैरामीटर में से लगभग 1.5B इस्तेमाल होते हैं। लेकिन पीक मेमोरी खपत फिर भी 5.29 GiB है, क्योंकि सभी एक्सपर्ट वेट्स को आख़िर पूरा मेमोरी में रहना ही है। व्यावहारिक निष्कर्ष: MoE जैसी आर्किटेक्चर समय बचाती हैं, पर RAM बजट नहीं बचातीं — और फ़ोन पर सीमा अक्सर मेमोरी पर ही अटकती है।
तेज़ होना — बेहतर होना नहीं है
iPhone 17 Pro पर Q4_K_M में MiniCPM5-1B, 2 048 इनपुट / 256 आउटपुट टोकन का वर्कलोड 3.47 सेकंड में पूरा करता है, जबकि LFM2.5-1.2B-Instruct — 4.12 सेकंड में, यानी पहला 15.8% तेज़ है। लेकिन उन्हीं आर्टिफ़ैक्ट्स पर LFM, MATH-500 पर 9.0 अंक अधिक हासिल करता है। थ्रूपुट और गुणवत्ता अलग-अलग अक्ष हैं, और तालिका में एक आंकड़े के आधार पर मॉडल चुनना निरर्थक है।
लगभग समान सिस्टम प्रोफ़ाइल कार्यों पर उलटफेर छिपा सकती हैं
M5 Max पर Q4_K_M और 2 048 इनपुट टोकन पर Granite-4.1-8B और Ministral-3-8B-Instruct-2512, डिकोडिंग थ्रूपुट में केवल 2.4% और पीक RAM में 1.2% भर अलग हैं। लेकिन कार्यों पर तस्वीर बदल जाती है: Granite, IFBench पर 7.3 अंक जीतता है, जबकि Ministral, GPQA Diamond पर उससे 14.0 अंक आगे निकल जाता है। "हार्डवेयर" प्रोफ़ाइल में अंतर शोर की सीमा में है, व्यवहार में अंतर बुनियादी है।
मापन कैसे बनाए गए हैं
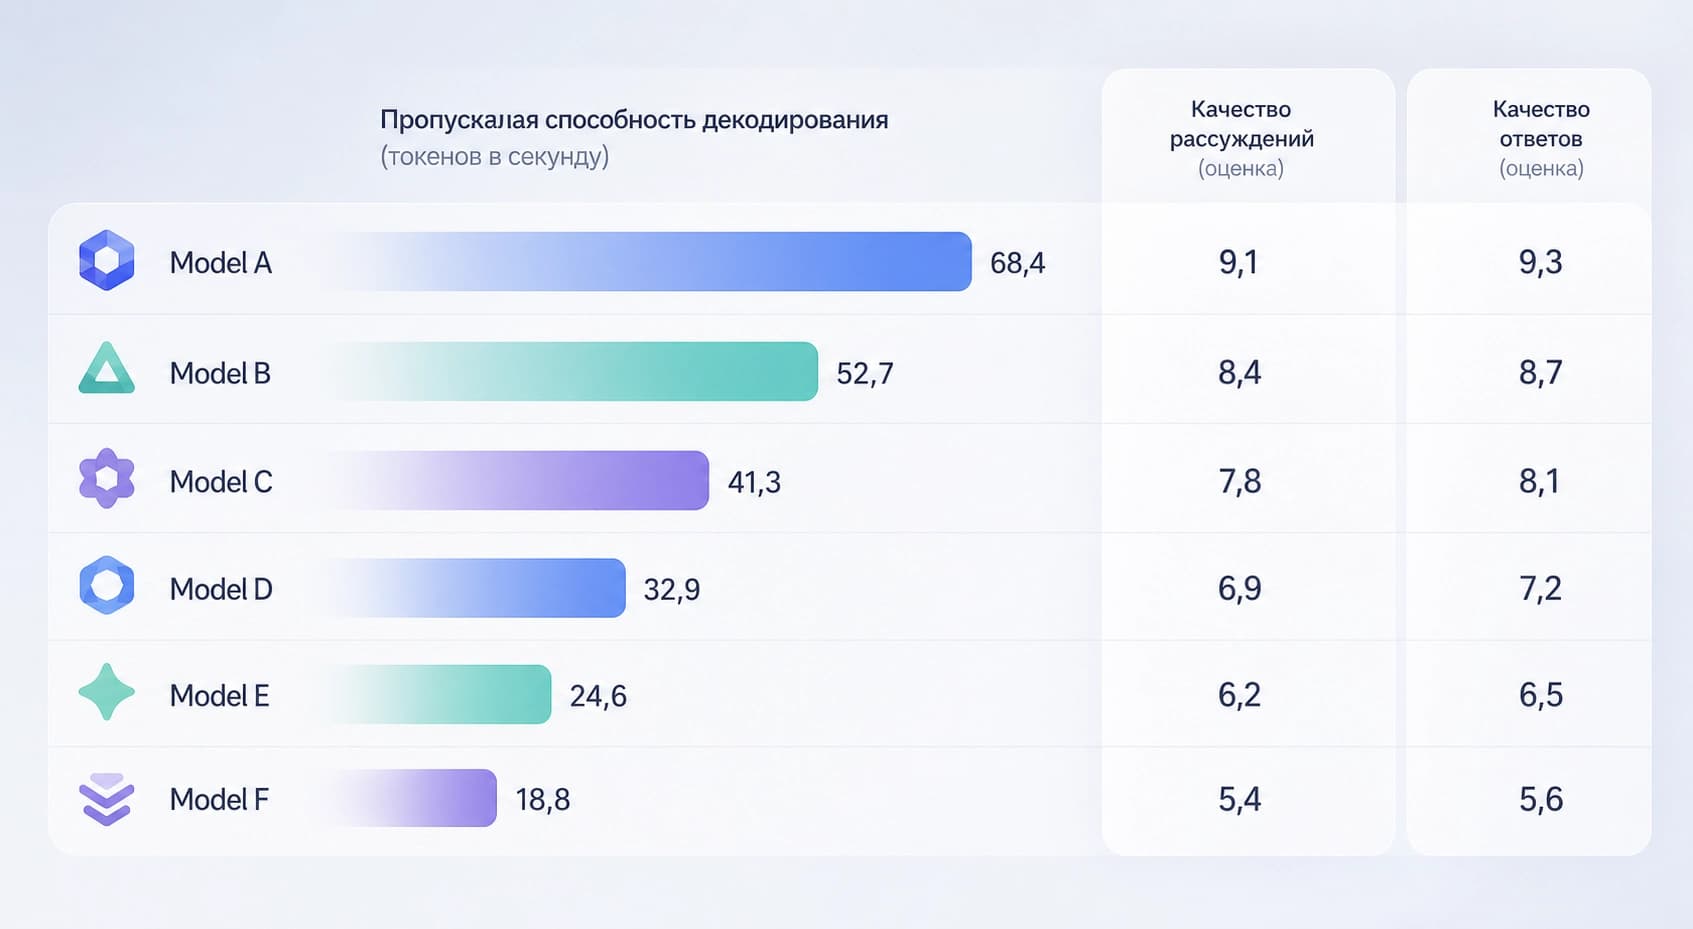
प्रदर्शन के रन निश्चित टोकन फ़ॉर्म, ग्रीडी डिकोडिंग, छोड़े जाने वाले वॉर्मअप और पाँच मापे जाने वाले दोहरावों पर आधारित हैं। हर दोहराव से पहले readiness gating चलता है: प्लेटफ़ॉर्म-विशिष्ट जाँच यह सुनिश्चित करती है कि थर्मल स्थितियाँ और बैकग्राउंड लोड सामान्य के अनुरूप हैं। असफल रन प्रकाशन में नहीं आते — यही वह चीज़ है जो पुनरुत्पादक बेंचमार्क को एकबारगी स्क्रिप्ट से अलग करती है।
गुणवत्ता एक अलग कहानी है। इसे उसी रन से नहीं मापा जाता: इसके लिए IFBench, GPQA Diamond और MATH-500 इस्तेमाल होते हैं, और स्कोर NVIDIA H100 80GB वाले रेफ़रेंस सिस्टम पर llama.cpp के इवैल्यूएशन रन से लिए जाते हैं। फिर उनकी तुलना उसी मॉडल और उसी क्वांटाइज़ेशन के डिवाइस-रन से की जाती है। एक ज़रूरी नतीजा: फ़ोन के थ्रूपुट के बग़ल में लिखा गुणवत्ता का आंकड़ा फ़ोन पर नहीं निकाला गया है। यह मॉडलों की आपसी तुलना के लिए सुविधाजनक मेट्रिक है, पर यह नहीं मापता कि किसी ख़ास स्मार्टफ़ोन पर क्या हो रहा है।
ओपन सोर्स में असल में क्या दिया जा रहा है
Pipette पूरी तरह उपलब्ध है, बिना किसी वेटलिस्ट के:
- Apache 2.0 के तहत इन्फ़्रास्ट्रक्चर — pipette-mgmt, pipette-clients और pipette-scores रिपॉज़िटरी;
- नतीजों का सार्वजनिक डेटासेट;
- होस्ट किया गया डैशबोर्ड;
- iOS और Android के लिए नेटिव बेंचमार्किंग ऐप्स।
एकमात्र हिस्सा जो अभी सार्वजनिक पहुँच के लिए तैयार नहीं है, वह समुदाय द्वारा भेजे गए नतीजों का प्रकाशन है: यह बीटा में है। बाक़ी सब कुछ ख़ुद चलाया जा सकता है, जिसमें अपने परिमाप के भीतर पाइपलाइन तैनात करना भी शामिल है।
यह किसे और क्यों चाहिए
लक्षित दर्शकों को सबसे आसानी से ऐसे बताया जा सकता है: यह कोई भी टीम है जो किसी ऐसे हार्डवेयर पर मॉडल जारी करती है जिसका वह ख़ुद मालिक नहीं है। आगे विकल्प पैमाने के हिसाब से अलग हो जाते हैं।
- सोलो डेवलपर और सीड-स्टेज स्टार्टअप के लिए डैशबोर्ड और मोबाइल ऐप्स काफ़ी हैं — अपने इन्फ़्रास्ट्रक्चर की ज़रूरत नहीं।
- मध्यम आकार की प्रोडक्ट टीम अपने आंतरिक डिवाइस पूल पर क्लाइंट तैनात कर सकती है और अपने कॉन्फ़िगरेशन पर मापन पा सकती है।
- बड़े OEM, चिप निर्माता और उद्यम पूरी पाइपलाइन फ़ायरवॉल के पीछे रख सकते हैं — जिससे यह सवाल ही नहीं उठता कि मापन का डेटा कहाँ जाता है।
आम कार्य भी बिना ज़्यादा समझाए स्पष्ट हैं: स्प्रिंट के कार्य तय होने से पहले मॉडल और क्वांटाइज़ेशन फ़ॉर्मैट चुनना; SoC या उपकरण की ख़रीद को उचित ठहराना; रनटाइम, OS या ड्राइवर के अपडेट पर रिग्रेशन पकड़ना; कॉन्टेक्स्ट लंबाई के हिसाब से क्षमता की योजना बनाना; विक्रेताओं के विज्ञापनी दावों को स्वतंत्र रूप से जाँचना। उद्योग — उपभोक्ता इलेक्ट्रॉनिक्स और स्मार्टफ़ोन OEM, ऑटोमोटिव क्षेत्र, विनिर्माण और रोबोटिक्स, मेडिकल डिवाइस, वित्तीय सेवाएँ, रक्षा: हर वह जगह जहाँ लेटेंसी, निजता या कनेक्टिविटी की अनुपस्थिति मॉडल को सीधे डिवाइस पर चलाने को मजबूर करती है।
आंकड़ों पर भरोसा करने से पहले किन बातों पर ध्यान दें
तीन बातें, जो मापन की किसी भी तालिका को पढ़ते समय आसानी से भुला दी जाती हैं।
पहली, गुणवत्ता के आंकड़े और प्रदर्शन के आंकड़े अलग-अलग जगहों से आते हैं। थ्रूपुट डिवाइस पर मापा गया है, गुणवत्ता — H100 वाले रेफ़रेंस सिस्टम पर और फिर तुलना की गई। मॉडलों की तुलना के लिए यह सही है, किसी ख़ास ऐप में व्यवहार के अनुमान के लिए — नहीं।
दूसरी, क्वांटाइज़ेशन को कोष्ठक से बाहर नहीं रखा जा सकता। एक ही फ़ॉर्मैट अलग-अलग मॉडलों और अलग-अलग रनटाइम पर अलग नतीजा देता है, और मेमोरी की सीमा अक्सर निर्णायक बन जाती है — जैसे स्पार्स एक्टिवेशन के उदाहरण में, जहाँ गति बढ़ी, पर 5.29 GiB कहीं नहीं गए।
तीसरी, समान प्रदर्शन यह नहीं बताता कि मॉडल ख़ास कार्यों में कैसा प्रदर्शन करेंगे। लगभग समान सिस्टम प्रोफ़ाइल पर IFBench और GPQA Diamond में Granite और Ministral का उलटफेर — ठीक वही मामला है जब पहले कार्य तय करना चाहिए और उसके बाद ही तालिकाओं पर नज़र डालनी चाहिए।


