
OpenAI का वादा: इसका Jalapeño चिप प्रतिस्पर्धियों के समाधानों से तेज़ और अधिक किफायती होगा
कंपनी का दावा है कि Broadcom के साथ विकसित इन्फरेंस प्रोसेसर, कई AI मॉडलों पर परीक्षणों में ऊर्जा दक्षता और प्रतिक्रिया गति के मामले में Nvidia के एक्सेलेरेटर से बेहतर प्रदर्शन करता है। चिप्स को इस साल के अंत तक कम मात्रा में तैनात करने की योजना है, लेकिन Nvidia के बेड़े को पूरी तरह से बदलने का इरादा नहीं है।
OpenAI जलापेनो चिप पर दांव लगा रहा है: तेज़, अधिक किफ़ायती और लगभग बिक्री के लिए तैयार
जब बड़े भाषा मॉडल को तैनात करने की बात आती है, तो इंजीनियरों को लगातार एक समझौता करना पड़ता है: या तो सिस्टम बहुत तेज़ी से जवाब देता है, लेकिन अनुरोधों की धारा को शायद ही झेल पाता है, या फिर वह भारी लोड को पचाने में सक्षम होता है, लेकिन ध्यान देने योग्य देरी की कीमत पर। OpenAI को भरोसा है कि उन्होंने एक ऐसा समाधान ढूंढ लिया है जो इस विरोधाभास को दूर करता है। कंपनी की अपनी चिप, जिसका नाम Jalapeño रखा गया है, डेवलपर्स के अनुसार, एक साथ कम विलंबता और उच्च थ्रूपुट दोनों प्रदर्शित करती है। OpenAI के हार्डवेयर के उपाध्यक्ष रिचर्ड हो के अनुसार, यह नवीनता "दोनों दुनिया का सर्वश्रेष्ठ" प्रदान करती है।
Jalapeño एक सार्वभौमिक प्रोसेसर नहीं है, बल्कि एक कस्टम इंटीग्रेटेड सर्किट (ASIC) है, जिसे Broadcom के साथ साझेदारी में बनाया गया है। चिप एक विशिष्ट कार्य के लिए तैयार की गई है — इन्फ्रेंस, यानी कार्यों को करने और एजेंटों के काम करने के लिए प्रशिक्षित मॉडल का सीधा संचालन। जून में ही घोषित, अब इसे पहली बार आधिकारिक परीक्षण परिणाम मिले हैं, जिन्हें कंपनी क्रांतिकारी कहने में संकोच नहीं कर रही है।
प्रदर्शन परीक्षणों ने क्या दिखाया
चिप की क्षमताओं का आकलन करने के लिए, OpenAI ने अपने स्वयं के बेंचमार्क प्लेटफ़ॉर्म InferenceX का उपयोग किया। तुलना के लिए एक मानक के रूप में, Nvidia GB200 और GB300 सुपरचिप्स पर सर्वोत्तम दर्ज परिणाम लिए गए। परीक्षण तीन लोकप्रिय मॉडलों पर किए गए: GPT-OSS 120B, DeepSeek R1 और Kimi K2.5 1T।
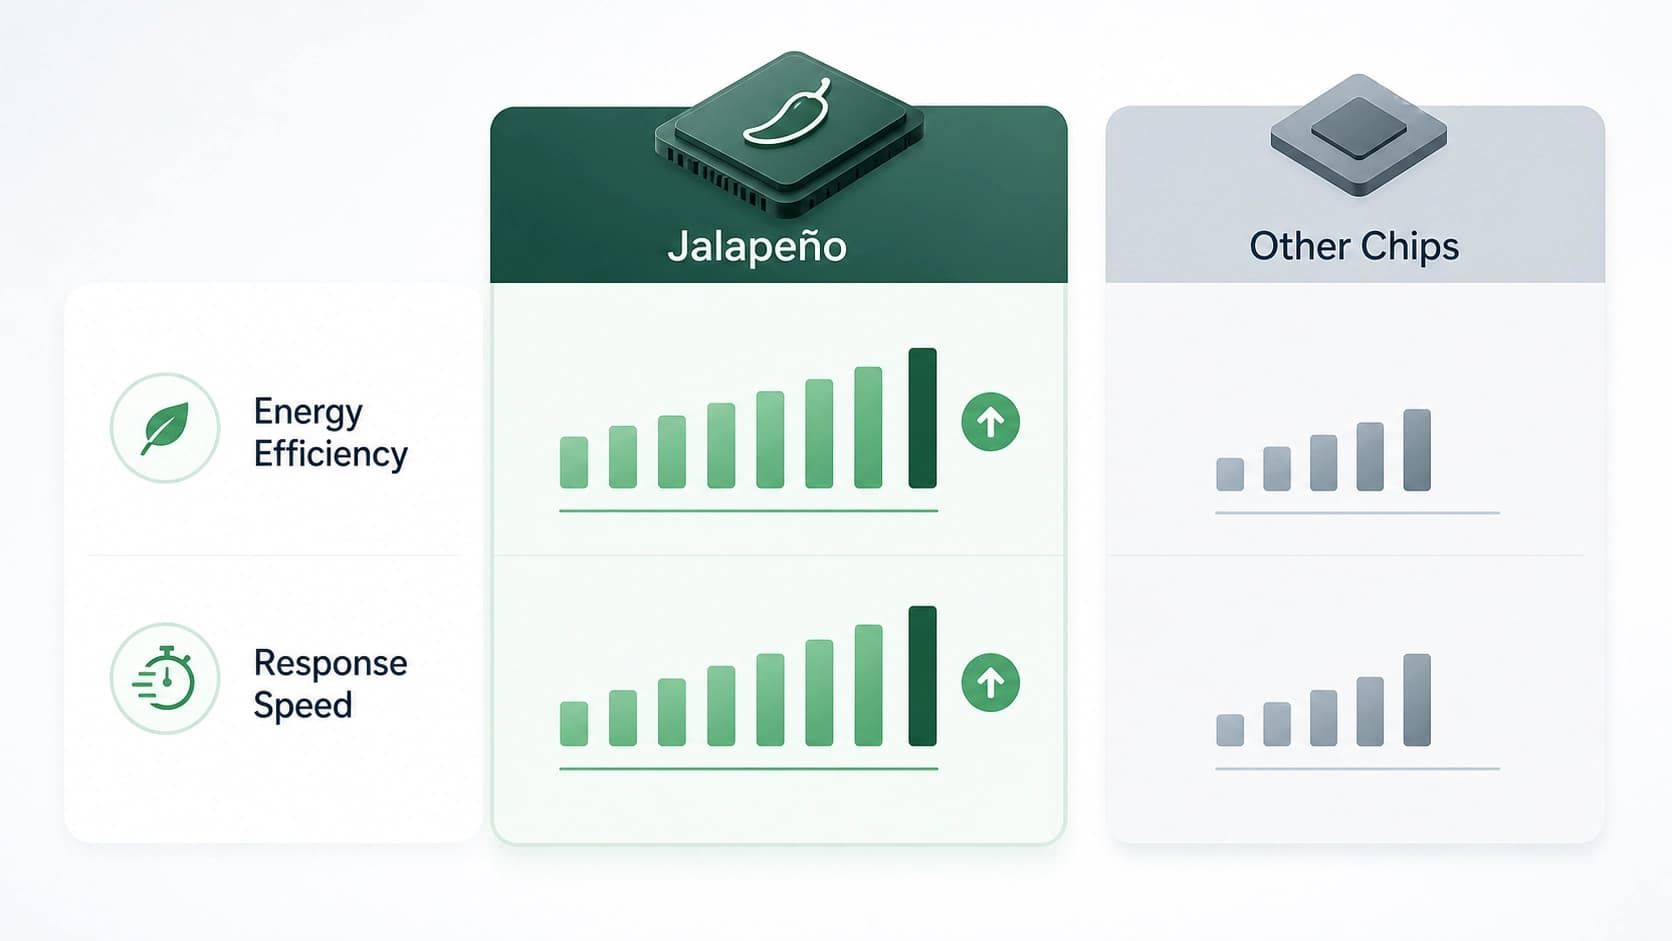
कंपनी का दावा है कि परिणाम प्रभावशाली रहे हैं। मॉडल के आधार पर, Jalapeño ने प्रतिस्पर्धियों की प्रणालियों की तुलना में प्रति वाट 1.5–1.9 गुना अधिक गणना प्रदर्शित की। सीधे शब्दों में कहें तो, इसका मतलब है कि खर्च की गई प्रत्येक किलोवाट ऊर्जा के लिए, नई चिप काफी अधिक उपयोगी कार्य करती है। यह उस युग में महत्वपूर्ण है जब डेटा सेंटरों के लिए बिजली के बिल खर्च की मुख्य मदों में से एक बन रहे हैं।
प्रतिक्रिया की गति में अंतर और भी अधिक ध्यान देने योग्य है। तीन परीक्षण किए गए मॉडलों पर एंड-टू-एंड विलंबता, Nvidia चिप्स पर आधारित संदर्भ प्रणालियों की तुलना में 1.7–3.6 गुना कम पाई गई। व्यवहार में, यह सहायकों के तेज़ उत्तर, AI एजेंटों के अधिक उत्तरदायी कार्यों और पीक लोड के दौरान भी सेवाओं तक स्थिर पहुंच के रूप में व्यक्त होता है। मॉडल जितनी तेज़ी से अनुरोध संसाधित करता है, उपयोगकर्ता को उत्तर के "टाइपिंग" संकेतक को उतना ही कम देखना पड़ता है।
रणनीति: प्रतिस्थापन नहीं, बल्कि पूरक
इतने उत्साहजनक आंकड़ों के बावजूद, OpenAI Nvidia के साथ सहयोग छोड़ने का इरादा नहीं रखता है। रिचर्ड हो जोर देकर कहते हैं कि कंपनी की समग्र कंप्यूटिंग रणनीति में भागीदारों की एक विस्तृत श्रृंखला का उपयोग शामिल है, और Nvidia प्रमुख भागीदारों में से एक बना हुआ है। Jalapeño मौजूदा चिप्स के बेड़े को प्रतिस्थापित नहीं करेगा, बल्कि बुनियादी ढांचे के विस्तार का एक महत्वपूर्ण तत्व बन जाएगा।
चिप की पहली पीढ़ी को चालू वर्ष के अंत तक "छोटी मात्रा में" तैनात करने की योजना है। पूर्ण पैमाने पर क्षमता विस्तार 2027 में शुरू होगा। कंपनी जानबूझकर अगले वर्ष उपयोग करने की योजना बनाई गई चिप्स की सटीक संख्या का खुलासा नहीं करती है। साथ ही, Jalapeño की दूसरी और तीसरी पीढ़ी पर काम पहले से ही चल रहा है, जो इस दिशा की दीर्घकालिक प्रकृति को दर्शाता है — कई प्रयोगों के विपरीत जो व्यावहारिक चरण तक कभी नहीं पहुंचते।
इस परियोजना की सफलता बड़े AI मॉडल संचालकों की चिप आपूर्तिकर्ताओं की सीमित संख्या पर निर्भरता को काफी कम कर सकती है। स्वयं के ASIC, OpenAI के विशिष्ट एल्गोरिदम और कार्यभार के अनुसार आर्किटेक्चर को अधिक सटीक रूप से ढालने की अनुमति देते हैं, जिससे संसाधनों की बचत होती है और बाजार में नए उत्पादों को लाने में तेजी आती है।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री
RL सिम्युलेटरों की विफलताओं के निदान में कैनोनिकल बहुपद अपरिवर्तांक: वे वास्तव में कहाँ उपयोगी हैं
यह अध्ययन जाँचता है कि क्या सीखने योग्य गतिशीलता मॉडल में भौतिक नियमों को शामिल करना उचित है: प्रक्षेप पथों से निकाले गए और ग्रोबनर आधारों के माध्यम से विहित रूप में लाए गए अपरिवर्तक पूर्वानुमानों में मामूली सुधार देते हैं, लेकिन निदान में प्रभावी साबित होते हैं—वे उल्लंघित बाधा का स्थान निर्धारित करने और विशिष्ट गलत पैरामीटर की पहचान करने में सक्षम बनाते हैं।
10 नवम्बर 2026
AURA-Eval: कैसे जाँचें कि LLM एजेंट ने जोखिम को पहचाना और अगला कदम बदल दियाેણ
यह फ्रेमवर्क LLM एजेंटों के व्यवहार का आकलन अंतिम निर्णय के आधार पर नहीं, बल्कि अहम बिंदुओं पर जोखिम के प्रति उनकी प्रतिक्रिया के आधार पर करता है: टूल-कॉल की ट्रैजेक्टरी बीच में रोक दी जाती हैं, जिसके बाद मॉडल को अपना तर्क और कार्रवाई जारी रखनी होती है, जबकि LLM जजों का एक पैनल जोखिम की पहचान, कदम की प्रकृति और उसकी सुरक्षा का विश्लेषण करता है। R-Judge की 157 ट्रैजेक्टरी से संकलित 1249 कार्यों में, 20 मॉडलों में सुरक्षित रास्ता न होने पर असुरक्षित कार्रवाइयाँ बढ़ जाती हैं, और निष्पादन से पहले निगरानी हटाने पर शुरुआत में सुरक्षित रहे 52,3% मामले असुरक्षित हो जाते हैं।
10 नवम्बर 2026
चेर्न–साइमन रिज़र्वॉयर की स्मृति: संयोजकता की स्वायत्त गतिशीलता और घनत्व का परिवहन
यह लेख बताता है कि रिज़र्वॉयर इनपुट संकेतों का इतिहास घनत्व वितरण और ज्यामितीय स्वतंत्रता की डिग्रियों—दोनों में कैसे बनाए रखता है। चार तंत्रों की तुलना से पता चलता है कि धारा एक अलग संयोजकता घटक बनाती है, जो घनत्व की बाद की प्रतिक्रिया को बदलती है, जबकि सभी मापे गए लक्षणों को शामिल करने से पल्स के क्रम को डिकोड करने में थोड़ा सुधार होता है।
10 नवम्बर 2026