
मोलेक्युलर विज्ञान को लंबे समय से AI के लिए सबसे आशाजनक — और सबसे जटिल — क्षेत्रों में से एक माना जाता है। इसी विषय को समर्पित है arXiv प्रीप्रिंट arXiv:2608.23104 «Molecular LLM Agents: From Architectural Design to Scientific Autonomy»: 25 पृष्ठ, श्रेणियाँ cs.CL और cs.AI, 24 अगस्त 2026 का संस्करण v1 और 25 अगस्त का परिष्कृत संस्करण v2। लेखकों की टीम में Jiatong Li, Wengyu Zhang, Weida Wang, Yuxuan Ren, Wei Liu, Chenyang Mao, Yuqiang Li, Yatao Bian, Changmeng Zheng, Xiaoyong Wei और Qing Li शामिल हैं। यह काम बेंचमार्क पर एक और रिकॉर्ड के लिए नहीं, बल्कि शब्दावली में व्यवस्था लाने की कोशिश के लिए दिलचस्प है: आखिर मोलेक्युलर एजेंट किसे माना जाए, वह किन घटकों से बनता है और कितना स्वतंत्र रूप से कार्य कर सकता है।
मोलेक्युलर एजेंट «सामान्य» से कैसे अलग है
बातचीत करने वाले सहायक और कोड एजेंट टेक्स्ट, रिपॉज़िटरी और वेब पेजों की दुनिया में रहते हैं। जिन उपकरणों से वे काम करते हैं, वे लगभग हमेशा ऐसा कुछ लेते और लौटाते हैं जिसे आँखों से पढ़ा जा सके। रसायन विज्ञान के साथ यह तरकीब नहीं चलती: अणु कोई अनुच्छेद नहीं है।
डोमेन एजेंट को एक साथ कई असंगत प्रकार के डेटा से निपटना पड़ता है:
- प्रतीकात्मक नोटेशन जैसे SMILES — संक्षिप्त स्ट्रिंग्स, जहाँ एक गलत अक्षर दवा के उम्मीदवार को किसी दूसरे पदार्थ में बदल देता है;
- मोलेक्युलर ग्राफ, जहाँ केवल परमाणु ही नहीं, बल्कि बंधनों का क्रम, आवेश और स्टीरियोकेमिस्ट्री भी मायने रखती है;
- त्रिआयामी कॉन्फ़ॉर्मेशन — क्योंकि अणु के गुण उसकी आकृति से तय होते हैं, केवल सूत्र से नहीं;
- स्पेक्ट्रा और सिमुलेशन के परिणाम — लंबी संख्यात्मक श्रृंखलाएँ, जिनसे अर्थ निकालना होता है;
- «वेट» लैब से मापन, यानी किसी फ़ाइल के नहीं, बल्कि वास्तविक पदार्थ के साथ किए गए प्रयोगों का डेटा।
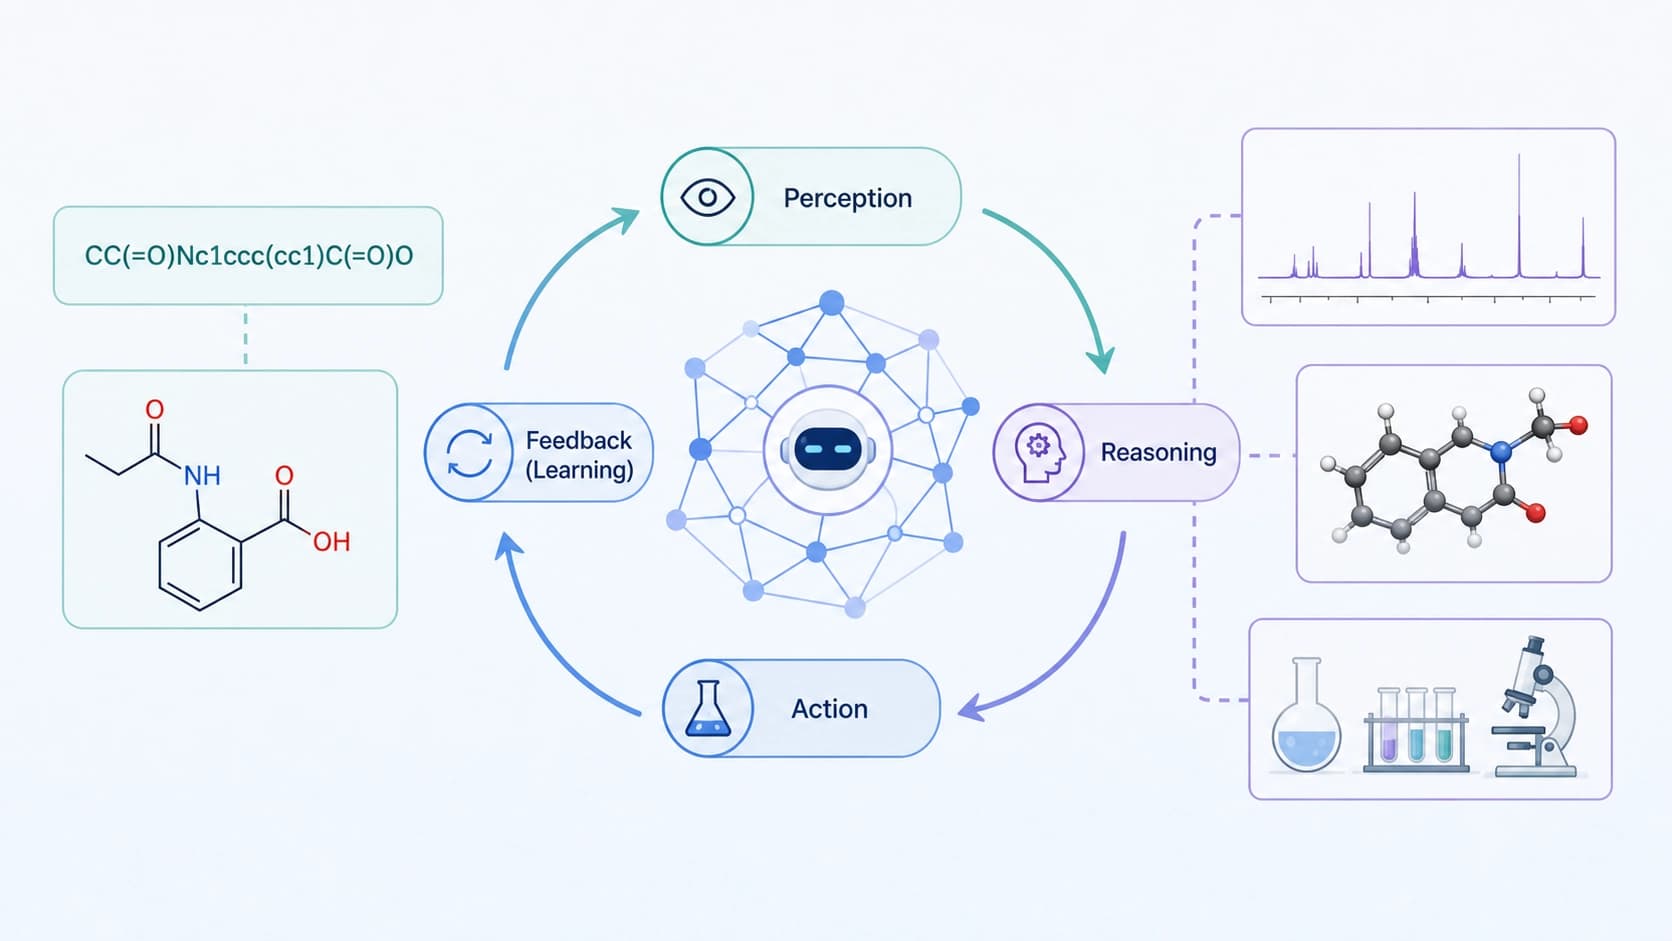
यहीं से लेखकों का मुख्य विचार निकलता है: ऐसे एजेंट की क्षमताएँ किसी एक सफल मॉडल से नहीं, बल्कि एक साथ कई आधारों से बनती हैं। रासायनिक रूप से सही मोलेक्युलर ऑब्जेक्ट की समझ, केंद्र में भाषा मॉडल वाला एजेंटिक फ्रेमवर्क, किसी विशिष्ट विषय-क्षेत्र से जुड़े उपकरण, और साथ ही एक फ़ीडबैक चैनल — चाहे कम्प्यूटेशनल हो या प्रायोगिक। इसके ऊपर योजना बनाने और सही समय पर ज़रूरी उपकरण调用 करने का कौशल आता है।
आर्किटेक्चरल दृष्टिकोण: मोलेक्युलर एजेंट किन चीज़ों से बनाया जाता है
लेख के दो दृष्टिकोणों में से पहला इंजीनियरिंग का है। लेखक इस संरचना को चार परतों में बाँटते हैं और सुझाव देते हैं कि किसी भी मौजूदा प्रोजेक्ट को ठीक इसी तरह देखा जाए।
बोध: अणु एक वस्तु के रूप में, अनुच्छेद के रूप में नहीं
भाषा मॉडल टेक्स्ट पर प्रशिक्षित होते हैं, इसलिए शुरू में वे SMILES स्ट्रिंग को टोकन के समूह के रूप में देखते हैं और आसानी से ऐसी संयोजकताएँ «हैलुसिनेट» कर देते हैं जो अस्तित्व में ही नहीं हैं। यहाँ डोमेन मॉडलों के साथ जोड़ मदद करता है: उदाहरण के लिए, AlphaFold दिखाता है कि कैसे एक विशेषीकृत आर्किटेक्चर किसी संकीर्ण मोलेक्युलर समस्या को सार्वभौमिक की तुलना में अधिक सटीकता से हल करता है। एजेंट के लिए इसका सीधा अर्थ है: तर्क करने से पहले उसे सत्यापन करना आना चाहिए — जाँचना कि अणु वास्तव में मौजूद है या नहीं, उसका ग्राफ सूत्र से मेल खाता है या नहीं, और फ़ॉर्मेट के बीच अनुवाद में स्टीरियोकेमिस्ट्री खो तो नहीं गई।
फ्रेमवर्क, टूलबॉक्स और प्रशिक्षण
दूसरी और तीसरी परत «दिमाग» और «हाथ» हैं। भाषा मॉडल योजना बनाता है और तय करता है कि कौन-सी गणना चलानी है; डोमेन टूलबॉक्स उसे डॉकिंग, क्वांटम-रासायनिक गणना, डेटाबेस में खोज और गुणों की भविष्यवाणी देता है। ऐसी ही सोच का अच्छा उदाहरण है ChemCrow एजेंट: वहाँ मूल्य स्वयं मॉडल नहीं, बल्कि सावधानी से वर्णित वे उपकरण बनाते हैं जिन्हें वह调用 करता है।
चौथी परत है प्रशिक्षण और अनुकूलन। एजेंट को सफल समाधानों के प्रक्षेपपथों पर फ़ाइन-ट्यून किया जा सकता है, या फिर केवल उपकरणों के विवरण और उन्हें चुनने की रणनीति को बेहतर बनाया जा सकता है। दूसरा रास्ता सस्ता है, और लेखक स्पष्ट संकेत देते हैं: इस क्षेत्र में आधी विफलताएँ कमज़ोर मॉडल की नहीं, बल्कि खराब तरीके से डिज़ाइन किए गए फ़ीडबैक लूप की होती हैं।
वैज्ञानिक स्वायत्तता की सीढ़ी: L1–L4
लेख का दूसरा दृष्टिकोण वही «स्वायत्तता की सीढ़ी» है, जो इंजीनियरिंग प्रणालियों में स्तरों के तर्क से ली गई है। इसकी ज़रूरत इसलिए है ताकि अमूर्त रूप से यह बहस न हो कि «एजेंट स्मार्ट है या नहीं», बल्कि यह समझा जाए कि वह वास्तव में कितने निर्णय अपने ऊपर लेता है।
L1 — निश्चित परिदृश्य वाला सहायक
यहाँ मनुष्य चरणों का क्रम तय करता है, और मॉडल अलग-अलग कार्य करता है: संरचना का अनुवाद करना, डिस्क्रिप्टर गिनना, विकल्प सुझाना। स्वायत्तता लगभग शून्य है, लेकिन पूर्वानुमेयता अधिकतम।
L2 — अनुकूली कम्प्यूटेशनल एजेंट
एजेंट स्वयं तय करता है कि कौन-सा उपकरण कब और किस क्रम में调用 करना है, त्रुटि होने पर योजना बदलता है, और पूरी तरह डिजिटल परिपथ में काम करता है। यह आज का मुख्यधारा है: जोखिम खराब गणना तक सीमित रहता है, खराब नमूने तक नहीं।
L3 — वास्तविक प्रयोगों के परिणामों को ध्यान में रखने वाला एजेंट
सबसे दिलचस्प और सबसे जोखिम भरा स्तर। एजेंट केवल योजना नहीं बनाता, बल्कि भौतिक प्रयोगशाला से फ़ीडबैक भी प्राप्त करता है — स्पेक्ट्रा, क्रोमैटोग्राम, संश्लेषण का डेटा — और उसके आधार पर अपनी योजना सुधारता है। इस श्रेणी की प्रणालियों के उदाहरण मौजूद हैं: Coscientist ने प्रयोगशाला ऑटोमेशन की मदद से संश्लेषण की योजना बनाना प्रदर्शित किया था। लेकिन ठीक यहीं त्रुटि की कीमत अमूर्त रहना बंद कर देती है: गलत कदम अभिकर्मकों, उपकरण के समय और, सबसे बुरी स्थिति में, लोगों की सुरक्षा को खर्च करता है।
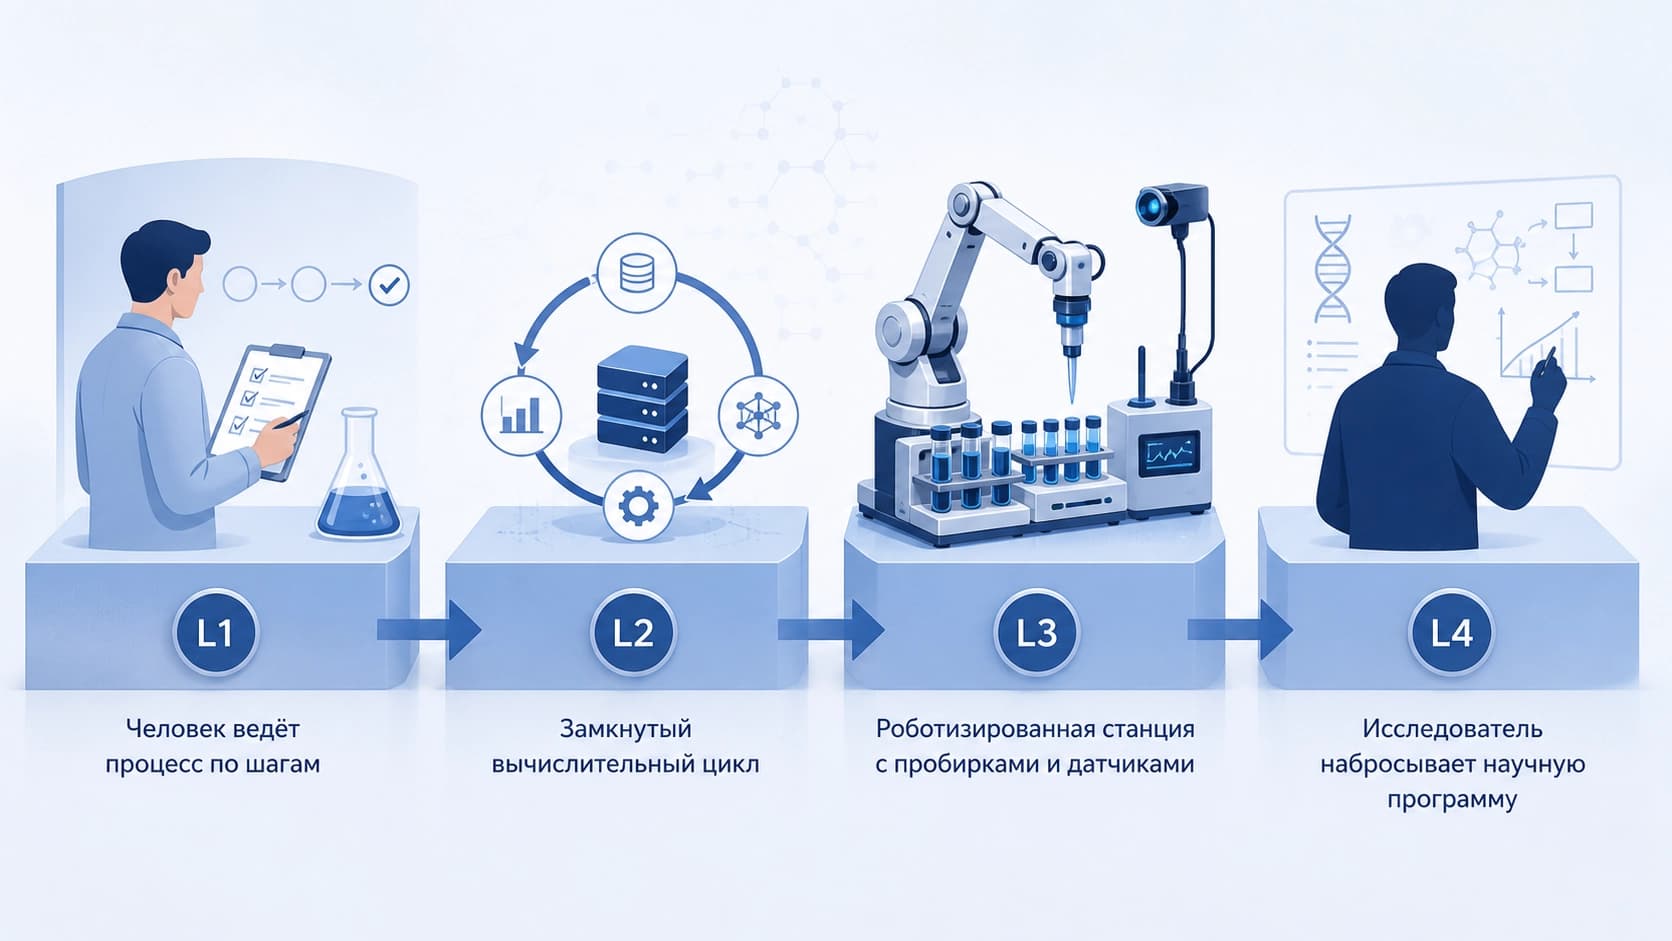
L4 — वैज्ञानिक एजेंडा तय करने वाला एजेंट
सबसे ऊपरी सीढ़ी — जब प्रणाली स्वयं चुनती है कि कौन-सी परिकल्पनाएँ जाँचनी हैं, किन दिशाओं को प्राथमिकता देनी है और साहित्य में कहाँ अंतराल खोजने हैं। फ़िलहाल यह काम करने वाले समाधानों का विवरण नहीं, बल्कि एक दिशासूचक है। लेकिन यही दिशा तय करता है: «तेज़ निष्पादक» और «सह-लेखक-निर्माता» के बीच का अंतर मूलभूत है, और इसे अंतर्ज्ञान से नहीं, शब्दों में दर्ज करना चाहिए।
ऐसी रूपरेखा की ज़रूरत क्यों है
दोनों दृष्टिकोणों का व्यावहारिक लाभ अतुलनीय की तुलना करने की क्षमता में है। अगर दो एजेंट दोनों खुद को «स्वायत्त» कहते हैं, लेकिन एक सिमुलेटर में घूमता है और दूसरा रोबोट-संश्लेषक को नियंत्रित करता है, तो ये अलग-अलग ज़िम्मेदारी वर्ग की प्रणालियाँ हैं।
लेखक इस फ्रेमवर्क को तीन कामों के लिए उपयोग करने का सुझाव देते हैं:
- निदान। एजेंट को परतों में बाँटकर देखा जा सकता है कि उसमें कमज़ोरी कहाँ है: अणुओं के बोध में, उपकरणों में या योजना बनाने में।
- जोखिम मूल्यांकन। स्तर जितना ऊँचा, विफलता के परिणाम उतने ही गंभीर — और कार्रवाई से पहले जाँच उतनी ही ज़रूरी, बाद में नहीं।
- डिज़ाइन। यह समझना कि किसी काम के लिए वास्तव में किस स्तर की स्वायत्तता चाहिए, इस प्रलोभन से बचाता है कि जहाँ सावधान L2 काफ़ी होता, वहाँ L4 बनाया जाए।
सीमाएँ और क्या अनसुलझा रहता है
एक ईमानदार चेतावनी: सीढ़ी एक अवधारणात्मक मॉडल है, मापी गई श्रेणी नहीं। यह सोचने में मदद करती है, लेकिन सत्यापन, प्रमाणन और परिणामों की पुनरुत्पादकता का विकल्प नहीं है। साथ ही रसायन विज्ञान «लगभग सही» को अच्छी तरह बर्दाश्त नहीं करता: टेक्स्ट में टाइपो — झुंझलाहट, संरचनात्मक सूत्र में — पहले से ही दूसरा पदार्थ।
एक अलग अनसुलझा सवाल डेटा का है। वास्तविक प्रयोगशाला से फ़ीडबैक महँगा और दुर्लभ है, और उसके बिना L3 एजेंट सिद्धांत ही रहता है। दूसरा सवाल व्याख्यायोग्यता का है: रसायनशास्त्री को समझना चाहिए कि प्रणाली ने क्यों यही संश्लेषण मार्ग सुझाया, वरना भरोसा नहीं बनेगा।
मुख्य बातें संक्षेप में
मोलेक्युलर LLM एजेंट केवल «रसायन विज्ञान प्लस चैटबॉट» नहीं हैं। यह प्रणालियों का एक अलग वर्ग है, जहाँ भाषा मॉडल ग्राफ़, स्पेक्ट्रा, गणना पैकेजों और प्रयोगशाला उपकरणों के बीच डिस्पैचर का काम करता है। arXiv:2608.23104 का काम सबसे पहले अपनी शब्दावली के लिए उपयोगी है: चार आर्किटेक्चरल परतें और स्वायत्तता के चार स्तर इस बात की साझा भाषा देते हैं कि ऐसे एजेंट अब क्या कर सकते हैं, उनमें क्या कमी है, और नियमित काम की उपयोगी तेज़ी तथा ऐसे निर्णय के बीच सीमा कहाँ है जिसे मनुष्य के लिए छोड़ देना ही बेहतर है।


