
छिपे हुए संकेतक MoE-आर्किटेक्चर में LLM के गलत उत्तरों को उजागर करते हैं
InnerExpert का नया दृष्टिकोण MoE मॉडल्स में रूटिंग और विशेषज्ञों की असहमति की विशेषताओं का उपयोग करके टोकन-स्तर पर निर्मित (हैलुसिनेटेड) अंशों की पहचान करता है। यह विधि बिना मैन्युअल एनोटेशन के प्रशिक्षित होती है और पाँच डेटासेट्स पर उत्तर-स्तर पर 0.91 तक और टोकन-स्तर पर 0.76 तक की सटीकता एक ही पास में दिखाती है।
क्यों LLM का झूठा आत्मविश्वास सिर्फ एक बग नहीं है
आधुनिक भाषा मॉडल विचारों को सहज और प्रभावशाली ढंग से व्यक्त करना सीख चुके हैं। लेकिन इस प्रभावशालीता के पीछे अक्सर वह छिपा होता है जिसे विशेषज्ञ मतिभ्रम कहते हैं: मॉडल प्रशंसनीय लगने वाली, लेकिन पूरी तरह काल्पनिक सामग्री उत्पन्न करता है। उपयोगकर्ता के लिए यह एक समान, आत्मविश्वासपूर्ण पाठ जैसा दिखता है — और यही कारण है कि यह समस्या खतरनाक है।
अधिकांश सामान्य मतिभ्रम डिटेक्टर मोटे तौर पर काम करते हैं। वे पूरे उत्तर या अलग-अलग वाक्यों का मूल्यांकन करते हैं, कुछ इस तरह बताते हैं कि «यहाँ, शायद, कोई त्रुटि है»। लेकिन यह समझने के लिए कि मॉडल ने वास्तव में किस स्थान पर «तथ्य गढ़ा» है, अधिक सूक्ष्म जाँच की आवश्यकता है — अलग-अलग टोकन के स्तर पर। केवल टोकन-स्तरीय पहचान ही झूठे अंश को स्थानीयकृत करने और पीढ़ी में लक्षित हस्तक्षेप करने की अनुमति देती है, बाकी पाठ को छुए बिना।
MoE मॉडल संयोगवश सुराग देते हैं
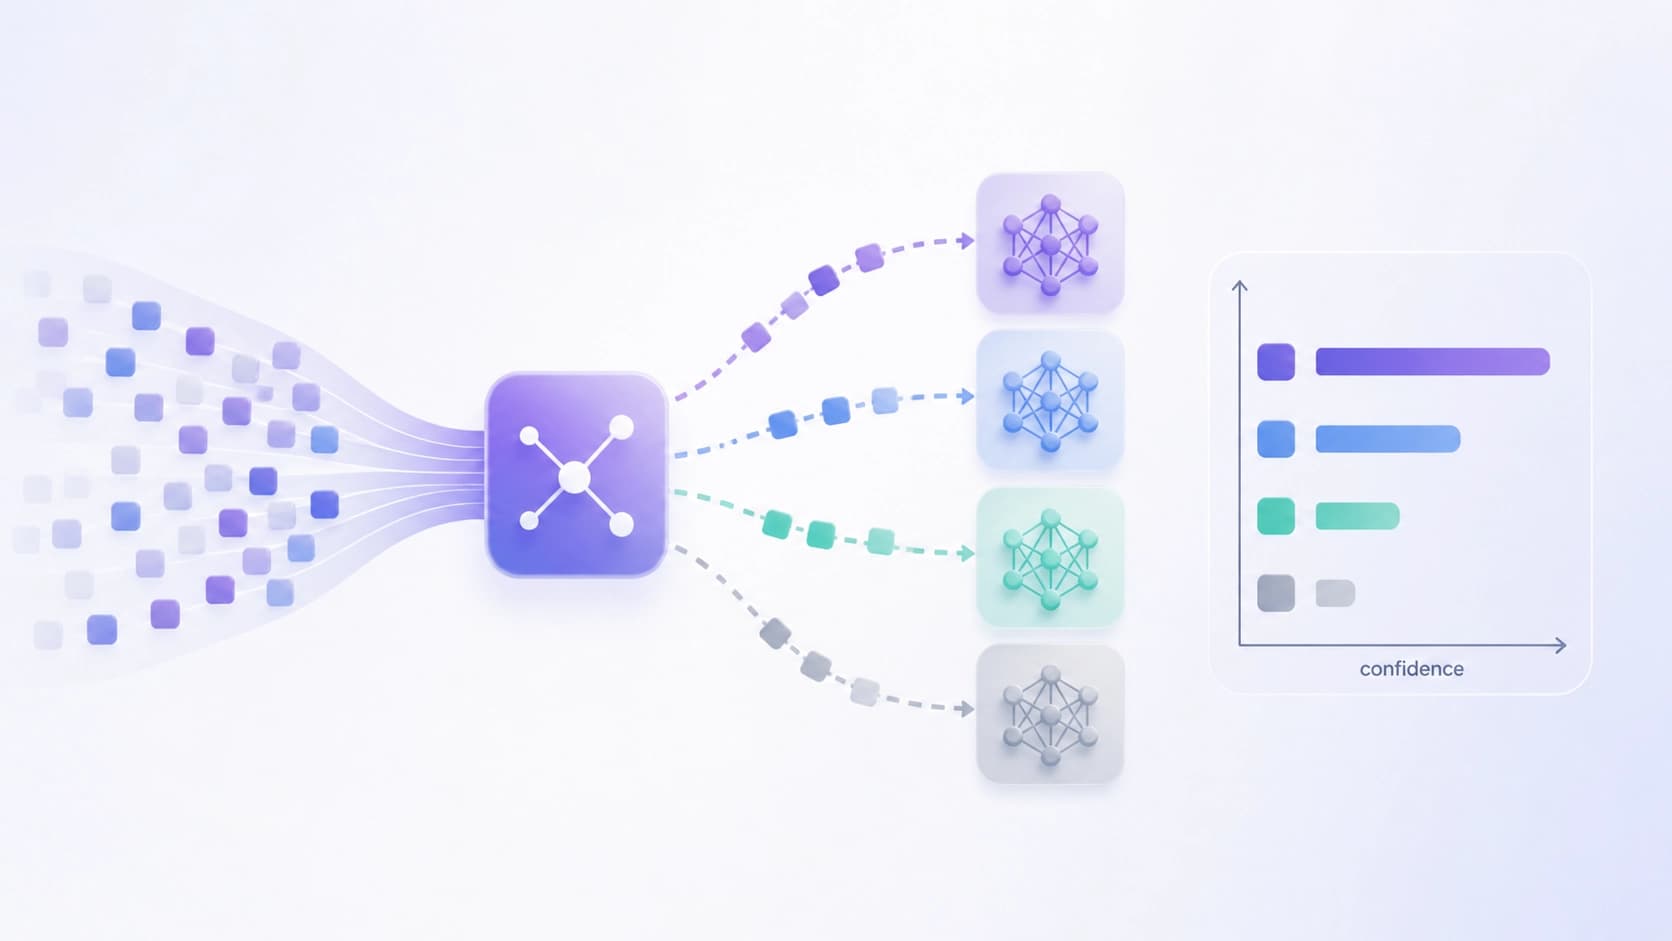
Mixture-of-Experts (MoE) जैसी वास्तुकलाओं में एक दिलचस्प सिद्धांत काम करता है: एक फॉरवर्ड पास में पूरे नेटवर्क के बजाय केवल «विशेषज्ञों» का एक विरल उपसमुच्चय सक्रिय होता है। किसे बुलाना है, यह चुनाव रूटिंग तंत्र करता है। और ठीक इसी क्षण आंतरिक संकेत उत्पन्न होते हैं, जो घने आर्किटेक्चर में बिल्कुल नहीं होते:
- राउटर की एन्ट्रॉपी — मॉडल «अनिश्चित» है कि किस विशेषज्ञ के पास जाए;
- विशेषज्ञों की असहमति — उनके मध्यवर्ती परिणाम कितने भिन्न हैं;
- विशेषज्ञों के उपयोग के पैटर्न — कौन से विशेषज्ञ अधिक बार काम में आते हैं।
पहले ये संकेत मतिभ्रम खोजने के लिए लगभग उपयोग नहीं किए जाते थे। शोधकर्ता जुआन फोंसेका, रोड्रिगो रोड्रिगेज और पाओलो रोमानो ने arXiv:2608.17687 लेख में दिखाया कि यह गलत था: छिपे हुए संकेतक उन क्षणों को उजागर कर सकते हैं जब मॉडल रचना करना शुरू करता है। यह कार्य 18 अगस्त 2026 को arXiv पर प्रस्तुत किया गया था।
InnerExpert: एक डिटेक्टर जो मॉडल के अंदर देखता है
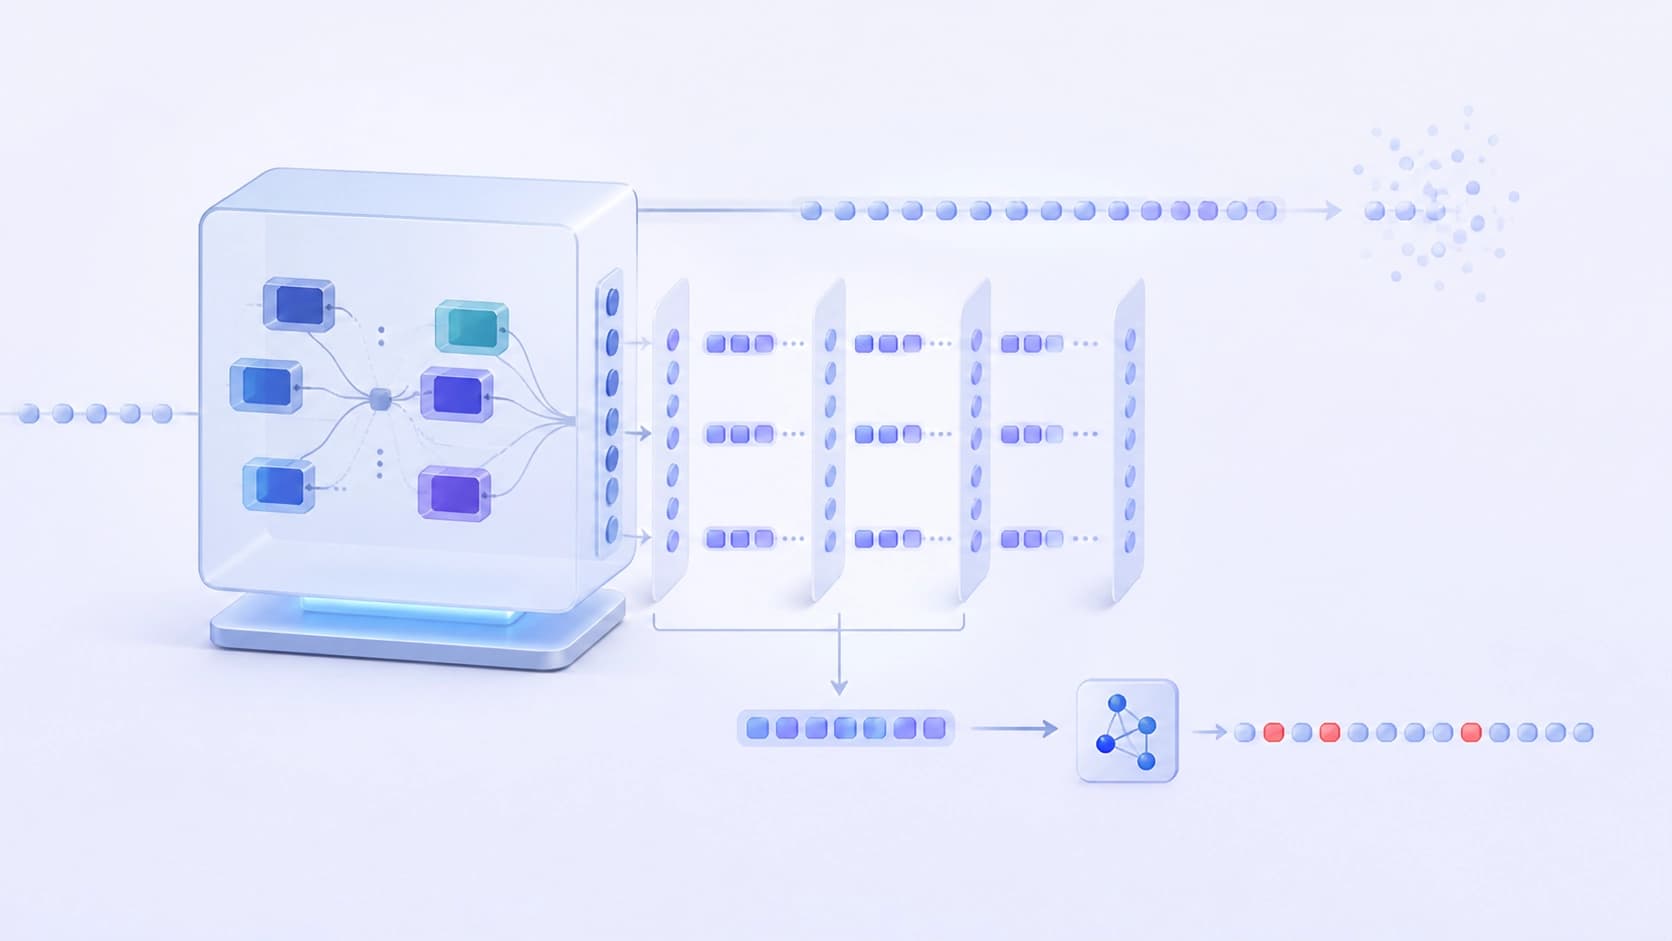
लेखकों द्वारा प्रस्तावित विधि InnerExpert दो प्रकार के डेटा को जोड़ती है: MoE-विशिष्ट रूटिंग-स्तरीय संकेत और ट्रांसफॉर्मर के मानक आंतरिक प्रतिनिधित्व। यह सब प्रत्येक टोकन के लिए कॉम्पैक्ट फीचर वेक्टर में एकत्र किया जाता है। फिर एक हल्का क्लासिफायर इन वेक्टरों को संसाधित करता है और निर्धारित करता है कि टोकन मतिभ्रम है या नहीं।
मुख्य विशेषता — स्वचालित प्रशिक्षण। डिटेक्टर को प्रशिक्षित करने के लिए लेबल LLM-as-a-judge पाइपलाइन द्वारा बनाए जाते हैं, जब एक भाषा मॉडल दूसरे के आउटपुट का मूल्यांकन करता है। किसी मैन्युअल एनोटेशन की आवश्यकता नहीं है। इसका मतलब है कि डिटेक्टर को जनरेटिव मॉडल के नए संस्करणों के लिए जल्दी से अनुकूलित किया जा सकता है, बस पाइपलाइन को फिर से चलाकर।
परीक्षणों ने क्या दिखाया
प्रयोगों में पाँच डेटासेट और दो अलग-अलग MoE आर्किटेक्चर शामिल थे। परीक्षणों में InnerExpert ने मौजूदा डिटेक्टरों को लगातार पीछे छोड़ दिया। सर्वोत्तम परिणाम पूरे उत्तर के स्तर पर 0.91 AUROC और अलग-अलग टोकन के स्तर पर 0.76 AUROC तक पहुँचे। इसके अलावा, इसके लिए केवल एक फॉरवर्ड पास पर्याप्त है — अतिरिक्त सत्यापन मॉडल या बार-बार पीढ़ी चलाने की आवश्यकता नहीं है।
उच्च answer-level परिणाम मोटे फ़िल्टरिंग के लिए उपयोगी है। लेकिन वास्तव में मूल्यवान संकेतक token-level है: यह पाठ के झूठे हिस्सों को सटीक रूप से खोजने की अनुमति देता है और, उदाहरण के लिए, उन्हें फिर से लिखने या उपयोगकर्ता को हाइलाइट करने की। यह अब «कहीं त्रुटि है» नहीं, बल्कि उत्तर में एक विशिष्ट स्थान है।
यह क्यों महत्वपूर्ण है
मतिभ्रम चिकित्सा, कानून, वित्त और त्रुटियों के प्रति संवेदनशील अन्य क्षेत्रों में LLM अपनाने में मुख्य बाधाओं में से एक बने हुए हैं। मॉडल के आंतरिक संकेतों में झाँकने और उसके «संदेह» को पहले से देखने की क्षमता — पारदर्शी पीढ़ी की दिशा में एक और व्यावहारिक कदम है। छिपे हुए संकेतक समस्या को पूरी तरह से समाप्त नहीं करते, लेकिन एक काम करने वाला उपकरण देते हैं जो पहले से उपलब्ध है।
अलग से दिलचस्प बात यह है कि मतिभ्रम का निदान स्वयं वास्तुकला की विशेषताओं से पैदा हुआ। MoE मॉडल गति और दक्षता के लिए बनाए गए थे, और उनकी आंतरिक संरचना अप्रत्याशित रूप से गुणवत्ता नियंत्रण के लिए उपयोगी साबित हुई। आगे के शोध निश्चित रूप से और गहराई तक जाएंगे — विशेषज्ञों और रूटिंग तंत्रों के भीतर अधिक सूक्ष्म संकेतों की ओर।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री
OpenCollab: एजेंटों का प्रोग्रामेबल समन्वय, नियंत्रित निष्पादन वातावरण और नियमावली अनुपालन का मेट्रिक
यह फ़्रेमवर्क एजेंटों के बीच संवाद की संरचना निर्धारित करने, प्रयोगों के लिए साझा परिवेश और घटनाओं की विस्तृत ट्रेसिंग को एक साथ जोड़ता है, जबकि नया पेश किया गया Adherence मेट्रिक यह दर्शाता है कि वास्तविक निष्पादन घोषित योजना से कितना मेल खाता है। बेंचमार्क में Duo कॉन्फ़िगरेशन नया SOTA हासिल करता है, जबकि एकल-एजेंट वाला विकल्प सबसे कम टोकन खर्च करता है।
11 नवम्बर 2026
Toollery: बिना फ़ाइन-ट्यूनिंग के, दसियों हज़ार विकल्पों में से LLM एजेंटों के लिए टूल चुनना
Toollery कौशलों और टूल्स के विवरणों पर एक खोज इंडेक्स बनाता है और अनुरोध आने पर मॉडल को केवल सीमित उम्मीदवारों का सेट भेजता है। दसियों हज़ार फ़ंक्शनों तक के आकार वाली लाइब्रेरी पर किए गए प्रयोगों में, यह तरीका निश्चित top-K पर चयन की गुणवत्ता बनाए रखने में सक्षम है, हालांकि अंतिम प्रभाव लोड प्रोफ़ाइल और प्रदाता की कैशिंग पर निर्भर करता है।
11 नवम्बर 2026
डैशबोर्ड विश्लेषण में GUI एजेंटों का चरणबद्ध निदान: DashAct बेंचमार्क
DashAct प्रस्तुत है—348 मानव-सत्यापित ट्रैजेक्टरी वाला एक बेंचमार्क, जो इंटरैक्टिव डैशबोर्ड के साथ GUI एजेंटों के काम को तीन चरणों और चार दृश्य स्थितियों में विभाजित करता है। नतीजे बताते हैं कि एजेंटों को कार्रवाइयों का अनुमान लगाने और दृश्य लक्ष्यों से जुड़ने में लगातार समस्याएँ आती हैं, साथ ही उनकी प्रतिक्रियाएँ संदर्भ और स्थानिक समर्थन पर निर्भर करती हैं।
11 नवम्बर 2026