
गणित में मल्टीमॉडल मल्टी-एजेंट LLM: समाधान के चरणों और विकृतियों के प्रति मजबूती की जाँच कैसे करें
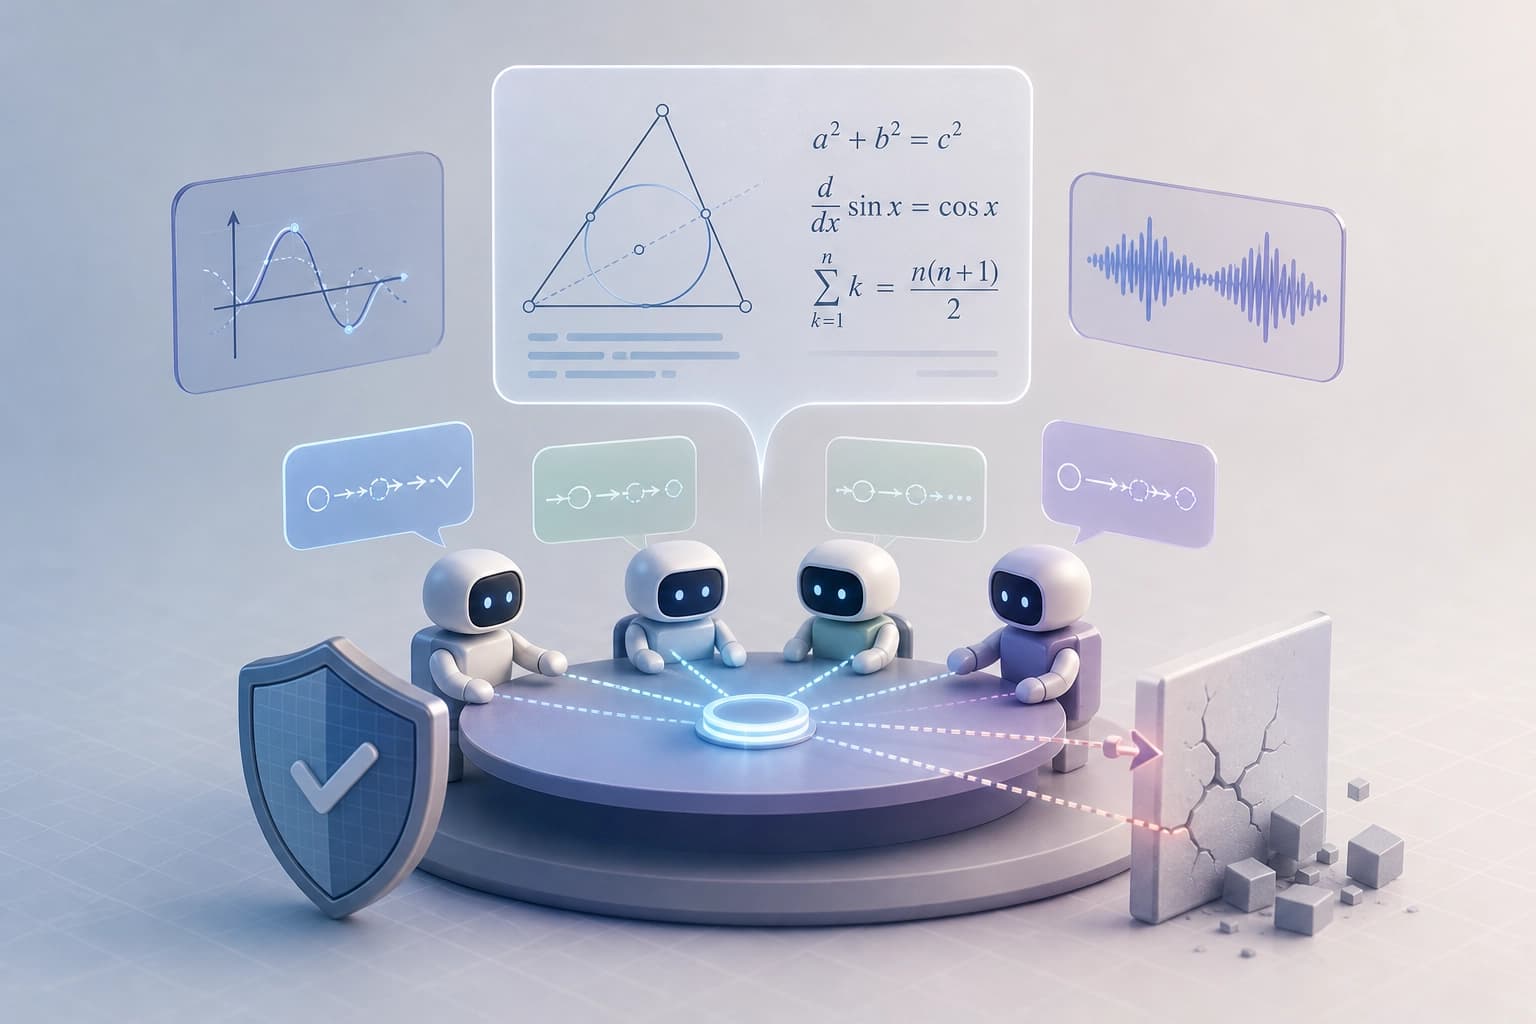
MAMath-Bench प्रस्तुत किया गया है—11 गणितीय क्षेत्रों के 1003 प्रश्नों का एक सेट, जिसमें पाठ, ग्राफ़िक्स और ऑडियो सामग्री शामिल हैं; अंतिम उत्तर के अलावा, यह जाँच के चरणों और तर्क-प्रक्रिया में प्रतिकूल बदलावों पर सिस्टम की प्रतिक्रिया को भी दर्ज करता है। परिणाम बताते हैं कि कई LLM के बीच सहयोग से सटीकता अनिवार्य रूप से नहीं बढ़ती, यह तर्कों में अनावश्यक विस्तार को बढ़ा सकता है, और सूक्ष्म संरचनात्मक व्यवधान अब भी कमज़ोरी का एक गंभीर स्रोत बने हुए हैं।
बेंचमार्क क्या मूल्यांकन करता है
MAMath-Bench, कई एजेंटों वाले सिस्टम की मल्टीमॉडल गणितीय तर्क-क्षमता का मूल्यांकन करने वाला बेंचमार्क है। इसमें गणित की 11 श्रेणियों के 1 003 कार्य शामिल हैं। इन कार्यों में कठिनाई के कई स्तर और तीन माध्यम शामिल हैं: पाठ, चित्र और ऑडियो।
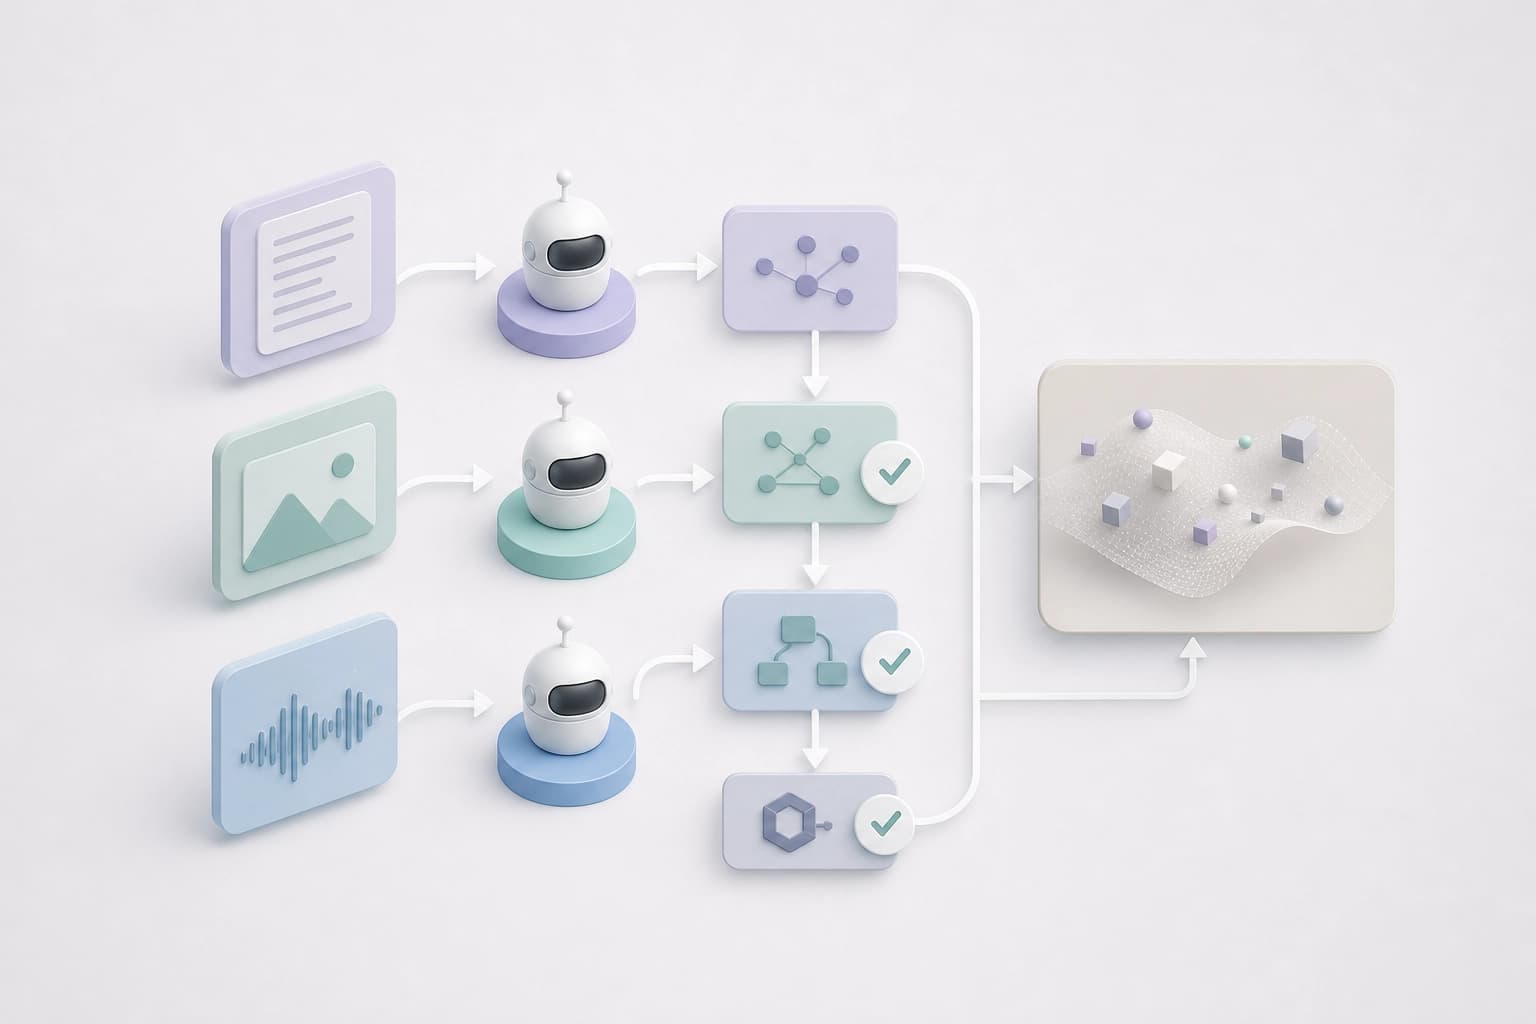
बेंचमार्क में जाँच-बिंदुओं के विस्तृत एनोटेशन हैं। मूल्यांकन तीन आयामों पर किया जाता है:
- कार्य को सही ढंग से हल करना;
- तर्क-प्रक्रिया की विश्वसनीयता;
- तर्क-श्रृंखला में प्रतिद्वंद्वी हस्तक्षेपों के प्रति मज़बूती।
व्यावहारिक मानदंड: ऐसा मूल्यांकन चुनें जो उत्तर की शुद्धता, प्रक्रिया की विश्वसनीयता और हस्तक्षेपों के प्रति मज़बूती को अलग-अलग मापे। इस जाँच के लिए केवल अंतिम उत्तर पर्याप्त नहीं है।
समाधान की प्रक्रिया की जाँच
जाँच-बिंदुओं के एनोटेशन, मध्यवर्ती चरणों की जाँच के लिए आधार देते हैं। तर्क-प्रक्रिया की विश्वसनीयता का मूल्यांकन अंतिम उत्तर की शुद्धता से अलग किया जाता है। इससे सिस्टम की तुलना केवल परिणाम के आधार पर नहीं, बल्कि अन्य पहलुओं पर भी की जा सकती है।
समाधान की प्रक्रिया में क्या जाँचें:
- एनोटेशन में चिह्नित जाँच-बिंदुओं की मौजूदगी;
- मध्यवर्ती चरणों का इन जाँच-बिंदुओं से मेल;
- तर्क-प्रक्रिया की विश्वसनीयता को एक अलग आयाम के रूप में।
जाँच का मानदंड: दर्ज करें कि समाधान जाँच-बिंदुओं से ठीक कहाँ भटकता है। केवल अंतिम उत्तर से समाधान की प्रक्रिया की गुणवत्ता का पता नहीं चलता।
कई एजेंट: शुद्धता, कवरेज और अनावश्यकता
मूल्यांकन कई एजेंटों के सहयोग के तीन अलग-अलग प्रभाव दिखाता है। मज़बूत सिंगल LLM की तुलना में अंतिम उत्तर की शुद्धता हमेशा नहीं बढ़ती। मध्यवर्ती तर्क का कवरेज काफ़ी बेहतर हो सकता है। कवरेज में बढ़ोतरी के साथ तर्क की अनावश्यकता भी बढ़ सकती है।
| किसकी तुलना करें | मूल्यांकन क्या दिखाता है | व्यावहारिक निष्कर्ष |
|---|---|---|
| अंतिम उत्तर की शुद्धता | कई एजेंटों का सहयोग, मज़बूत सिंगल LLM की तुलना में हमेशा शुद्धता नहीं बढ़ाता | कई एजेंटों वाली व्यवस्था को सही उत्तर की गारंटी न मानें |
| मध्यवर्ती तर्क का कवरेज | सहयोग से कवरेज काफ़ी बेहतर हो सकता है | कवरेज में लाभ की तुलना अन्य आयामों से करें |
| तर्क की अनावश्यकता | कवरेज में बढ़ोतरी के साथ अनावश्यकता भी बढ़ सकती है | कवरेज का मूल्यांकन करते समय अनावश्यकता में बढ़ोतरी को ध्यान में रखें |
चयन का मानदंड: कई एजेंटों वाली व्यवस्था को शुद्धता की गारंटी न मानें। अंतिम उत्तर, कवरेज और अनावश्यकता के आधार पर इसकी तुलना किसी मज़बूत सिंगल LLM से करें।
प्रतिद्वंद्वी विकृतियों के प्रति मज़बूती
मूल्यांकन में तर्क-श्रृंखला के प्रतिद्वंद्वी हस्तक्षेपों के प्रति मज़बूती भी शामिल है। आधुनिक सिस्टम अब भी तर्क में प्रतिद्वंद्वी त्रुटियों के प्रति संवेदनशील हैं, खासकर उन त्रुटियों के प्रति जो सूक्ष्म संरचनात्मक हस्तक्षेपों से जुड़ी हैं।
क्या जाँचें:
- तर्क-श्रृंखला में प्रतिद्वंद्वी हस्तक्षेपों पर सिस्टम की प्रतिक्रिया;
- सूक्ष्म संरचनात्मक हस्तक्षेपों के कारण होने वाली तर्क-त्रुटियाँ;
- केवल अंतिम उत्तर ही नहीं, बल्कि प्रक्रिया की विश्वसनीयता का भी बने रहना।
मज़बूती का मानदंड: तर्क-श्रृंखला में प्रतिद्वंद्वी हस्तक्षेपों के तहत सिस्टम की जाँच करें। उत्तर की शुद्धता के साथ-साथ इनके प्रति मज़बूती भी मूल्यांकन का हिस्सा है।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री
सत्यापन योग्य कार्य और लंबी ट्रैजेक्टरीज़ पर फाइन-ट्यूनिंग: Navalia सहकारी LLM एजेंटों को कैसे मजबूत करता है
यह कार्य एक ऐसे फ्रेमवर्क का वर्णन करता है, जो कॉर्पोरेट वित्तीय रिपोर्टिंग के आधार पर पता लगाने योग्य साक्ष्यों वाली कम्प्यूटेशनल श्रृंखलाएँ बनाता है, उन्हें स्वतंत्र रूप से सत्यापित करता है और फिर SFT तथा RL के लिए उपयोग करता है। Qwen3.6-35B-A3B पर आधारित यह पाइपलाइन पाँच बेंचमार्क पर बेहतर परिणाम देती है और लेखकों के अनुसार, साक्ष्यों को जोड़ने, टूल्स का उपयोग करने और लंबे कार्यों को पूरा करने की क्षमता में सुधार करती है—जिसमें कार्यालय संबंधी परिदृश्य भी शामिल हैं।
18 नवम्बर 2026
भौतिक AI: अवधारणा की सीमाएँ, टूलकिट और कठिनाइयाँ
388 पृष्ठों की यह मोनोग्राफ भौतिक AI की परिभाषाओं, निकटवर्ती क्षेत्रों से उसके अंतर और प्रमुख तरीकों—अनुभूति और सिमुलेशन से लेकर नियंत्रण और समन्वित बहु-एजेंट प्रणालियों तक—को एक ही रूपरेखा में समेटती है। इससे उन शोध-समस्याओं और सीमाओं का मानचित्र मिलता है, जो विशिष्ट समाधानों से व्यापक सामान्यीकरण क्षमता वाली प्रणालियों की ओर बढ़ने में बाधा बनती हैं।
17 नवम्बर 2026
उत्पादन में LLM एजेंट: वर्गीकरण, आर्किटेक्चर और कार्यान्वयन की सीमाएँ
यह लेख उत्पादन एजेंटों में बड़े भाषा मॉडल के उपयोग से जुड़े शोध को व्यवस्थित करता है: इसमें बाधाओं, क्षमताओं के स्तरों और चार-स्तरीय आर्किटेक्चर की पहचान की गई है। इससे समझा जा सकता है कि जीवनचक्र के किन परिदृश्यों पर पहले से विचार किया जा रहा है और विश्वसनीय स्वायत्त योजना बनाने में कहाँ कमियाँ बनी हुई हैं।
17 नवम्बर 2026