HyCO का सार
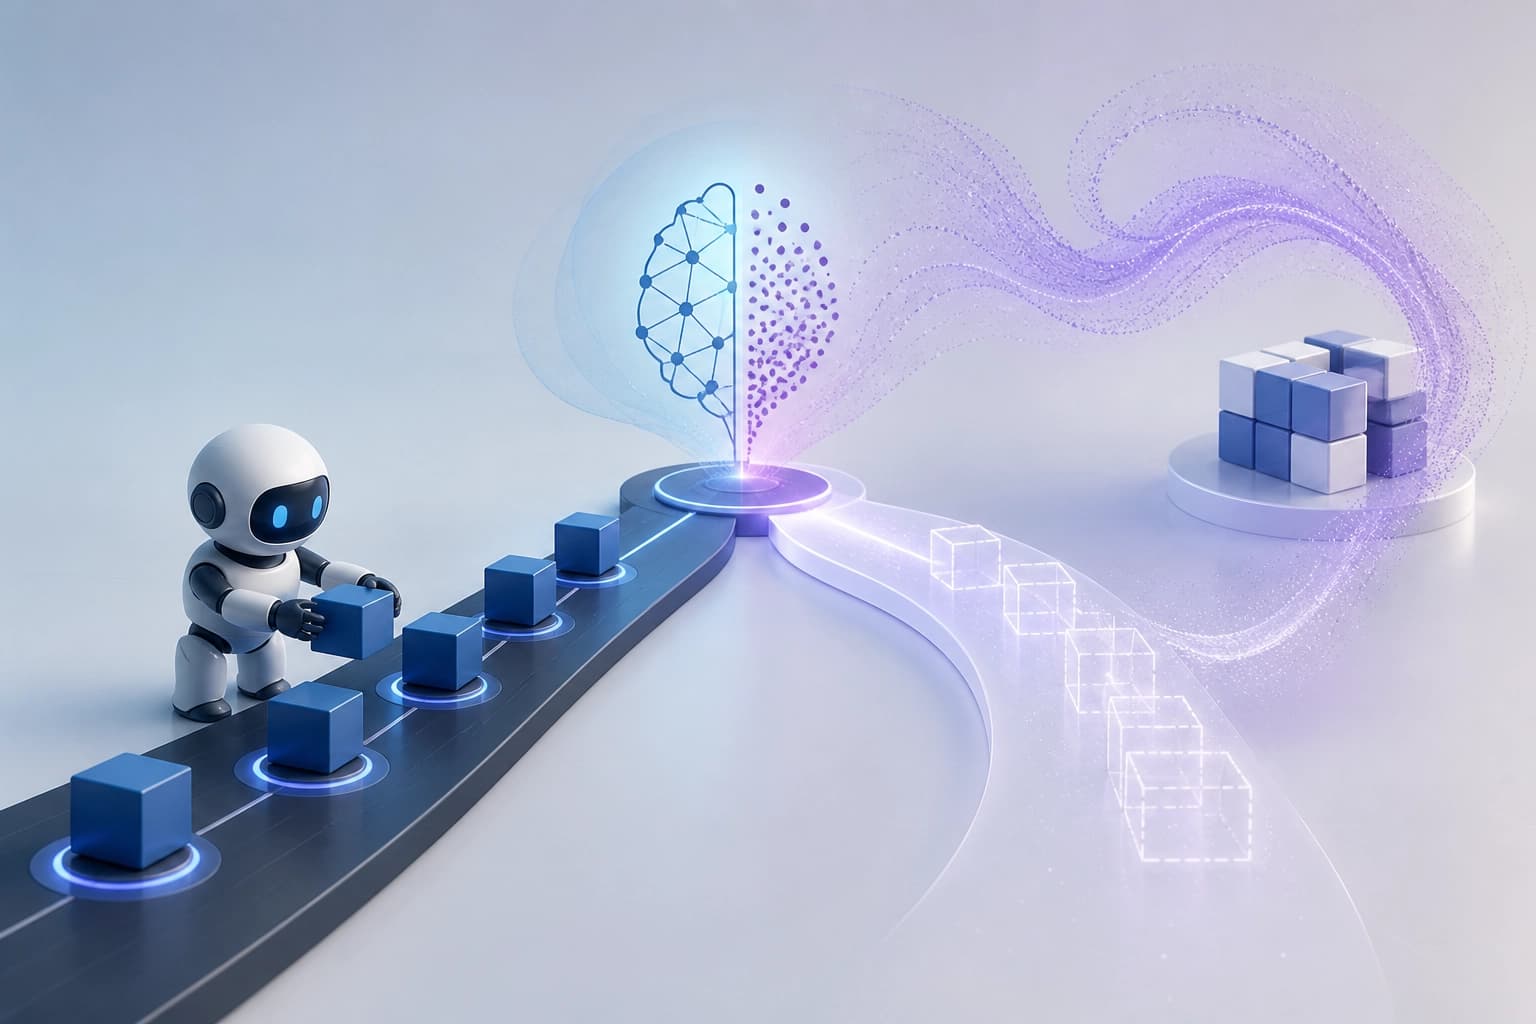
HyCO — Hybrid Neural Solver for Combinatorial Optimization। यह विधि RL-सॉल्वर की मदद से समाधान का प्रीफ़िक्स बनाती है। फिर अनुकूली रूप से एक कंडीशनल डिफ़्यूज़न मॉडल पर स्विच करती है। वह बाकी समाधान पूरे करता है। यह हाइब्रिड न्यूरल कॉम्बिनेटोरियल ऑप्टिमाइज़ेशन की समस्याएँ हल करता है। इसका लक्ष्य दो वर्ग के सॉल्वरों की ताकत को जोड़ना है।
यह काम arXiv:2609.07990 के रूप में उपलब्ध है। लेखक: Yuheng Li, Di Yang, Haipeng Chen, Yanhai Xiong। यह प्रीप्रिंट cs.LG और cs.AI से संबंधित है। लेखकों ने v1 संस्करण 7 Sep 2026 को जमा किया। ये विवरण मूल स्रोत खोजने और ब्यौरों की जाँच करने में मदद करते हैं।
व्यावहारिक अर्थ: HyCO एक सॉल्वर को दूसरे से नहीं बदलता, बल्कि उनके बीच संक्रमण को नियंत्रित करता है।
अकेली रणनीतियाँ कहाँ टूटती हैं
Sequential RL-सॉल्वर और ग्लोबल DM-सॉल्वर एक-दूसरे के पूरक विफलता मोड दिखाते हैं। यह ऑप्टिमाइज़ेशन regret में दिखता है।
| सॉल्वर वर्ग | ताकत | कमज़ोरी |
|---|---|---|
| Sequential RL | निर्माण के शुरुआती चरण में कम सीमांत regret | त्रुटियाँ क्षितिज पर जमा होती हैं; regret अतिरैखिक रूप से बढ़ता है |
| Global DM | क्षितिज पर संचय से बचता है | शेष अनसुलझे उपसमष्टि की विमा के सापेक्ष रैखिक या उपरैखिक regret |
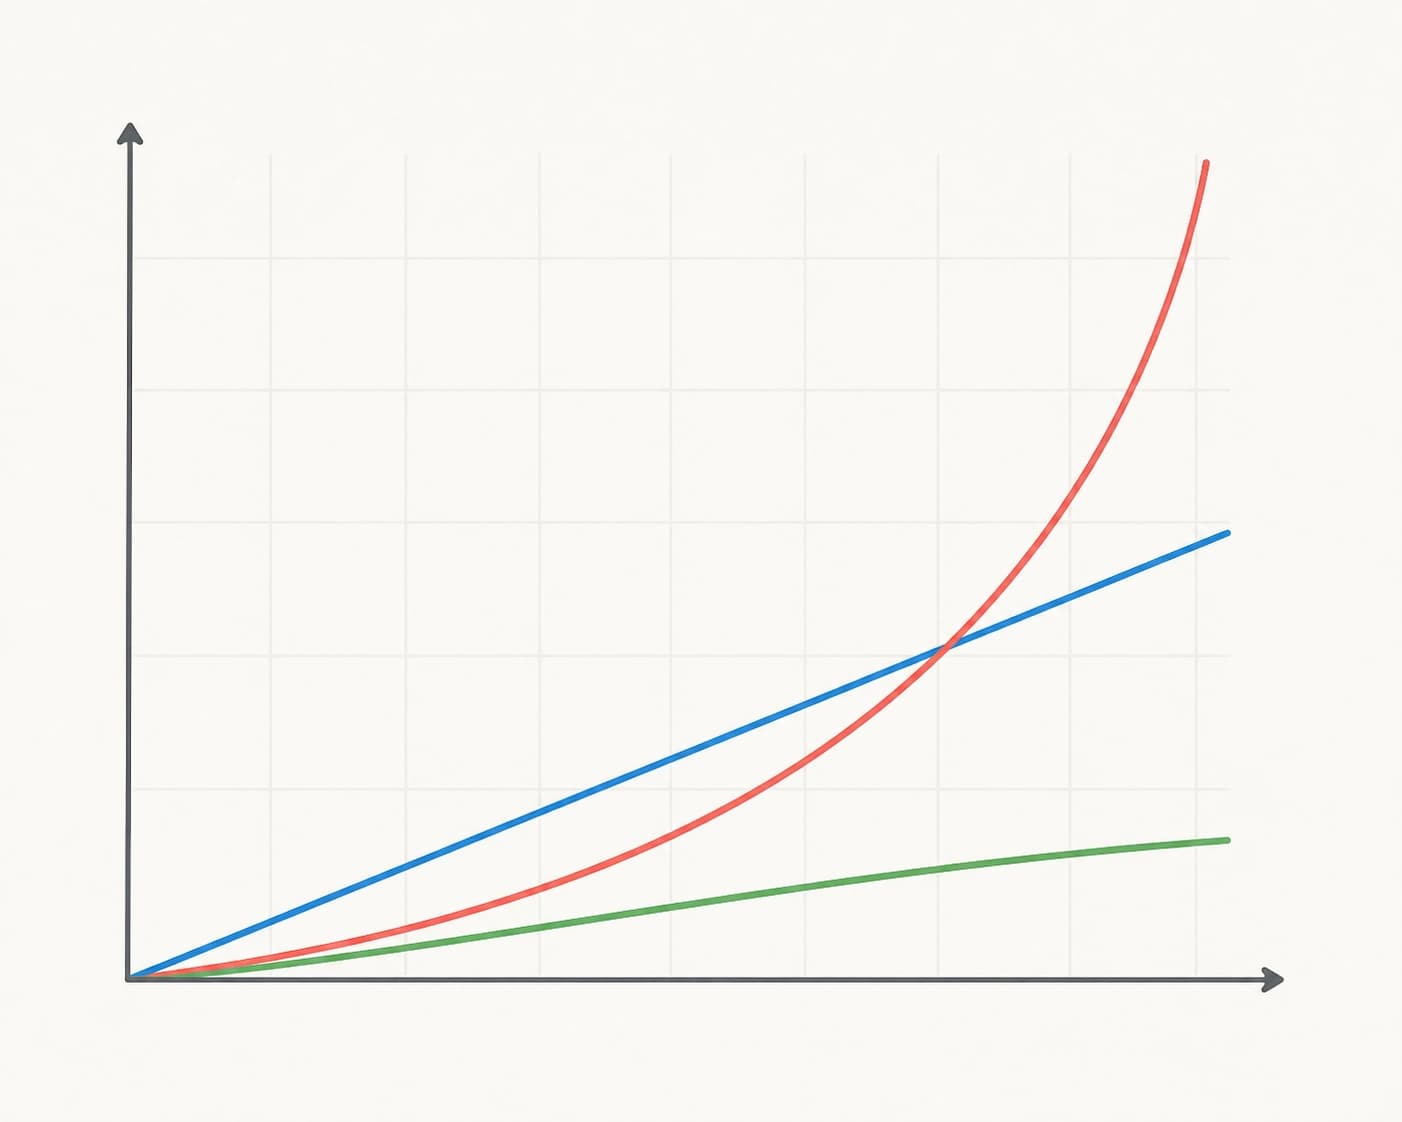
निष्कर्ष: विफलताएँ मेल नहीं खातीं। RL शुरुआत में अच्छा है, लेकिन क्षितिज से पीड़ित होता है। DM क्षितिज-त्रुटि जमा नहीं करता, पर शेष समस्या के आकार की कीमत चुकाता है। हाइब्रिडीकरण इसी अंतराल का उपयोग करता है।
स्विचिंग का सैद्धांतिक ढाँचा
लेखक त्रुटि स्केलिंग का एक एकीकृत सैद्धांतिक ढाँचा बनाते हैं। त्रुटि स्केलिंग की स्पष्ट मान्यताओं के अंतर्गत यह ढाँचा दो बातें सिद्ध करता है।
- हाइब्रिड संरचना दोनों आधारभूत योजनाओं में से प्रत्येक की तुलना में सख़्त रूप से कम अपेक्षित regret देती है।
- एक अद्वितीय इष्टतम स्विचिंग चरण मौजूद है, जो हाइब्रिड के regret को न्यूनतम करता है।
लेखक इष्टतम चरण को अपेक्षित regret के स्तर पर परिभाषित करते हैं। अलग-अलग ट्रैजेक्टरी पर इसकी सीधी गणना नहीं की जा सकती। इसलिए एक व्यावहारिक ट्रिगर की ज़रूरत है।
निष्कर्ष: सिद्धांत बताता है कि हाइब्रिड क्यों मदद करता है और हैंडऑफ़ कब शुरू करना है। यह हर ट्रैजेक्टरी के लिए तैयार सूत्र नहीं देता।
अनुकूली ट्रिगर कैसे काम करता है
HyCO एक हल्का अनुकूली ट्रिगर इस्तेमाल करता है। ट्रिगर पॉलिसी एंट्रॉपी और RL-DM विचलन को जोड़ता है। ये संकेत ट्रैजेक्टरी के स्तर पर मोड परिवर्तन की पहचान करते हैं। वे व्यावहारिक प्रॉक्सी का काम करते हैं। ऐसी प्रॉक्सी की ज़रूरत इसलिए है क्योंकि इष्टतम स्विचिंग चरण की गणना अलग ट्रैजेक्टरी पर नहीं हो सकती।
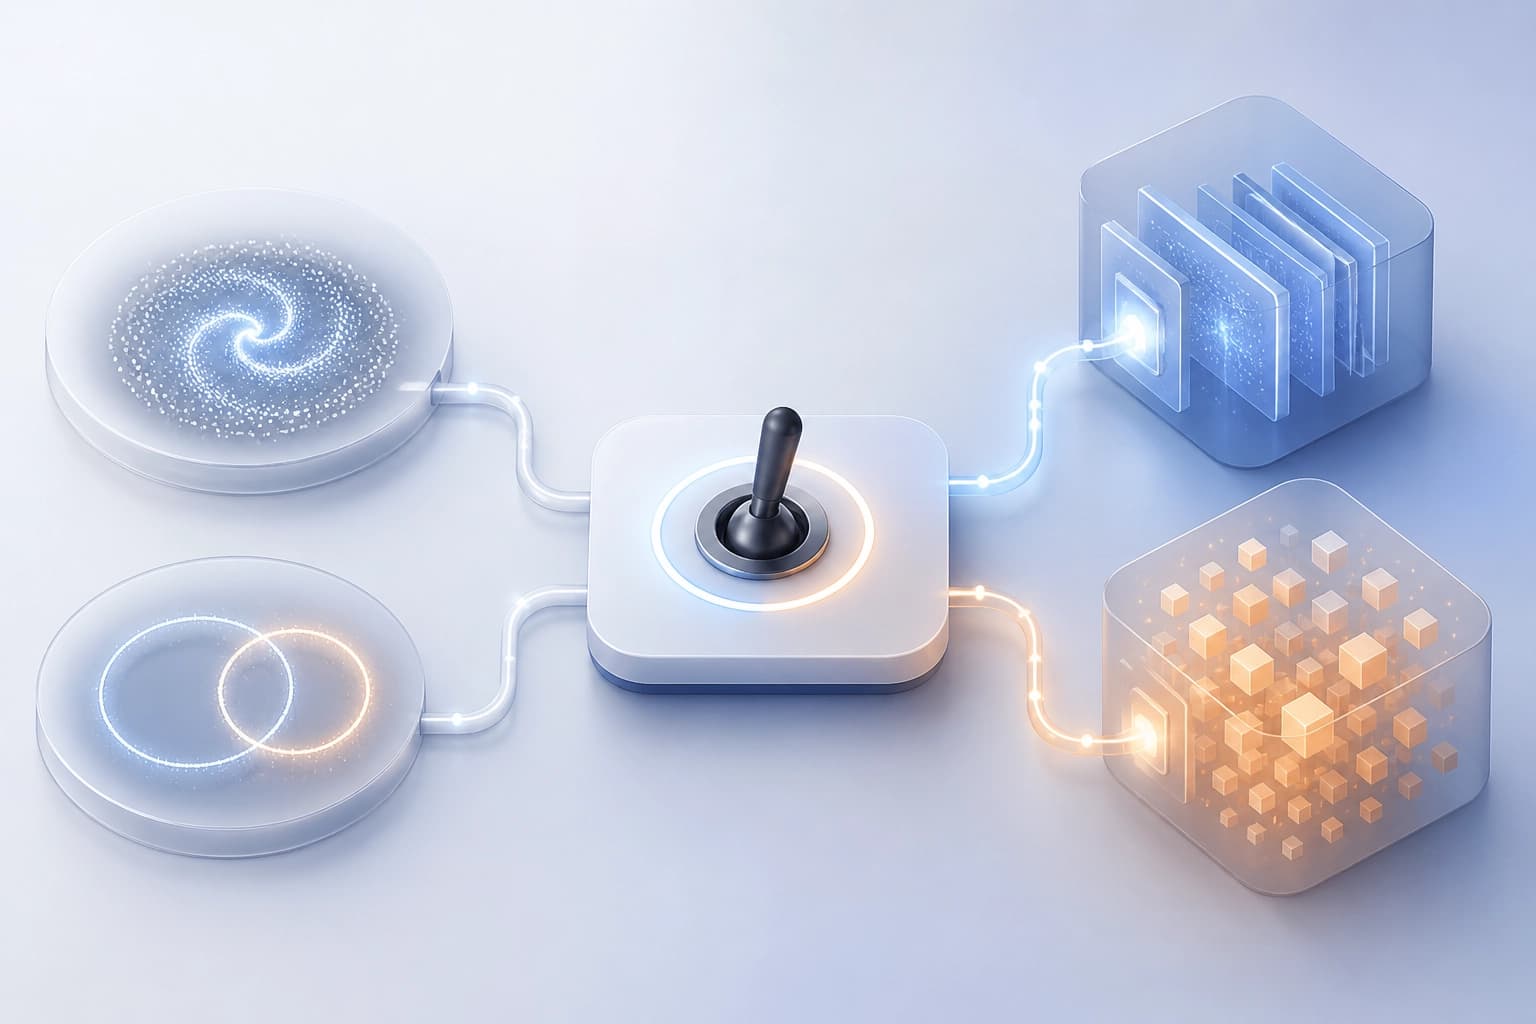
ट्रिगर RL प्रीफ़िक्स को समाप्त करता है। कंडीशनल DM बाकी समाधान पूरे करता है। व्यावहारिक मानदंड: पॉलिसी एंट्रॉपी और RL-DM विचलन पर नज़र रखें। ये संकेत मोड परिवर्तन और हैंडऑफ़ के क्षण की ओर इशारा करते हैं। ट्रिगर हल्का और अनुकूली बना रहता है।
प्रयोग और चयन का मानदंड
विविध बेंचमार्क पर प्रयोगों में HyCO दोनों आधारभूत सॉल्वरों की तुलना में स्थिर सुधार देता है। नतीजे अनुकूली ट्रिगर की अनुभवजन्य प्रभावशीलता की भी पुष्टि करते हैं।
चयन का व्यावहारिक मानदंड: कॉम्बिनेटोरियल ऑप्टिमाइज़ेशन के लिए एक inference-एल्गोरिदम चाहिए। यह शुरुआती प्रीफ़िक्स के लिए RL और बाकी समाधानों के लिए DM का उपयोग करता है। हाइब्रिड प्रत्येक आधारभूत योजना की तुलना में अपेक्षित regret घटाता है। HyCO RL-खोज और डिफ़्यूज़न पूर्णता के ऊपर एक स्विचिंग परत के रूप में उपयुक्त है। यह उनके बीच संक्रमण को नियंत्रित करता है।