
शीर्षक: GLM-5.3 बिना नई बेस मॉडल के: कैसे Z.ai ने पोस्ट-ट्रेनिंग से कोडिंग और साइबर सुरक्षा में वृद्धि हासिल की
अपडेट पिछले 743B आधार पर काम करता है, और सभी सुधार विस्तारित पोस्ट-ट्रेनिंग से जुड़े हैं: लंबे क्षितिज वाले जटिल कार्य काफी अधिक सुलभ हो गए हैं, और सुरक्षा बेंचमार्क पर परिणाम उम्मीदों से अधिक बढ़े हैं। वेट प्रकाशित होने में लगभग दो सप्ताह बाकी हैं, फिलहाल मॉडल API, GLM Coding Plan और ZCode के माध्यम से जुड़ा हुआ है।
परिचय: एक नए आधार मॉडल के बिना
जब एक बड़ी भाषा मॉडल का नया संस्करण बाहर आता है , आप आम तौर पर इसकी उम्मीद करेंगे एक भी बड़े डेटासेट पर फिर से प्रशिक्षित किया गया है। लेकिन Z.ai एक अलग दृष्टिकोण लेता है: जारी GLM-5.3 GLM-5.2 के रूप में 743 बिलियन मापदंडों के साथ उसी बेस मॉडल पर चलता है। सभी सुधार स्केल-अप पोस्ट-ट्रेनिंग का परिणाम है। मॉडल को अधिक वातावरण में चलाया गया था, नए प्रकार के वातावरण को जोड़ा गया था , और प्रशिक्षण पिछले संस्करण की तुलना में लंबे समय तक चल रहा है। अनिवार्य रूप से, यह एक प्रयोग है जो दिखा रहा है कि कितना अधिक निचोड़ा जा सकता है उचित कार्य-विशिष्ट ट्यूनिंग के साथ मौजूदा वास्तुकला का।
743 अरब मापदंडों एक विशाल मॉडल है, और इसकी पूर्व प्रशिक्षण लागत एक भाग्य है। पोस्ट-ट्रेनिंग काफी सस्ता है, हालांकि इसके लिए सावधानीपूर्वक डेटा इलाज और लंबे समय की आवश्यकता होती है। यह दृष्टिकोण केवल Z.ai के लिए ही नहीं है: यह संकेत देता है कि उद्योग में सुरक्षा मार्जिन है। आपको हमेशा स्क्रैच से प्रशिक्षण पर संसाधनों को खर्च नहीं करना पड़ता - कभी-कभी स्मार्ट पोस्ट-ट्रेनिंग पर्याप्त होता है।
कोडिंग: सबसे बड़ा लीप
प्रोग्रामिंग कार्यों पर, GLM-5.3 एक वास्तविक सफलता बनाता है। टर्मिनल-बेंच 3.0 बेंचमार्क पर, स्कोर 4.6 से 28.3 तक पहुंच गया - लगभग छह गुना सुधार। DeepSWE v1.1 पर स्कोर 46.2 से 66.9 तक बढ़ गया और एजेंट्स के अंतिम परीक्षा (CLI) पर - 23.8 से 28.5 तक। इसके अलावा GDPval-AA v2 परीक्षण है, जिसमें 44 पेशे शामिल हैं: यहां GLM-5.3 स्कोर 1769 अंक।
Z.ai के आंतरिक कोड बेंचमार्क GLM-5.2 पर 50% सुधार दिखाता है। मॉडल प्रति कार्य लगभग 50,000 आउटपुट टोकन पर 31.4% कार्यों को हल करता है। संदर्भ के लिए: क्लाउड ओपस 4.8 29.5% प्राप्त करता है लेकिन 120,000 टोकन खर्च करता है, जबकि क्लाउड फेबल 5 अधिकतम प्रयास के साथ 39.5% हिट करता है। Z.ai ने कहा कि एक निजी बेंचमार्क संदूषण के लिए कम खतरा है - एक महत्वपूर्ण तर्क, चूंकि सार्वजनिक डेटासेट GLM-5.3 अभी भी कई जटिल कोडिंग मूल्यांकनों पर GPT-5.6 सोल और Fable 5 को खो देता है। ध्यान रखें कि सभी आंकड़े विक्रेता द्वारा ही प्रदान किए जाते हैं, हालांकि दस्तावेज सेटिंग्स के साथ, इसलिए स्वतंत्र सत्यापन अभी भी आगे है।
टर्मिनल-बेंच 3.0 एक परीक्षण है जहां मॉडल को टर्मिनल में काम करने, कमांड चलाने और फ़ाइलों और पर्यावरण को संभालने की आवश्यकता होती है। लगभग छह गुना वृद्धि शानदार लगता है, लेकिन यह ध्यान देने योग्य है कि ये कृत्रिम कार्य हैं, और संदूषण के जोखिम को खारिज नहीं किया जा सकता है। व्यवहार में, इसका मतलब यह है कि मॉडल स्वायत्त कोड लेखन और डीबगिंग में उल्लेखनीय रूप से अधिक उपयोगी हो गया है: यह लंबे समय तक संदर्भ रखता है, योजनाओं में बेहतर कदम होता है, और मानव हस्तक्षेप की आवश्यकता अक्सर कम होती है।
साइबर सुरक्षा: अप्रत्याशित प्रभाव
साइबर सुरक्षा में एक और भी आश्चर्यजनक कहानी सामने आती है। Z.ai इंजीनियरों ने प्रशिक्षण डेटा के लिए vulnerability का पता लगाने के उदाहरण जोड़े और व्यक्तिगत बग के बारे में तर्क पर मॉडल को बेहतर बनाने की उम्मीद की। हालांकि, प्रशिक्षण स्केल के रूप में, क्षमताओं को संचित करना शुरू कर दिया, और कुछ बिंदु पर मॉडल ने पूर्ण शोषण श्रृंखला के लिए सुसंगत, बहु-चरण योजनाओं का निर्माण शुरू किया। यह स्पष्ट रूप से उभरे - इस तरह के कौशल को स्पष्ट रूप से प्रोग्रामिंग के बिना।
परिणाम प्रभावशाली हैं। CyberGym पर, GLM-5.3 ने GLM-5.2 के लिए 84.5% बनाम 77.2% स्कोर किया, जिसमें मैथोस 5 (83.8%) और GPT-5.6 सोल (83.6%) कहा गया। ExploitBench पर, सफलता दर दोगुनी हो गई: 24.4% से 54.4% तक। लेकिन यहां Mythos 5 78.0% पर नेता बनी हुई है। ExploitGym पर, मॉडल दो घंटे में 105 कार्यों को हल करता है और छह में 130 करता है। GLM-5.2 की संख्या अधिक मामूली हैं: 29 और 39 कार्य। Mythos 5 क्रमशः 181 और 247 कार्यों को संभालती है।
एक दिलचस्प विवरण: शोषण श्रृंखला में जितना गहरा काम, पिछले संस्करण में अधिक से अधिक GLM-5.3 का लाभ मिलता है। हालांकि, एक ही समय में, बंद फ्रंटियर मॉडल के साथ अंतर चौड़ी हो जाता है, इसलिए पूर्ण समानता के बारे में बात करना बहुत जल्दी है। ExploitBench संख्या इस अच्छी तरह से वर्णन: दो गुना वृद्धि के बावजूद, मिथक 5 के पीछे का अंतर महत्वपूर्ण रहा।
ऐसे उभरते व्यवहार सुरक्षा चिंताओं को भी बढ़ाते हैं: यदि कोई मॉडल हमलों की योजना बना सकता है, तो इसका खुला वितरण जोखिम भरा हो सकता है। यह वास्तव में क्यों वजन तुरंत प्रकाशित नहीं किया जाता है।
उपलब्धता और दृष्टिकोण
वर्तमान में, मॉडल वजन सार्वजनिक नहीं है। GLM-5.3 Z.ai API, GLM कोडिंग प्लान और ZCode के माध्यम से उपलब्ध है। कंपनी शुरू होने के लगभग दो सप्ताह बाद वजन खोलने की योजना बना रही है - सुरक्षा मूल्यांकन और मॉडल सख्त होने के बाद। अपनी क्षमताओं को कमजोरी शोषण में देखते हुए, ऐसी सावधानी काफी उचित है।
स्टार्टअप और मध्यम आकार के इंजीनियरिंग संगठनों के लिए इसका मतलब है कि मॉडल को अभी क्लाउड सेवाओं के माध्यम से एकीकृत किया जा सकता है। हालांकि, डेटा रेजीडेंसी आवश्यकताओं या सख्त विक्रेता वीटिंग के साथ एंटरप्राइजेज को वजन दिखाने की प्रतीक्षा करनी चाहिए - फिर मॉडल को अपने स्वयं के बुनियादी ढांचे में तैनात करना और इसके उपयोग को पूरी तरह से नियंत्रित करना संभव होगा।
नीचे पंक्ति: GLM-5.3 का एक आश्चर्यजनक उदाहरण है कि पोस्ट-ट्रेनिंग बेस आर्किटेक्चर को बदलने के बिना एक मॉडल को काफी मजबूत कर सकती है। लेकिन अंतिम निष्कर्ष समय से पहले हैं: खुले वजन के स्वतंत्र परीक्षण और विश्लेषण की आवश्यकता है। यह काफी संभव है यह दृष्टिकोण एक नई प्रवृत्ति बन जाएगा: यदि अन्य कंपनियों को लगता है कि सुधार जल्दी और अपेक्षाकृत सस्ते ढंग से इस तरह हासिल किया जा सकता है, तो मॉडल अद्यतन चक्र तेज हो जाएगा, और ध्यान विशिष्ट परिदृश्यों के लिए लक्षित ट्यूनिंग के लिए बड़े पैमाने पर पूर्व प्रशिक्षण से स्थानांतरित हो जाएगा।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री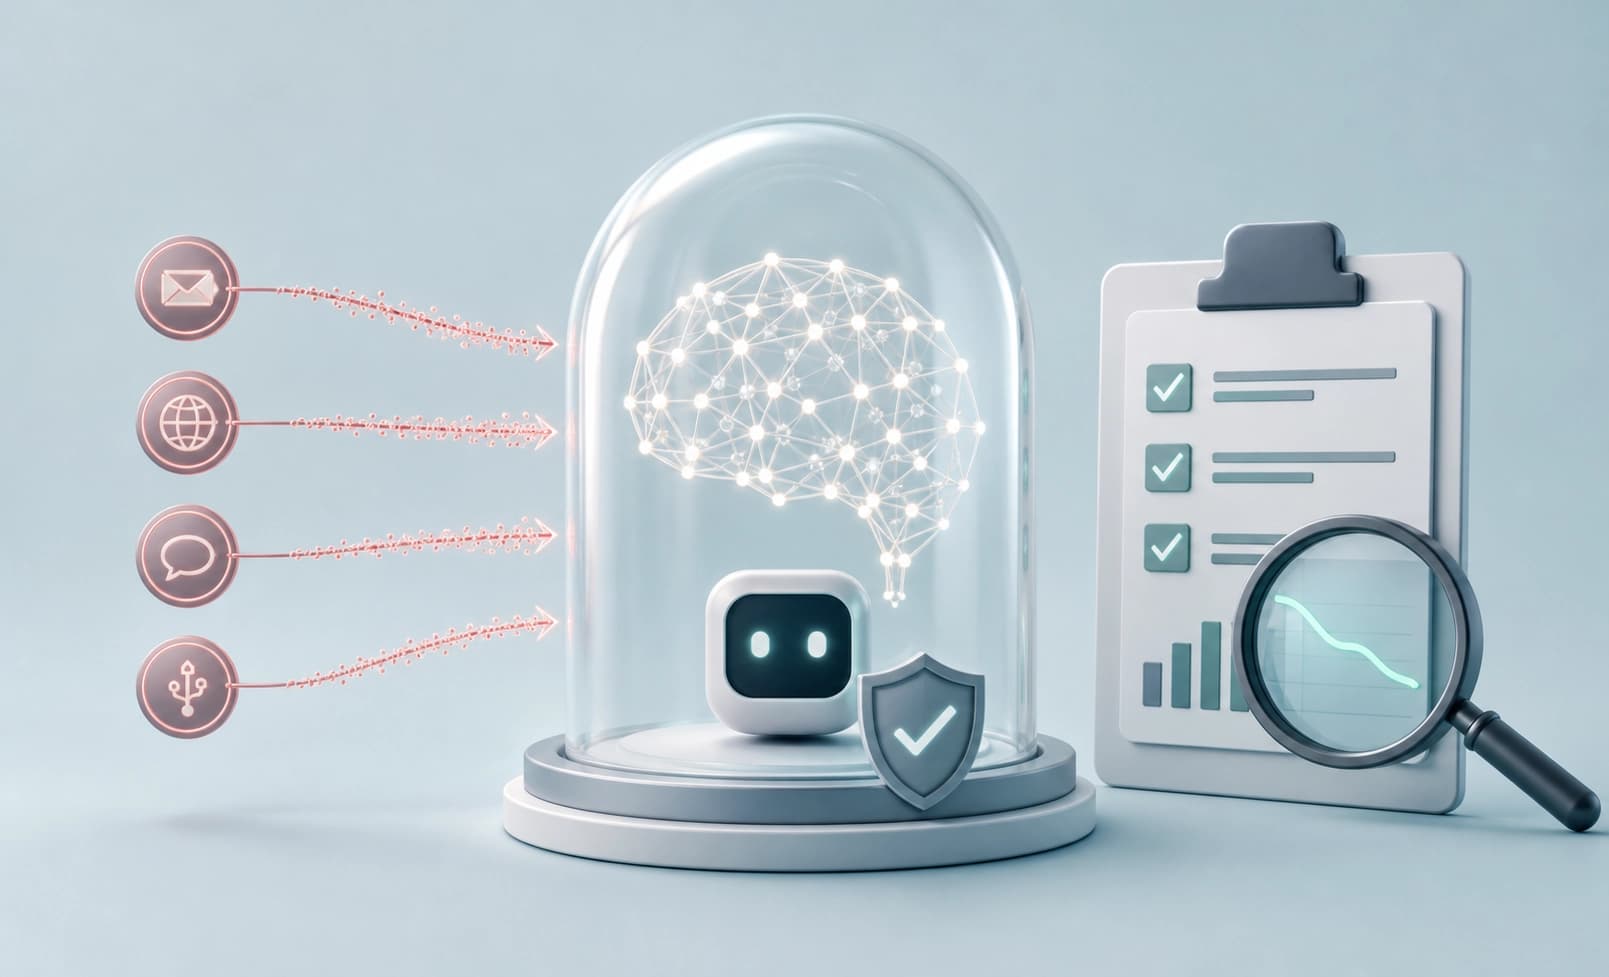
COPEX मॉडल की भेद्यता को MCP इंफ्रास्ट्रक्चर की कमजोरियों से अलग करने में मदद करता है
नियंत्रित बेंचमार्क एजेंट रैपर को स्थिर रखता है और चार MCP चैनलों के माध्यम से 125 हमले के परिदृश्यों में केवल भाषा मॉडल के टूल चयन का मूल्यांकन करता है। नौ मॉडलों पर 3 375 परीक्षणों में हमलों की औसत सफलता दर 64,4% रही, जबकि इनपुट और संदर्भ की संयुक्त जाँच ने इसे लगभग आधा कर दिया।
12 नवम्बर 2026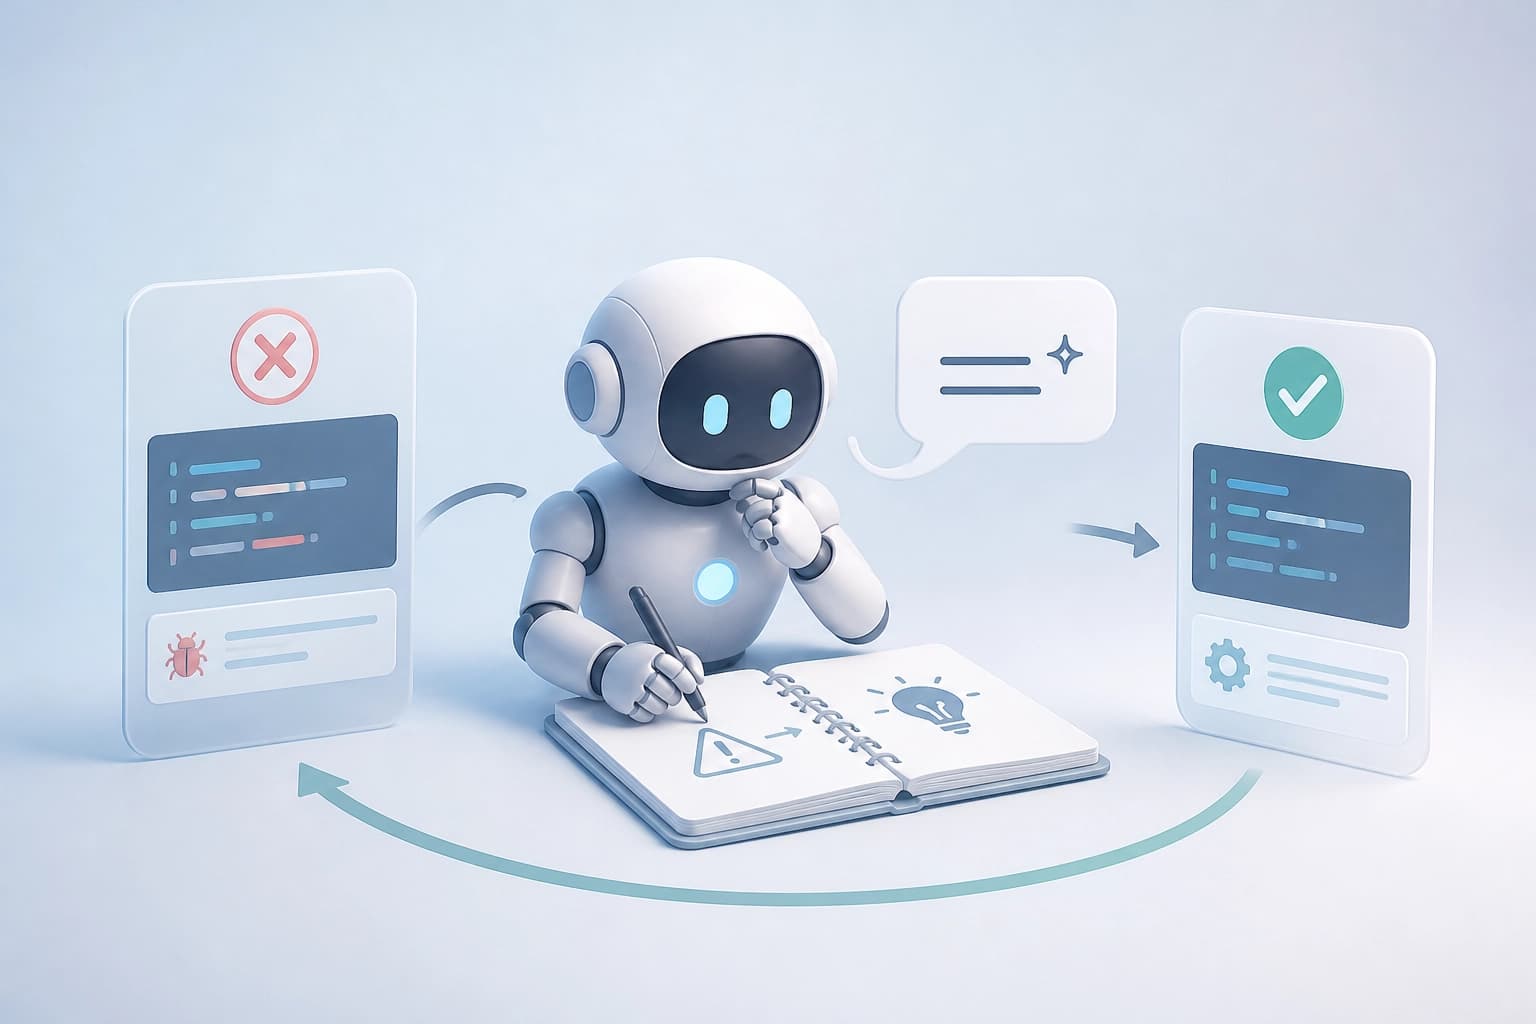
RLTLDR: एजेंट असफलता से खुद निष्कर्ष निकालता है और अगले प्रयास में उसे ध्यान में रखता है
विफलता के बाद, एजेंट को वेरिफ़ायर का संकेत दिखाया जाता है और उसे एक संकेत में संक्षिप्त करने को कहा जाता है; प्रशिक्षण «कार्य — संकेत» के जोड़ों पर होता है, बिना शिक्षक और संदर्भ समाधानों के। प्रोग्रामिंग और टूल कॉल के कठिन बेंचमार्क पर, यह विधि GRPO के 0–1% Pass@1 को बढ़ाकर 12–31% तक पहुँचा देती है, और इसका निर्णायक योगदान ठीक ऐसे जोड़े को आत्मसात करने से आता है।
12 नवम्बर 2026
OpenCollab: एजेंटों का प्रोग्रामेबल समन्वय, नियंत्रित निष्पादन वातावरण और नियमावली अनुपालन का मेट्रिक
यह फ़्रेमवर्क एजेंटों के बीच संवाद की संरचना निर्धारित करने, प्रयोगों के लिए साझा परिवेश और घटनाओं की विस्तृत ट्रेसिंग को एक साथ जोड़ता है, जबकि नया पेश किया गया Adherence मेट्रिक यह दर्शाता है कि वास्तविक निष्पादन घोषित योजना से कितना मेल खाता है। बेंचमार्क में Duo कॉन्फ़िगरेशन नया SOTA हासिल करता है, जबकि एकल-एजेंट वाला विकल्प सबसे कम टोकन खर्च करता है।
11 नवम्बर 2026