
फ्लाइटएलएलएम: कैसे सिमेंटिक भाषा मॉडल विमानन घटनाओं के कारणों को समझाने में मदद करते हैं
फ्लाइटएलएलएम का नया दृष्टिकोण सांख्यिकीय मॉडल और बड़े भाषा मॉडल को जोड़ता है, ताकि उड़ान डेटा को पायलट क्रियाओं की स्पष्ट व्याख्याओं में बदला जा सके। एयरबस A320 के वास्तविक डेटा पर किए गए परीक्षणों से पता चला कि यह विधि सटीक वर्गीकरण और कठोर लैंडिंग के कारणों के सुगम विवरण प्रदान करती है।
उड़ान घटनाओं की व्याख्या क्यों करें?
उड़ान सुरक्षा सीधे तौर पर इस बात पर निर्भर करती है कि हम असामान्य स्थितियों के कारणों को कितनी सटीकता से समझते हैं। खतरनाक घटना जैसे कठोर लैंडिंग का पता लगाना ही पर्याप्त नहीं है — यह समझना ज़रूरी है कि चालक दल के किन कार्यों और उड़ान मापदंडों ने ऐसे परिणाम को जन्म दिया। इसके बिना सिफारिशें विकसित करना और गलतियों की पुनरावृत्ति को रोकना मुश्किल है।
व्याख्यात्मक AI के पारंपरिक तरीके, जैसे फीचर महत्व मानचित्र, दिखाते हैं कि किन कारकों ने निर्णय को प्रभावित किया, लेकिन विश्लेषक से गंभीर डोमेन ज्ञान की आवश्यकता होती है। भाषा मॉडल सुसंगत पाठ्य विवरण बनाने में सक्षम हैं, लेकिन उड़ान डेटा के साथ काम करते समय कठिनाइयाँ उत्पन्न होती हैं: सेंसर से संख्यात्मक संकेतक और पाठ्य रिपोर्ट ठीक से मेल नहीं खाते, मॉडल वर्गीकरण में कमज़ोर हैं, और पुनः प्रशिक्षण के लिए लेबल किया गया डेटा बहुत कम है।
FlightLLM क्या है?
शोधकर्ता FlightLLM दृष्टिकोण प्रस्तावित करते हैं, जो सांख्यिकीय एल्गोरिदम और बड़े भाषा मॉडल की ताकत को जोड़ता है। लक्ष्य केवल यह निर्धारित करना नहीं है कि क्या हुआ, बल्कि यह समझाना भी है कि ऐसा क्यों हुआ। संख्यात्मक "विशेषज्ञ" मापदंडों के विश्लेषण के लिए ज़िम्मेदार है, और भाषा मॉडल मानव-समझने योग्य स्पष्टीकरण उत्पन्न करता है।
समाधान कई ब्लॉकों से मिलकर बना है। पहले फीचर इंजीनियरिंग: सेंसर डेटा में सांख्यिकीय विशेषताएँ और भौतिक रूप से महत्वपूर्ण संकेतक जोड़े जाते हैं, ताकि संख्यात्मक और पाठ्य प्रतिनिधित्व के बीच की खाई को पाटा जा सके। फिर सिमेंटिक डिस्क्रीटाइज़ेशन मॉड्यूल संख्यात्मक पैटर्न को गुणात्मक विवरणों में बदलता है जैसे "ऊर्ध्वाधर गति में तीव्र कमी"। इसके अतिरिक्त, CatBoost को सांख्यिकीय विशेषज्ञ के रूप में उपयोग किया जाता है — इसका पूर्वानुमान प्रॉम्प्ट में जाता है और भाषा मॉडल के लिए संदर्भ बिंदु के रूप में कार्य करता है।
व्याख्या प्रक्रिया कैसे काम करती है?
सिस्टम के इनपुट पर उड़ान रिकॉर्ड दिए जाते हैं। फीचर निष्कर्षण और सिमेंटिक डिस्क्रीटाइज़ेशन के बाद संख्यात्मक डेटा अधिक "मानवीय" रूप धारण कर लेता है। इसके बाद CatBoost घटना का प्रारंभिक मूल्यांकन देता है, जो संरचित प्रॉम्प्ट और उड़ान ज्ञान के साथ बड़े भाषा मॉडल को भेजा जाता है। प्रॉम्प्ट इस तरह बनाए गए हैं कि मॉडल सही और गलत दोनों उदाहरण देख सके — यह एक कंट्रास्टिव फ्यू-शॉट रणनीति है। परिणामस्वरूप, मॉडल एक ऐसी व्याख्या देता है जो सीधे संभावित कारणों की ओर इशारा करती है, न कि केवल सहसंबंधित विशेषताओं की सूची देती है।
FlightLLM का परीक्षण किस पर किया गया?
प्रयोग वास्तविक डेटा पर किए गए: A320 उड़ानों के 704 नमूने। लक्ष्य घटना के रूप में कठोर लैंडिंग को चुना गया।
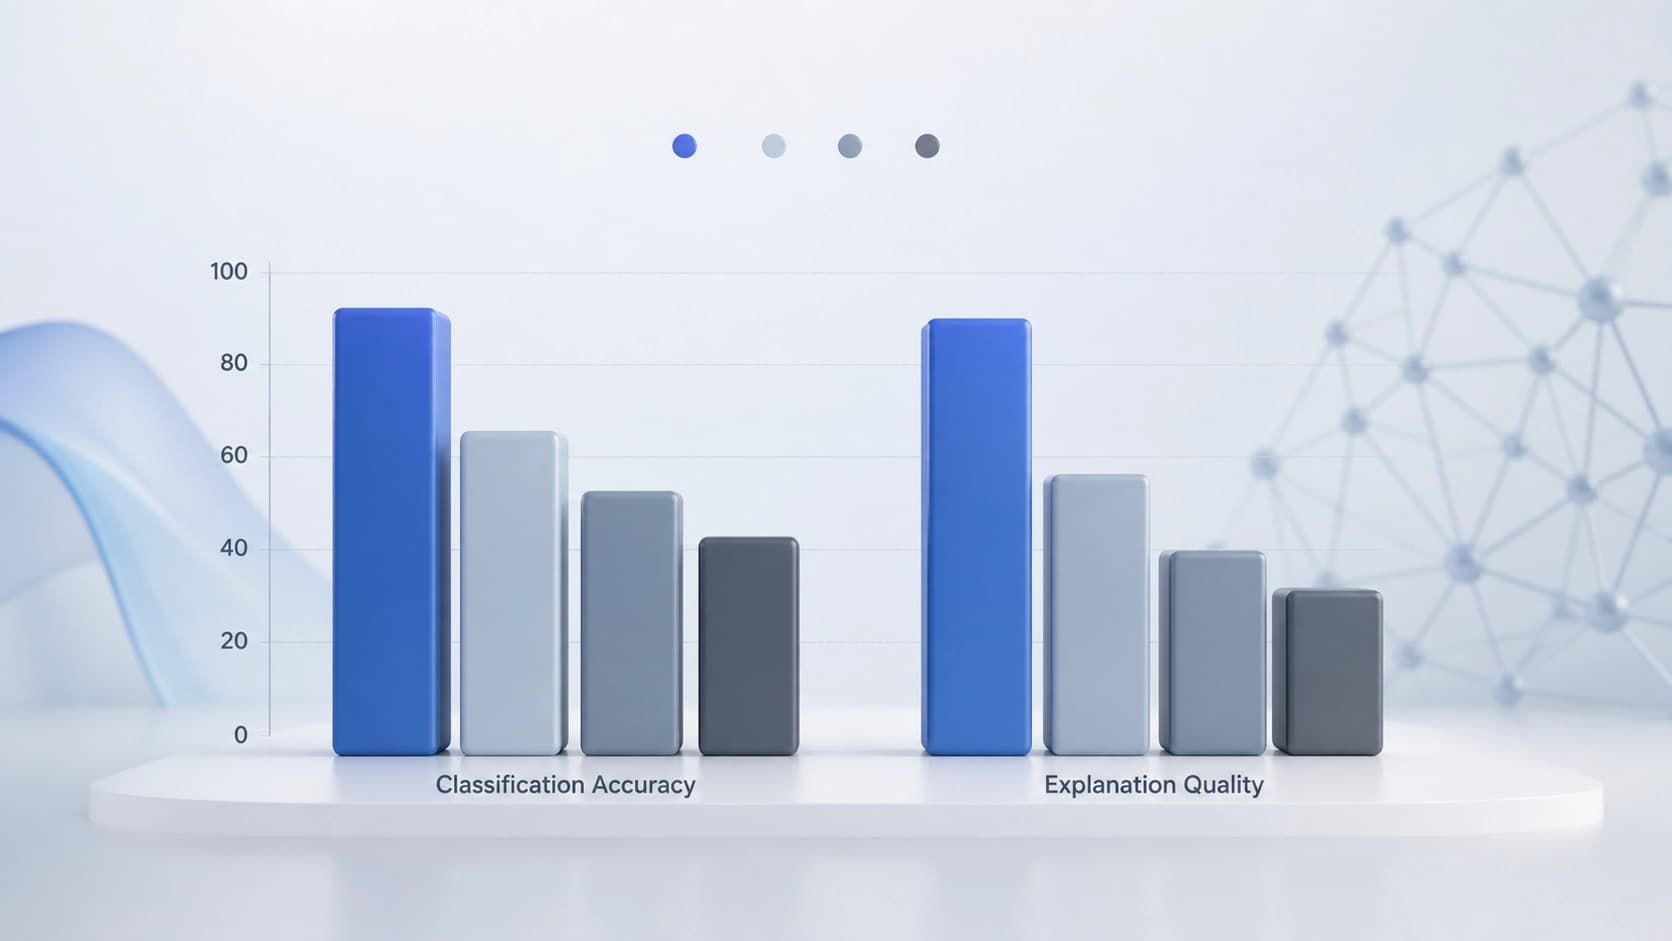
परिणामों से पता चला कि FlightLLM प्रतिस्पर्धी वर्गीकरण सटीकता प्राप्त करता है और साथ ही घटनाओं के कारणों की सीधी और तार्किक व्याख्या देता है। यानी, यह विधि न केवल विशेष वर्गीकरणकर्ताओं से कमतर नहीं है, बल्कि उड़ान विश्लेषण के लिए महत्वपूर्ण व्याख्या भी जोड़ती है।
यह क्यों महत्वपूर्ण है
विमानन में व्याख्यात्मकता कोई विलासिता नहीं, बल्कि आवश्यकता है। पायलट और विश्लेषक एक ऐसा उपकरण प्राप्त करते हैं जो कच्चे डेटा को घटनाओं के समझने योग्य परिदृश्यों में बदलने में मदद करता है। भविष्य में, ऐसी प्रणालियाँ घटना जाँच और चालक दल प्रशिक्षण की मानक प्रक्रियाओं का हिस्सा बन सकती हैं।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री
RL सिम्युलेटरों की विफलताओं के निदान में कैनोनिकल बहुपद अपरिवर्तांक: वे वास्तव में कहाँ उपयोगी हैं
यह अध्ययन जाँचता है कि क्या सीखने योग्य गतिशीलता मॉडल में भौतिक नियमों को शामिल करना उचित है: प्रक्षेप पथों से निकाले गए और ग्रोबनर आधारों के माध्यम से विहित रूप में लाए गए अपरिवर्तक पूर्वानुमानों में मामूली सुधार देते हैं, लेकिन निदान में प्रभावी साबित होते हैं—वे उल्लंघित बाधा का स्थान निर्धारित करने और विशिष्ट गलत पैरामीटर की पहचान करने में सक्षम बनाते हैं।
10 नवम्बर 2026
AURA-Eval: कैसे जाँचें कि LLM एजेंट ने जोखिम को पहचाना और अगला कदम बदल दियाેણ
यह फ्रेमवर्क LLM एजेंटों के व्यवहार का आकलन अंतिम निर्णय के आधार पर नहीं, बल्कि अहम बिंदुओं पर जोखिम के प्रति उनकी प्रतिक्रिया के आधार पर करता है: टूल-कॉल की ट्रैजेक्टरी बीच में रोक दी जाती हैं, जिसके बाद मॉडल को अपना तर्क और कार्रवाई जारी रखनी होती है, जबकि LLM जजों का एक पैनल जोखिम की पहचान, कदम की प्रकृति और उसकी सुरक्षा का विश्लेषण करता है। R-Judge की 157 ट्रैजेक्टरी से संकलित 1249 कार्यों में, 20 मॉडलों में सुरक्षित रास्ता न होने पर असुरक्षित कार्रवाइयाँ बढ़ जाती हैं, और निष्पादन से पहले निगरानी हटाने पर शुरुआत में सुरक्षित रहे 52,3% मामले असुरक्षित हो जाते हैं।
10 नवम्बर 2026
चेर्न–साइमन रिज़र्वॉयर की स्मृति: संयोजकता की स्वायत्त गतिशीलता और घनत्व का परिवहन
यह लेख बताता है कि रिज़र्वॉयर इनपुट संकेतों का इतिहास घनत्व वितरण और ज्यामितीय स्वतंत्रता की डिग्रियों—दोनों में कैसे बनाए रखता है। चार तंत्रों की तुलना से पता चलता है कि धारा एक अलग संयोजकता घटक बनाती है, जो घनत्व की बाद की प्रतिक्रिया को बदलती है, जबकि सभी मापे गए लक्षणों को शामिल करने से पल्स के क्रम को डिकोड करने में थोड़ा सुधार होता है।
10 नवम्बर 2026