समस्या: मॉडल की परीक्षा वहाँ ली जाती है जहाँ अब खोजने की ज़रूरत नहीं
हिस्टोलॉजिकल स्लाइड एक गीगापिक्सेल इमेज होती है। निदान करने के लिए पैथोलॉजिस्ट पहले कम आवर्धन पर नमूने को देखता है, संदिग्ध हिस्सों को चिह्नित करता है, फिर उन्हें नज़दीक से देखता है, अलग-अलग स्केल पर तस्वीर का मिलान करता है और उसके बाद ही निष्कर्ष तैयार करता है। इस काम का एक बड़ा हिस्सा देखने में नहीं, बल्कि खोजने में जाता है: आख़िर कहाँ देखना चाहिए।
AI-पैथोलॉजी के ज़्यादातर मौजूदा बेंचमार्क मॉडल से काम का यह हिस्सा छीन लेते हैं। इनपुट में या तो पहले से काटा गया पैच दिया जाता है, या स्लाइड से पहले ही निकाले गए फ़ीचर — यानी किसी और ने पहले ही तय कर दिया कि यहाँ क्या महत्वपूर्ण है। मॉडल को तैयार सबूत मिलते हैं और वह उन पर तर्क करने की क्षमता दिखाता है। लेकिन वह ख़ुद कितनी अच्छी तरह सबूत जुटाता है — यह लगभग अनपरीक्षित रह जाता है।
EviPathBench का काम ठीक इसी कमी पर केंद्रित है। इसके लेखक हैं Dankai Liao, Tianyi Zhang, Yufeng Wu, Xinyue Zhang, Qiaochu Xue, Zeyu Liu, Dachun Zhao, Linghan Cai और Yueming Jin; प्रीप्रिंट 21 जुलाई 2026 को arXiv पर आया, और 25 अगस्त तक चौथे संस्करण तक पहुँच गया (arXiv:2607.19261, cs.CV / cs.AI)। संशोधनों की यह आवृत्ति ख़ुद ही संकेत देती है: लेखक इस विषय को जीवंत और विवादास्पद मानते हैं।
बेंचमार्क कैसे बना है
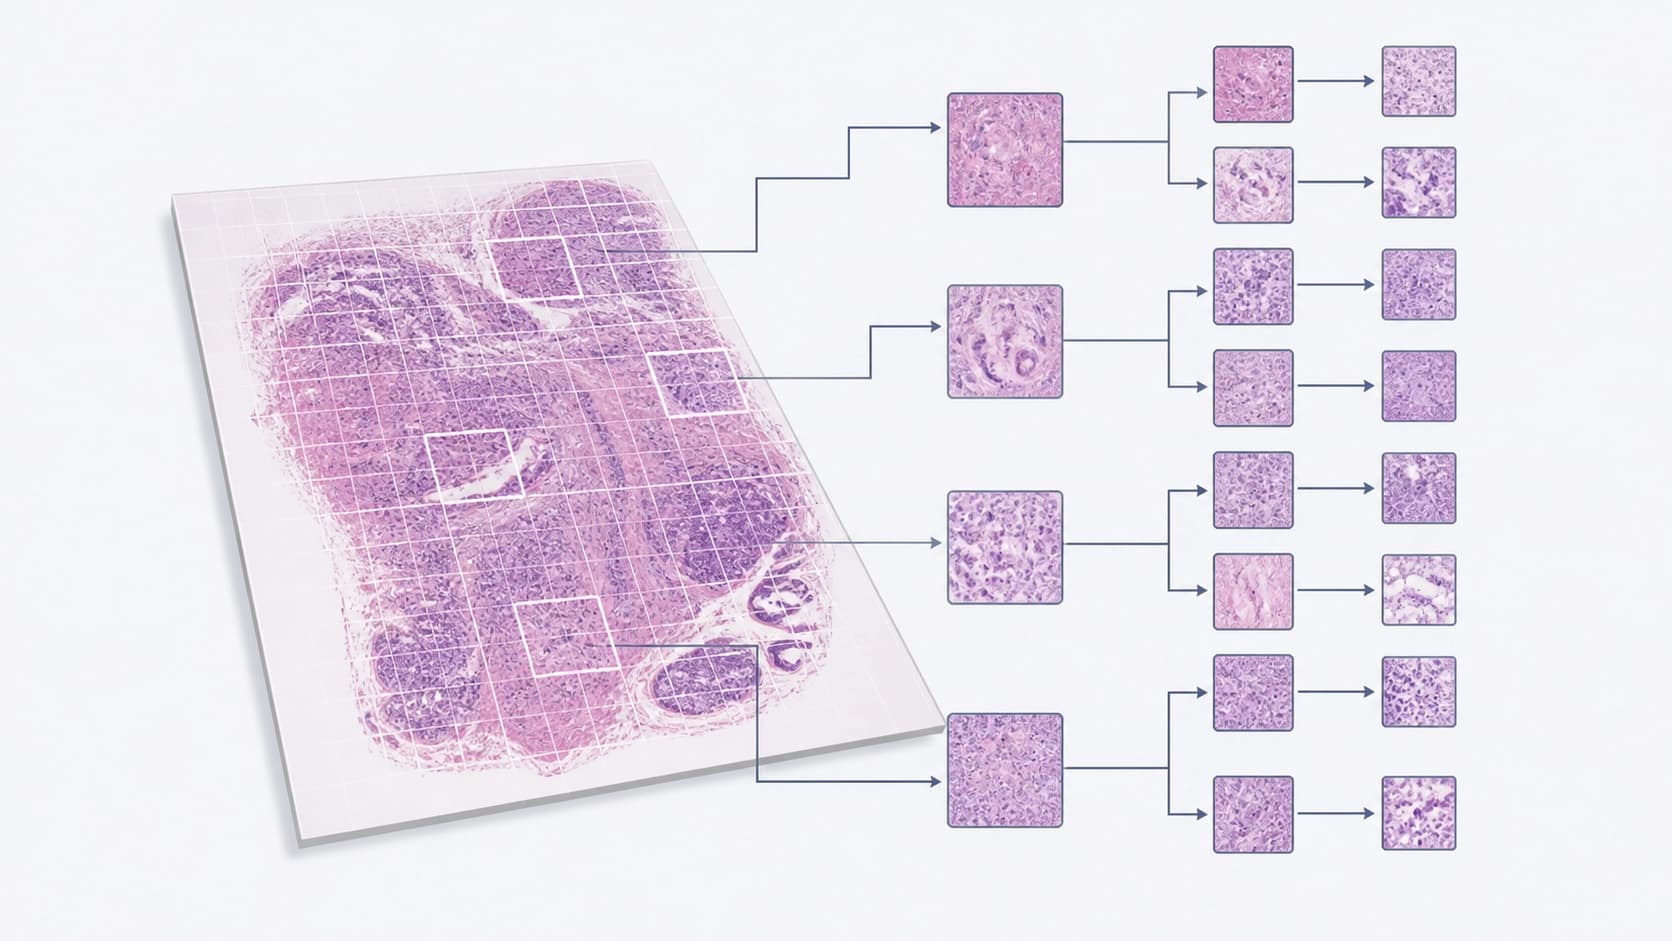
EviPathBench अलग-अलग बहुविकल्पीय सवालों के सेट के रूप में नहीं, बल्कि एक डायग्नोस्टिक ट्री के रूप में बनाया गया है। अलग-अलग आवर्धनों पर एक-दूसरे के भीतर निहित क्षेत्र किसी विशेष स्केल से जुड़ी खोजों से और अंततः पैथोलॉजिकल निष्कर्ष के स्तर के निदान से जुड़े हैं। मॉडल से सिर्फ़ "कैंसर" का लेबल देने की अपेक्षा नहीं है, बल्कि एक श्रृंखला से गुज़रना है: क्षेत्र खोजना, उस आवर्धन पर खोज का वर्णन करना, एक स्तर ऊपर जाना, अलग-अलग स्केलों के डेटा का मिलान करना और उन्हें एक सामान्य निष्कर्ष में समेटना।
चार परीक्षण-योग्य क्षमताएँ
लेखकों ने स्लाइड के साथ काम करने के कौशल को घटकों में बाँटा और हर एक को अलग से आँका:
- इमेज-टेक्स्ट मिलान — सबूत की व्याख्या, जब मॉडल देखी गई चीज़ को विवरण से जोड़ता है।
- इमेज के लिए टेक्स्ट क्वेरी (retrieval) — सत्यापन: किसी वाक्यांश के आधार पर स्लाइड में संबंधित हिस्सा ढूँढना।
- डायग्नोस्टिक क्षेत्र का लोकलाइज़ेशन — असल में सबूत जुटाना: कहाँ ठीक-ठीक देखना है।
- बहु-स्तरीय तर्क — अलग-अलग आवर्धनों पर मिली खोजों को एक साथ एक पूरी तस्वीर में पिरोना।
यह विभाजन अपने आप में मूल्यवान है: यह दिखाता है कि "स्लाइड को समझना" एक क्षमता नहीं, कई क्षमताएँ हैं, और ये आपस में बहुत भिन्न हो सकती हैं।
डेटा और एनोटेशन
आधार में TCGA की 1,822 WSI और 17,135 डायग्नोस्टिक पथ शामिल हैं, जिन्हें दस प्रमाणित पैथोलॉजिस्टों ने एनोटेट किया। अलग से स्तन कैंसर की 190 स्लाइडों का एक निजी कोहोर्ट इस्तेमाल किया गया है, जिसमें विस्तृत एनोटेशन हैं — यह इसलिए ज़रूरी है ताकि पूरे नमूने की स्वायत्त खोज की परीक्षा हो सके, बिना यह बताए कि रुचि का क्षेत्र कहाँ है।
नतीजे: तर्क हो जाता है, खोज नहीं
मूल्यांकन में 19 "विज़न-लैंग्वेज" मॉडल शामिल थे — सामान्य, चिकित्सा और विशेषीकृत पैथोलॉजी वाले — साथ ही एक टेक्स्ट मॉडल-संदर्भ, जो आधार-बिंदु के तौर पर ज़रूरी था।
तस्वीर विरोधाभासी निकली। सर्वश्रेष्ठ ओपन मॉडल बहु-स्तरीय तर्क में 93% से अधिक सटीकता और दोनों क्रॉस-मोडल मिलान कार्यों में 50% से अधिक हासिल करते हैं। लगता है, सब ठीक है।
लेकिन डायग्नोस्टिक क्षेत्र के लोकलाइज़ेशन में — मुसीबत है। text-guided mean IoU में सर्वश्रेष्ठ परिणाम 0.09 तक भी नहीं पहुँचता। यह उस साधारण ह्यूरिस्टिक से भी ख़राब है जो बिना कुछ विश्लेषण किए स्लाइड के केंद्र में एक आयत रख देती है। दूसरे शब्दों में, ऊतक को देखने के लिए प्रशिक्षित मॉडल उस प्रोग्राम से भी बदतर खोजता है जो कहीं देखता ही नहीं।
स्केल खोज को तोड़ देता है
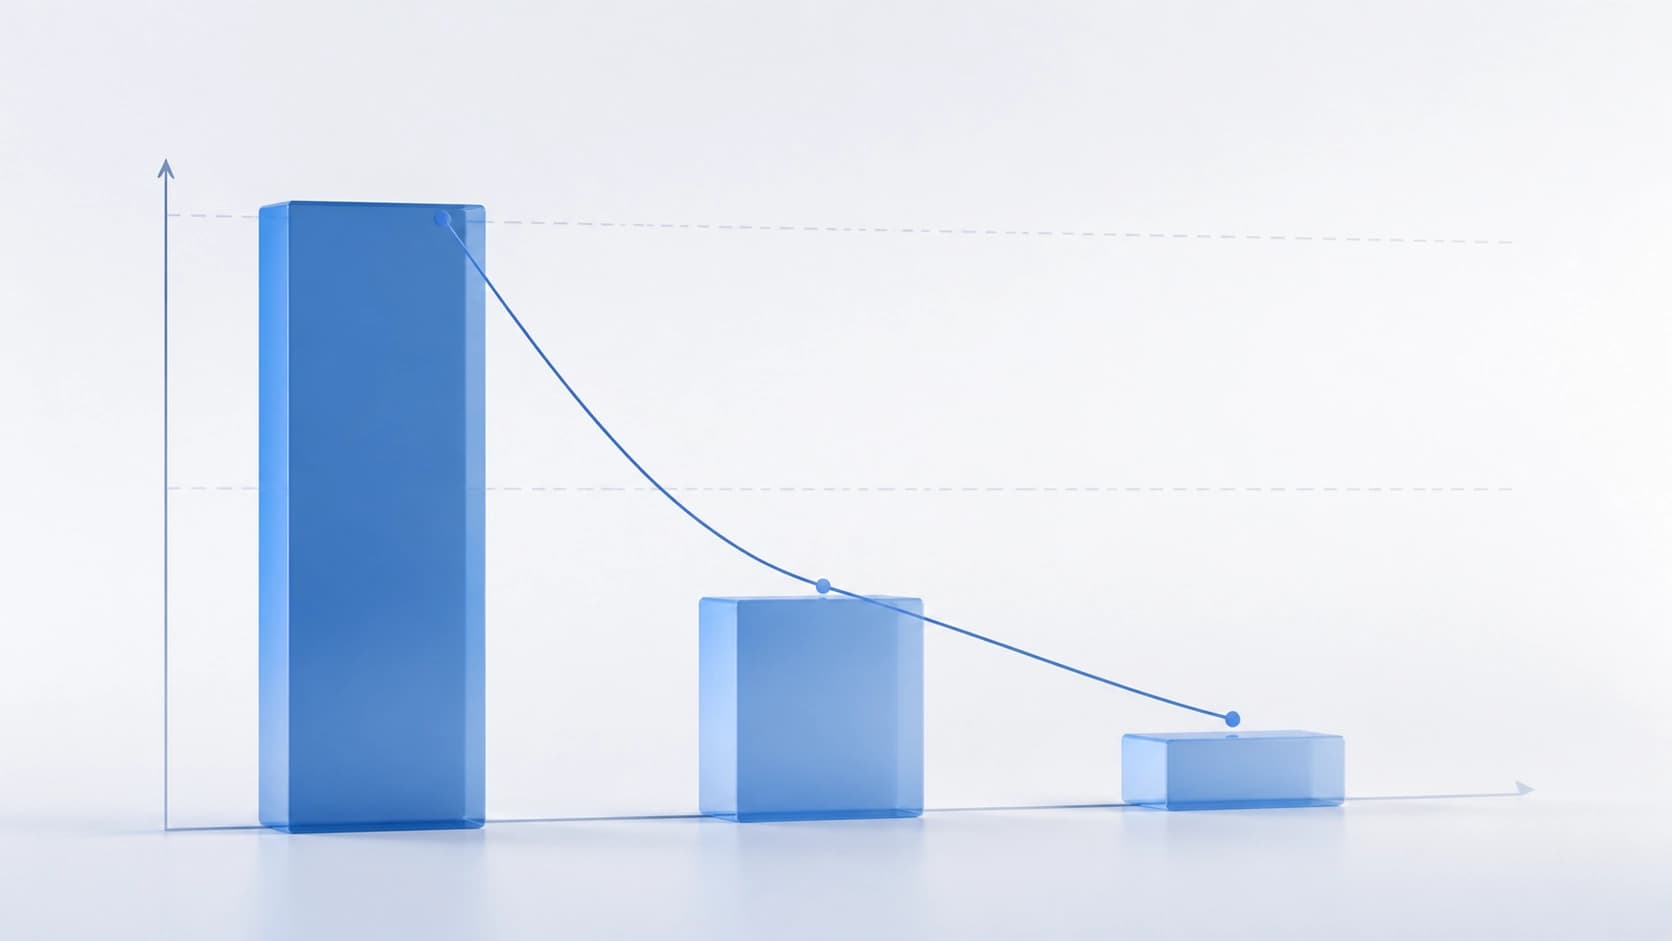
प्रयोग की एक अलग श्रृंखला — स्लाइड की स्वायत्त खोज। यहाँ निरपेक्ष hit rate आवर्धन बढ़ने के साथ गिरता जाता है: कम पर 0.522, मध्यम पर 0.185 और उच्च पर 0.020। गिरावट का तर्क स्पष्ट है: कम आवर्धन पर मॉडल ऊतक की सामान्य संरचना देखता है और आसानी से "किसी सही क्षेत्र में" पहुँच जाता है, लेकिन ज़ूम जितना तेज़ होता है, दृष्टि-क्षेत्र उतना ही संकरा होता है और पिछले चरण की हर ग़लती उतनी ही महँगी पड़ती है। चूकें जमा होती जाती हैं, और अधिकतम आवर्धन तक मॉडल लगभग निश्चित रूप से ग़लत जगह देख रहा होता है।
इससे क्या निकलता है
काम का मुख्य निष्कर्ष सरलता से बनता है: तैयार सबूतों पर तर्क करने की क्षमता और उन सबूतों को जुटाने की क्षमता के बीच गहरा अंतर है। पहला काम आधुनिक मॉडलों से अब ठीक-ठाक हो जाता है, दूसरा — लगभग नहीं होता।
व्यवहार में इसका मतलब है कि स्लाइड पर नेविगेशन अभी मॉडल "के भरोसे" नहीं छोड़ा जा सकता और नैदानिक रूप से सार्थक नतीजे की उम्मीद नहीं की जा सकती। लेकिन बेंचमार्क ख़ुद एक सामान्य फ़्रेमवर्क देता है: इसके ज़रिए दोनों क्षमताओं को मापा जा सकता है और देखा जा सकता है कि कोई विशेष सुधार — रीइन्फ़ोर्समेंट लर्निंग, ज़ूम चरणों के बीच मेमोरी, पदानुक्रमित खोज — जिस हिस्से में असफलता है, उसमें आगे बढ़ने में मदद करता है या नहीं।
कुछ चेतावनियाँ भी ध्यान में रखनी चाहिए। निजी कोहोर्ट स्तन कैंसर तक सीमित है, और डेटा का मुख्य हिस्सा TCGA की पूर्वव्यापी सामग्री है, यानी वास्तविक नैदानिक विविधता वहाँ पूरी तरह प्रस्तुत नहीं है। लोकलाइज़ेशन मेट्रिक्स इस बात के प्रति संवेदनशील हैं कि क्षेत्रों की सीमाएँ कैसे एनोटेट की गईं, और एक महीने में प्रीप्रिंट के चार संस्करण यह बताते हैं कि आँकड़े अभी और सटीक हो सकते हैं।