
DiSCO: टेक्स्ट-टू-इमेज को हानिकारक सामग्री से सुरक्षित करना, बिना मॉडल के आंतरिक भागों तक पहुंच के
नया DiSCO तरीका एक बाहरी मॉड्यूल की तरह काम करता है: यह सुरक्षित प्रॉम्प्ट चुनता है और असुरक्षित मॉडलों के लिए सफल red-team हमलों की दर को 37.7% तक और पहले से सुरक्षित सिस्टम के लिए 25.13% तक कम कर देता है। साथ ही, सिमेंटिक सटीकता बनी रहती है, और छवियों की सुसंगतता (कोहरेंस) में भी सुधार होता है।
सामान्य प्रॉम्प्ट्स में छिपा खतरा
आधुनिक न्यूरल नेटवर्क जो टेक्स्ट विवरण से इमेज उत्पन्न करते हैं, प्रभावशाली चित्र बनाने में सक्षम हैं, लेकिन कभी-कभी अवांछित सामग्री "दे" देते हैं। आमतौर पर ऐसी प्रणालियों की सुरक्षा उनके आंतरिक ढांचे में हस्तक्षेप पर आधारित होती है: टेक्स्ट एन्कोडर को फिर से प्रशिक्षित करना, वेट्स को समायोजित करना, या इन्फ्रेंस चरण में विशेष प्रोसेसिंग करना। यह दृष्टिकोण तब तक प्रभावी है जब तक आपके पास मॉडल तक पहुंच है, लेकिन यह "ब्लैक बॉक्स" सिद्धांत पर काम करने वाली बंद मालिकाना सेवाओं के लिए पूरी तरह से अनुपयुक्त है।
विकल्प के रूप में, बड़े भाषा मॉडल का उपयोग स्वचालित रूप से प्रॉम्प्ट्स को सुरक्षित रूप में फिर से लिखने के लिए किया जाता है। लेकिन यहाँ भी एक कमजोर बिंदु है: प्रॉम्प्ट भाषाई रूप से पूरी तरह से हानिरहित हो जाता है, फिर भी मॉडल ने प्रशिक्षण के दौरान डेटा को जिस तरह वितरित किया है, उसके कारण जनरेशन फिर भी हानिकारक क्षेत्र में चला जाता है। लेखक इस मोड को "benign adversarial" कहते हैं — जब टेक्स्ट औपचारिक रूप से सुरक्षित होता है, लेकिन परिणाम नहीं होता।
DiSCO क्या प्रस्तावित करता है
DiSCO (Distribution-guided contrastive prompt optimization) विधि, जो शोधकर्ताओं के एक समूह द्वारा विकसित की गई है, एक पूरी तरह से अलग रास्ता प्रस्तावित करती है: मॉडल के अंदर झाँके बिना प्रॉम्प्ट स्तर पर जनरेशन की सुरक्षा करना। यह एक सख्त black-box समाधान है जो बाहरी plug-and-play मॉड्यूल के रूप में काम करता है। इसे फाइन-ट्यूनिंग, री-ट्रेनिंग या लक्ष्य प्रणाली के मापदंडों और आर्किटेक्चर के बारे में किसी भी जानकारी की आवश्यकता नहीं होती।
विचार यह है कि सफिक्स — यानी प्रॉम्प्ट का अंतिम भाग — को स्वचालित रूप से इस तरह संशोधित किया जाए कि जनरेशन सुरक्षित दिशा में चला जाए। उपयुक्त सफिक्स की खोज beam search का उपयोग करके की जाती है, और उम्मीदवारों की गुणवत्ता का मूल्यांकन कंट्रास्टिव स्कोरिंग द्वारा किया जाता है। इसके लिए मॉड्यूल पहले से लक्ष्य मॉडल का उपयोग करके इमेज के दो पूल उत्पन्न करता है: सुरक्षित और असुरक्षित। जनरेशन परिणामों की तुलना संदर्भ पूल से करके, DiSCO समझता है कि सफिक्स को किस दिशा में "धकेलना" है।
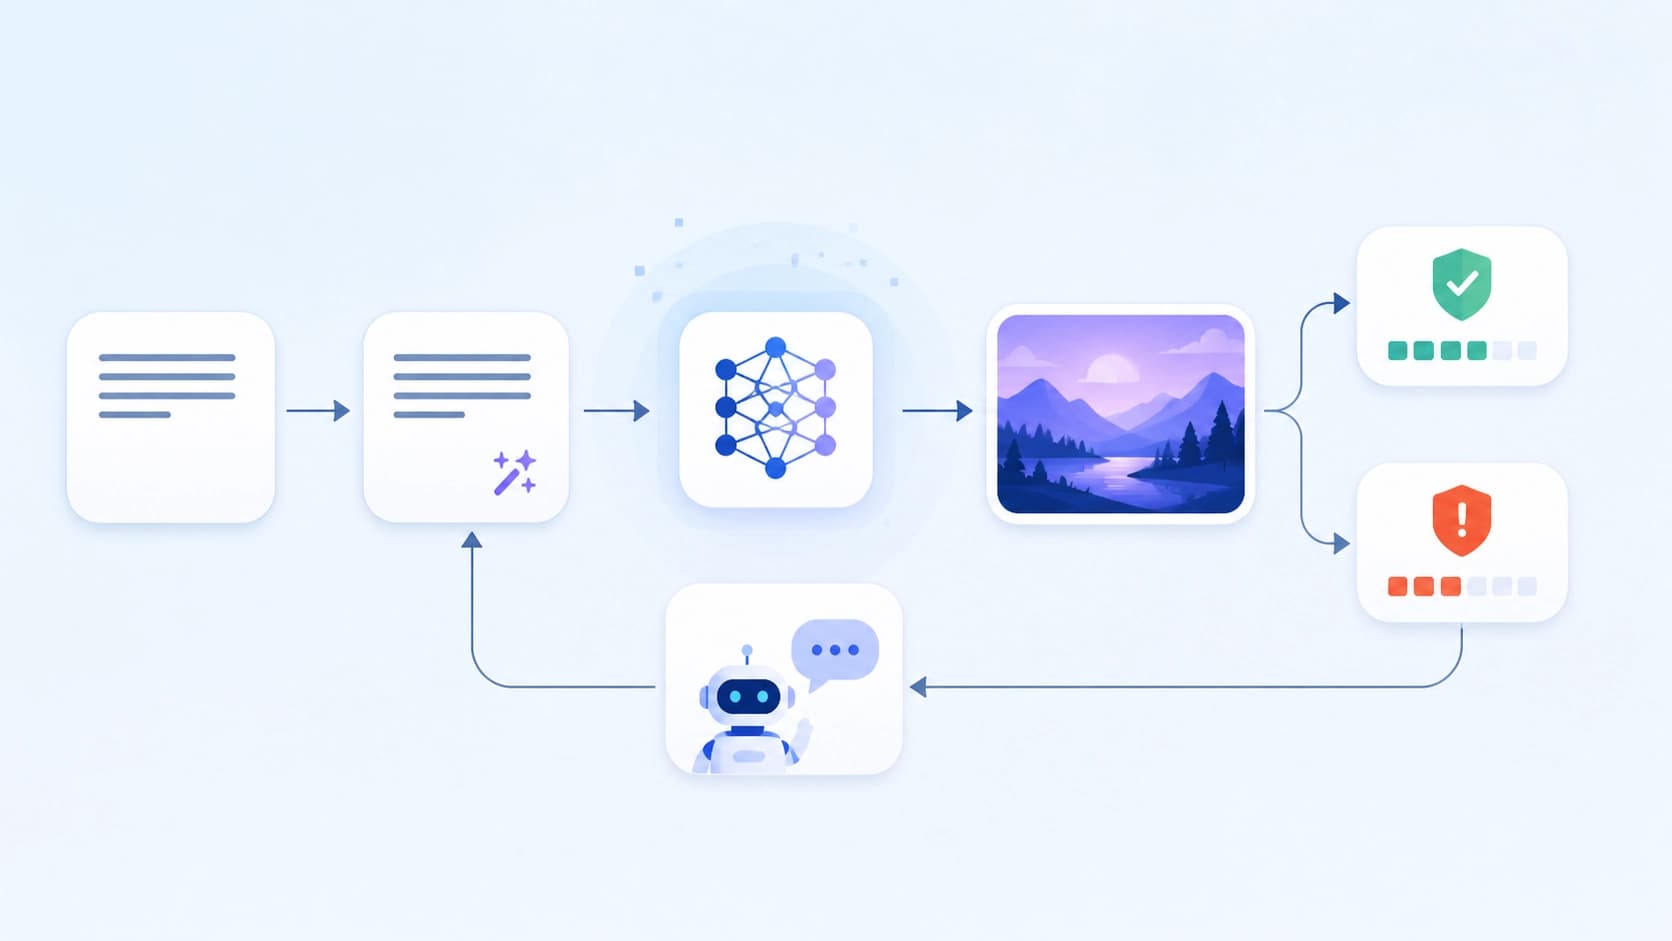
प्रक्रिया पुनरावृत्त है: प्रत्येक चरण के बाद मॉड्यूल प्राप्त इमेज का मूल्यांकन करता है, और यदि इसमें अभी भी अवांछित तत्व हैं, तो सफिक्स को फिर से समायोजित करता है। यह तब तक जारी रहता है जब तक जनरेशन सुरक्षित पूल के अनुरूप नहीं हो जाता। इस दौरान किसी भी चरण में मॉडल के आंतरिक भागों को उजागर करने की आवश्यकता नहीं होती — सभी इंटरैक्शन केवल प्रॉम्प्ट भेजने और इमेज प्राप्त करने के माध्यम से होते हैं।
यह कितना प्रभावी है
शोधकर्ताओं ने DiSCO का परीक्षण I2P (Inappropriate Image Prompts) बेंचमार्क पर कई red-teaming हमलों के परिदृश्यों में किया। परिणाम दिखाते हैं कि बिना किसी सुरक्षा वाले मॉडल के लिए सफल हमलों की दर 37.7% कम हो जाती है, और उन मॉडलों के लिए 25.13% कम हो जाती है जो पहले से अन्य तरीकों से सुरक्षित थे। इसका मतलब है कि DiSCO न केवल उन जगहों पर छेद बंद करता है जहाँ सुरक्षा नहीं है, बल्कि मौजूदा बाधाओं को भी मजबूत करता है।
यह उल्लेखनीय है कि इस दौरान सिमेंटिक सटीकता प्रभावित नहीं होती: उत्पन्न इमेज मूल प्रॉम्प्ट के लिए प्रासंगिक बनी रहती हैं, और सुसंगतता में भी सुधार होता है। दूसरे शब्दों में, मॉड्यूल जनरेशन की गुणवत्ता को खराब नहीं करता, बल्कि इसे संभावित खतरनाक व्याख्याओं से दूर ले जाता है।
चूंकि DiSCO आर्किटेक्चर-अज्ञेयवादी है, इसे बिना मॉडल बदले किसी भी text-to-image प्रणाली से जोड़ा जा सकता है। यह विशेष रूप से बंद वाणिज्यिक API के लिए मूल्यवान है, जहाँ पहुंच सीमित है, और उन उपयोगकर्ताओं के लिए जो अन्य सेवाओं की सुरक्षा बढ़ाना चाहते हैं — उदाहरण के लिए, सार्वजनिक अनुप्रयोगों में उपयोग से पहले।
प्रभावशाली परिणामों के बावजूद, यह याद रखना चाहिए कि यह विधि कोई "चांदी की गोली" नहीं है, बल्कि सुरक्षा की एक परत है। जोखिमों को पूरी तरह से समाप्त करना शायद ही संभव होगा, लेकिन दृष्टिकोण को "आंतरिक" सुरक्षा से "बाहरी" और अनुकूली सुरक्षा की ओर स्थानांतरित करना — जनरेटिव प्रणालियों को दुर्भावनापूर्ण अनुरोधों के प्रति लचीला बनाने की दिशा में एक महत्वपूर्ण कदम है।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री
STAR: एंड-टू-एंड घटना प्रबंधन के लिए समय-संदर्भ और सेवा ग्राफ का अनुकूली सामान्यीकरण
STAR फ्रेमवर्क मेट्रिक्स, लॉग और ट्रेस के आधार पर अभ्यावेदन सीखता है। इसके लिए यह बहुस्तरीय समयगत गतिशीलता और सेवाओं के बीच निर्भरता संरचना को ध्यान में रखते हुए सीखने योग्य सामान्यीकरण लागू करता है। दो वास्तविक डेटासेट पर यह पाइपलाइन आधुनिक आधारभूत विधियों की तुलना में विसंगति पहचान, विफलताओं की रैंकिंग और मूल कारणों की खोज की गुणवत्ता में लगातार सुधार करती है।
10 नवम्बर 2026
चेर्न–साइमन रिज़र्वॉयर की स्मृति: संयोजकता की स्वायत्त गतिशीलता और घनत्व का परिवहन
यह लेख बताता है कि रिज़र्वॉयर इनपुट संकेतों का इतिहास घनत्व वितरण और ज्यामितीय स्वतंत्रता की डिग्रियों—दोनों में कैसे बनाए रखता है। चार तंत्रों की तुलना से पता चलता है कि धारा एक अलग संयोजकता घटक बनाती है, जो घनत्व की बाद की प्रतिक्रिया को बदलती है, जबकि सभी मापे गए लक्षणों को शामिल करने से पल्स के क्रम को डिकोड करने में थोड़ा सुधार होता है।
10 नवम्बर 2026
उम्मीदवारों का सत्यापन उन्हें उत्पन्न करने से अधिक महँगा है: LLM-आधारित भेद्यता खोज के विरुद्ध प्रलोभन
इस काम में एजेंट-आधारित दोष खोज की लागत संबंधी विषमता का विश्लेषण किया गया है: संस्करण बनाना सस्ता है, जबकि पहुँच-योग्यता विश्लेषण, निष्पादन और PoC के ज़रिए उनकी पुष्टि करने में अधिकांश बजट खर्च होता है। इसलिए सत्यापन को रक्षा का एक स्वतंत्र लक्ष्य बनाया जा सकता है। प्रस्तावित RedHerring—रिपॉज़िटरी के अनुरूप ढाली गई, सीलबंद प्रमाणपत्र वाली decoy—ने समान लागत पर 33 OSS-Fuzz परियोजनाओं में पाई गई वास्तविक कमज़ोरियों की संख्या 38.7–60.4% तक घटा दी; एजेंट को चेतावनी देने के बाद भी यह गिरावट 37.2% पर बनी रही।
9 नवम्बर 2026