
CHOIR विधि: स्वतंत्र सूचीकरण सामूहिक प्रणालियों के भीतर मॉडलों के परस्पर असंगत रुखों को उजागर करता है
लेखक CHOIR नामक एक दृष्टिकोण प्रस्तुत करते हैं, जिसमें समूह बार-बार क्रमबद्ध उत्तर-सूचियाँ माँगते हैं और फिर मॉडलों, प्रॉम्प्ट की शब्दावली तथा भूमिका-आधारित परिस्थितियों के बीच संयुक्त अवधारणाओं की प्रमुखता की तुलना करते हैं। यह अध्ययन दिखाता है कि खुले उत्तरों में बाहरी समानता अधिक होने का अर्थ यह नहीं कि सभी एकमत हैं: आधारभूत मॉडल की पहचान सबसे स्थिर भेदकारी विशेषता बनी रहती है, जबकि व्यक्तित्व संबंधी निर्देश प्रकट होने वाली अवधारणाओं को बदल देते हैं।
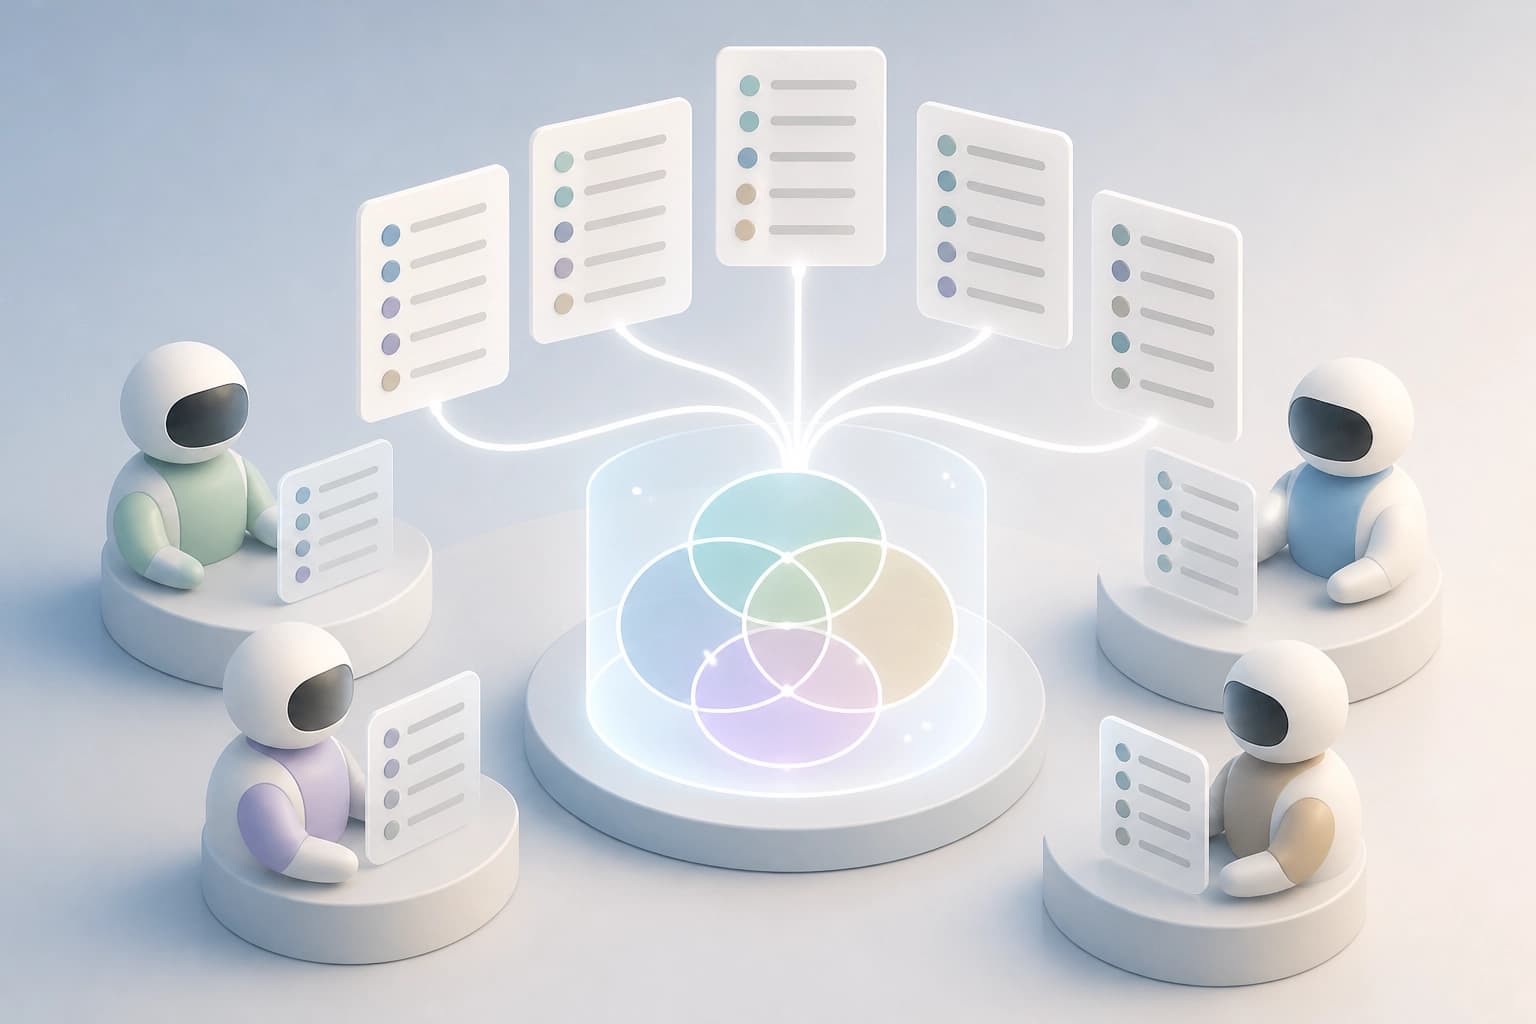
CHOIR क्या देता है
CHOIR का पूरा नाम Collective Hierarchically-Ordered Inquiry Responses है। यह तरीका LLM के समूहों के लिए मुक्त-सूची elicitation को अनुकूलित करता है। इसका उद्देश्य उन बिंदुओं को उजागर करना है जहाँ समूह के भीतर मॉडल अलग-अलग राय रखते हैं। जवाबों में सतही सहमति इन मतभेदों को छिपा देती है।
यह तरीका तैयार वाक्यांशों के बजाय सूचियों के साथ काम करता है। बार-बार किए गए अनुरोधों से यह सामग्री मिलती है कि मॉडल खुद कौन-से विषय उठाते हैं। इसके बाद इस सामग्री को तुलनीय रूप में बदला जाता है।
व्यावहारिक कसौटी: जब समूह के जवाब एक जैसे दिखें, लेकिन यह समझना हो कि मॉडल ठीक कहाँ असहमत हैं, तब CHOIR का उपयोग करें।
तरीके के चरण
यह तरीका तीन चरणों पर आधारित है।
- समूह के मॉडलों से रैंक की गई सूचियों के लिए बार-बार अनुरोध करना।
- सूचियों की प्रविष्टियों को प्रॉम्प्ट-स्तर की अवधारणाओं में मिलाना।
- मॉडलों, प्रॉम्प्ट के प्रकारों और पर्सोना वाली स्थितियों में अवधारणाओं की प्रमुखता मापना।
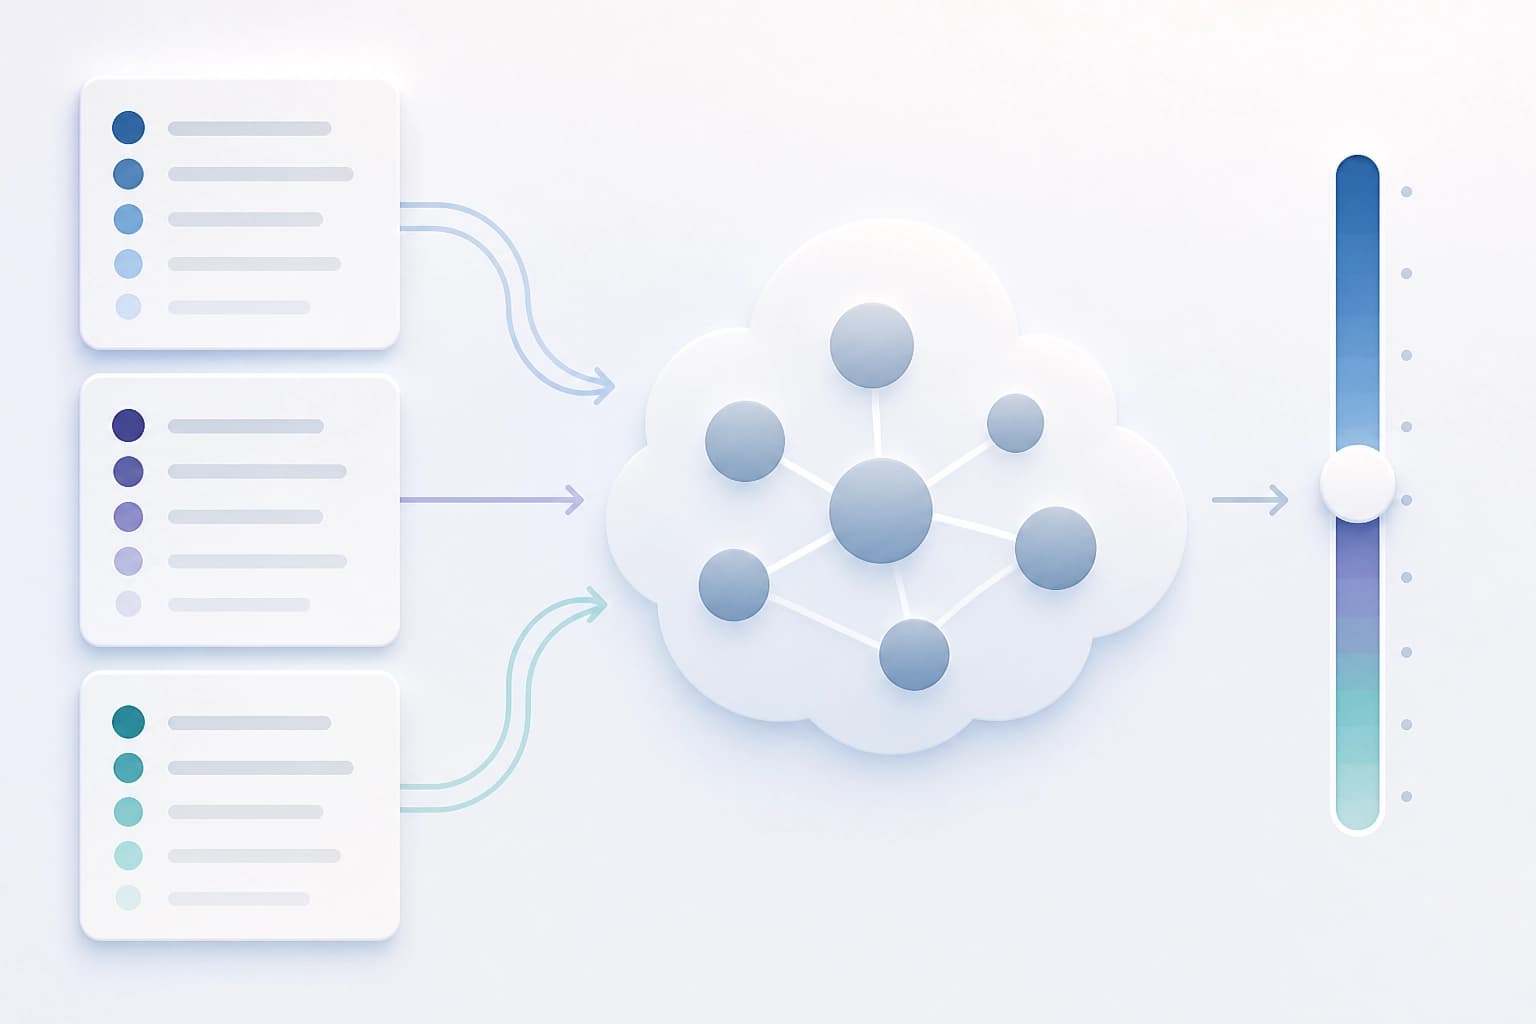
हर चरण एक नया आयाम जोड़ता है। सूचियाँ कच्ची सामग्री देती हैं, उन्हें मिलाने से सामग्री तुलनीय रूप लेती है, और प्रमुखता का मापन अंतर दिखाता है। अवधारणाओं में बदले बिना तुलना अलग-अलग शब्दों के स्तर पर ही रहती है।
व्यावहारिक कसौटी: जाँचें कि प्रविष्टियों को अवधारणाओं में मिलाने के बाद भी यह तरीका अंतर को बनाए रखता है या नहीं।
किन डेटासेट पर जाँच की गई
| डेटासेट | यह क्या है | इससे क्या पता चला |
|---|---|---|
| Infinity-Chat 100 | खुले जवाबों में मॉडलों की एकरूपता पर हालिया अध्ययन का बाहरी प्रॉम्प्ट डेटासेट | सतही सहमति का उच्च स्तर दोहराकर दिखाता है: 93/100 प्रॉम्प्ट संयोग से अपेक्षित स्तर से ऊपर हैं। यह संकीर्ण प्रॉम्प्ट और उन व्यापक प्रॉम्प्ट के बीच अंतर करता है जिनमें जवाबों की छिपी हुई गहराई सामने आती है |
| लक्षित नैदानिक डेटासेट | तंत्र के स्तर पर अंतर उजागर करने के लिए 27 प्रश्न | मॉडलों के बीच मतभेदों की लक्षित जाँच के लिए उपयोगी है |
ये डेटासेट अलग-अलग काम करते हैं। बाहरी डेटासेट सहमति की समग्र तस्वीर दिखाता है और साथ ही व्यापक प्रॉम्प्ट को संकीर्ण प्रॉम्प्ट से अलग करता है। लक्षित डेटासेट तंत्र के स्तर पर अंतर पहचानने के लिए बनाया गया है।
चयन की कसौटी: सहमति की तस्वीर के लिए बाहरी प्रॉम्प्ट डेटासेट लें, और तंत्रों के विश्लेषण के लिए नैदानिक डेटासेट।
अंतर के कौन-से संकेत दिखते हैं
अवलोकन तीन समूहों में बँटते हैं।
- मूल मॉडल की पहचान सबसे मज़बूत पुनर्प्राप्त किए जा सकने वाले संकेत के रूप में बनी रहती है। यह लक्षित जाँचों और बाहरी प्रॉम्प्ट डेटासेट, दोनों के लिए सही है।
- पर्सोना वाले प्रॉम्प्ट, मूल मॉडलों के सिग्नेचर के भीतर उभरने वाली अवधारणाओं को बदल देते हैं।
- स्रोत की जानकारी के बिना काम करने वाला रैंकिंग मॉड्यूल आगे अध्ययन के लिए दुर्लभ, लेकिन स्थिर उम्मीदवारों को सामने लाता है।
पर्सोना अवधारणाओं की अभिव्यक्ति बदलते हैं, लेकिन मूल मॉडल के संकेत को ढकते नहीं हैं। स्रोत की जानकारी के बिना की गई रैंकिंग आगे के विश्लेषण के लिए एक फ़िल्टर की तरह काम करती है।
व्यावहारिक कसौटी: पहले मूल मॉडल तय करें, फिर पर्सोना से आए बदलाव का आकलन करें।
सहमति दर्ज करने के बजाय नैदानिक रूपरेखा
लेखक खुले जवाबों की एकरूपता को नैदानिक समस्या के रूप में देखने का सुझाव देते हैं। तब सवाल कुछ यूँ बनता है: मॉडल कहाँ सहमत होते हैं, वे सहमत क्यों होते हैं, और क्या कुछ और भी पता लगाया जा सकता है।
- कहाँ सहमत होते हैं — मॉडलों के बीच मेल खाने वाली अवधारणाओं का मानचित्र।
- सहमत क्यों होते हैं — सतही सहमति के पीछे के कारण।
- और क्या दिखता है — स्रोत की जानकारी के बिना रैंकिंग से सामने आने वाले उम्मीदवार।
यह लेख Proceedings of the Third Conference on Language Modeling (COLM 2026), 2026 में प्रकाशित हुआ। इसे arXiv पर 29 सितंबर 2026 को जमा किया गया। लेखक Ben Wigler और Maria Tsfasman हैं।
कसौटी: जवाबों की एकरूपता अंतिम निष्कर्ष नहीं, बल्कि उनकी गहराई का निदान करने का शुरुआती बिंदु है।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री
प्रायिकता सिम्प्लेक्स की ओर संक्रमण कंट्रास्टिव मल्टीमॉडल मॉडलों में मोडैलिटी गैप को कम करता है
arXiv:2610.32890 में गोलाकार एम्बेडिंग्स की जगह प्रायिकता सिम्प्लेक्स का उपयोग करने का प्रस्ताव है, जिसमें हल्के softmax अडैप्टर और Total Variation समानता जोड़ी गई है। खोज के पाँच बेंचमार्क पर, खोज की गुणवत्ता बनाए रखते हुए या बढ़ाते हुए, मोडैलिटी के बीच सेंट्रॉइड ℓ2 दूरी 97–99% तक घट जाती है।
3 नवम्बर 2026
LLM एजेंटों के मेमोरी ग्राफ़ में प्रसार के दौरान ActionRAG साक्ष्यों की पुनर्समीक्षा कैसे करता है
एक ग्राफ़ मेमोरी आर्किटेक्चर प्रस्तावित किया गया है, जो इंडेक्सिंग के दौरान इकाइयों का सावधानीपूर्वक मिलान करता है और क्वेरी मिलने पर स्थानीय संरचना के आधार पर संबंधों का फिर से आकलन करता है। MemoryAgentBench पर इस विधि ने 55.1 की औसत सटीकता हासिल की और सबसे मज़बूत रिट्रीवल बेसलाइन से 5.4 प्रतिशत अंक बेहतर प्रदर्शन किया।
3 नवम्बर 2026
पंद्रह कंपनियों ने माइनिंग के स्वचालन के लिए MDK Tether का समर्थन किया
उपकरण निर्माताओं, पूलों और ऑपरेटरों ने उपकरणों की निगरानी और प्रबंधन को एकीकृत करने के लिए Tether के ओपन स्टैक के साथ इंटीग्रेशन विकसित करने की जिम्मेदारी ली है; AI एजेंट QVAC पहले से ही इसी आधार पर काम कर रहा है। बिजली की लागत में कमी या दक्षता में वृद्धि की स्वतंत्र पुष्टि अभी तक प्रकाशित नहीं हुई है।
2 नवम्बर 2026