सिमुलेशन क्या जाँचता है
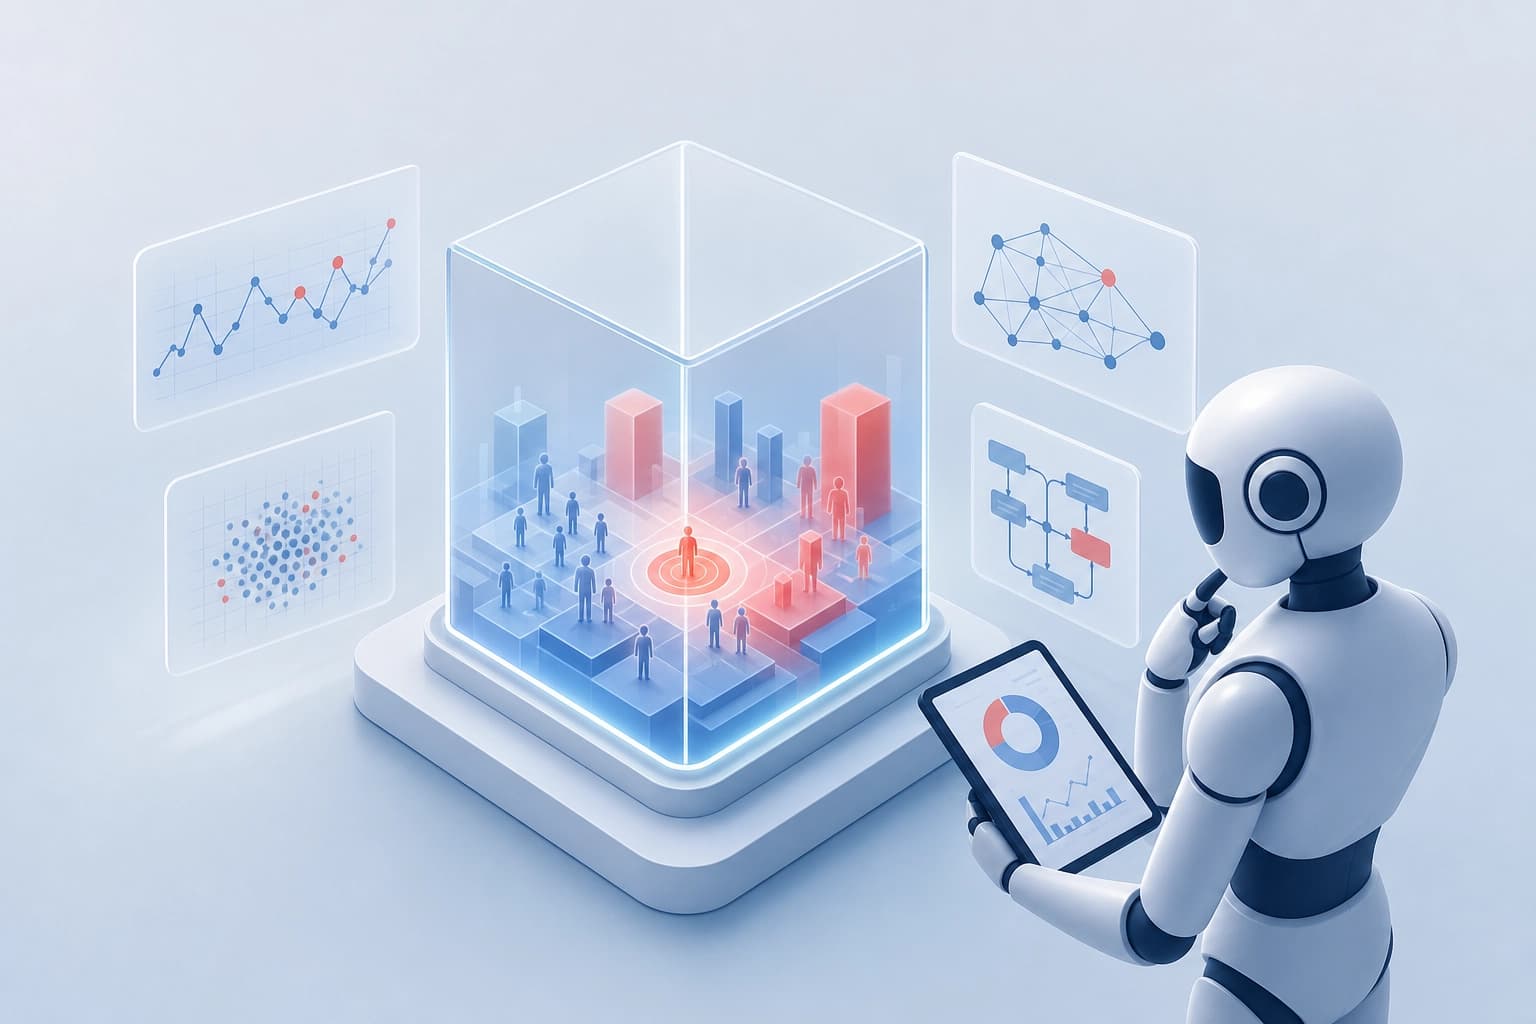
TRACE डिजिटल विज्ञापन के लिए एक निदानात्मक वातावरण है। इसमें 12 मूल कारण और सेगमेंट का विस्तृत एट्रिब्यूशन शामिल है। प्रत्येक एपिसोड में एजेंट Python और SQL का उपयोग करके डेटा की पड़ताल करता है। फिर वह मूल कारण और, जहाँ लागू हो, प्रभावित सेगमेंट की पहचान करता है।
TRACE का वर्णन Rui Sun, Zhan Shi और Bing He के उस शोधपत्र में किया गया है, जिसे 9 सितंबर 2026 को arXiv पर प्रस्तुत किया गया था। शोधपत्र का पहचानकर्ता arXiv:2609.10315 है।
जाँच कैसे तैयार की जाती है
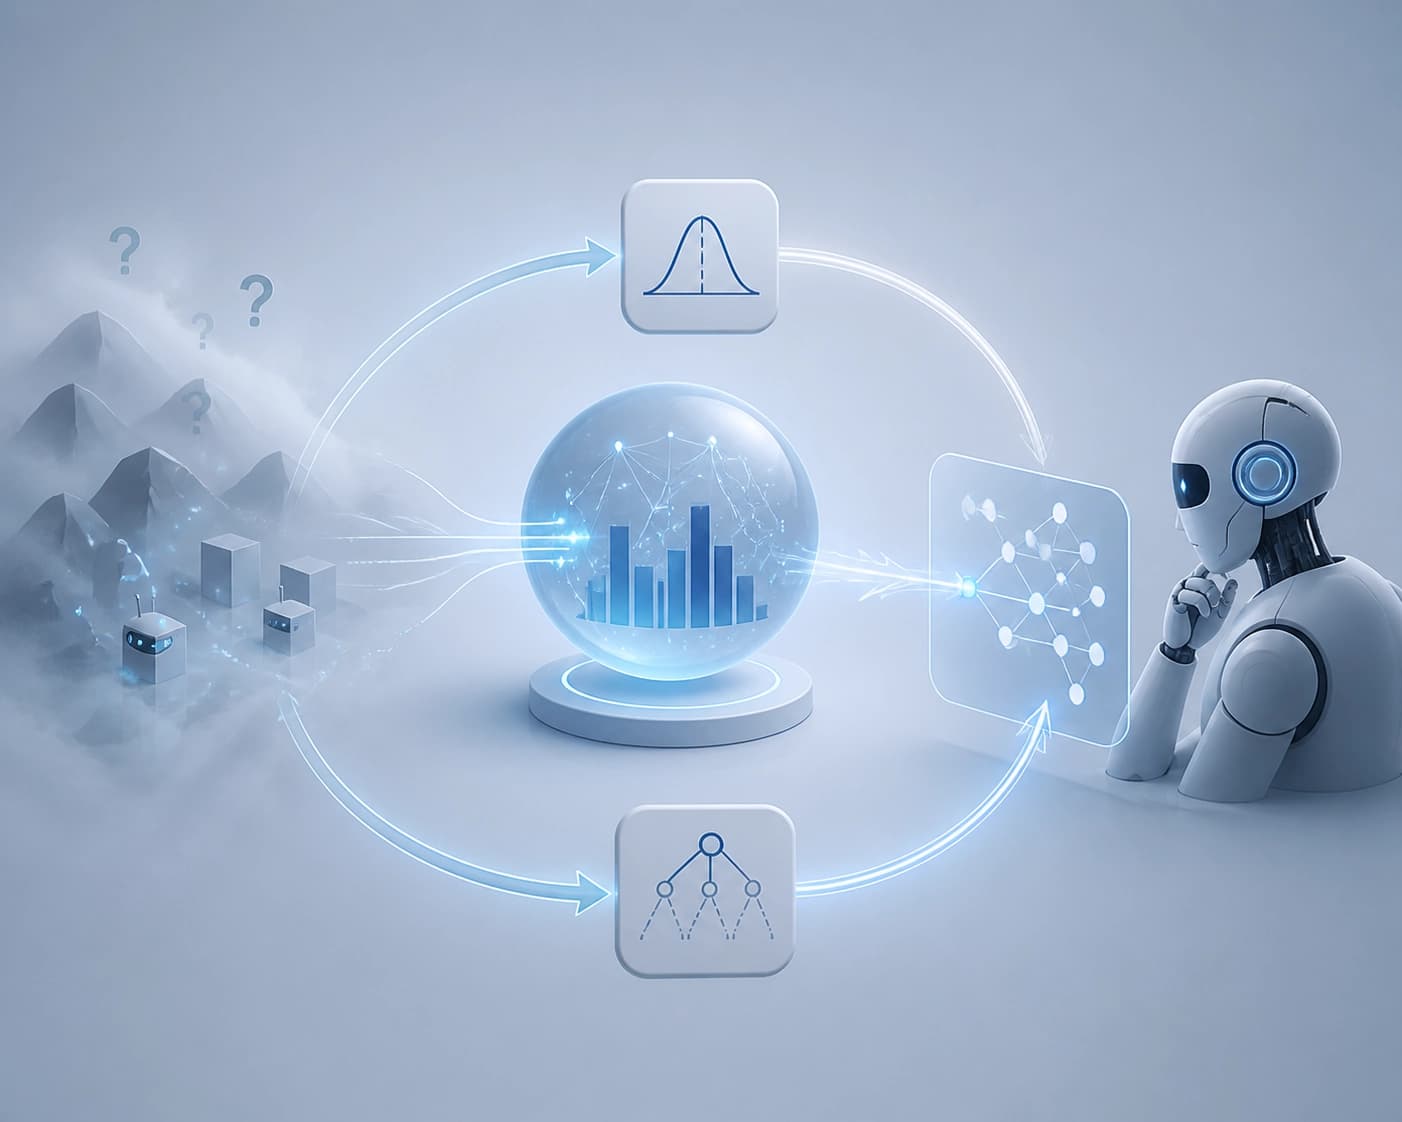
जाँच किसी हस्तक्षेप और उससे उत्पन्न होने वाले अवलोकनों के इर्द-गिर्द बनाई जाती है:
- एक हस्तक्षेप चुनकर उसे नियंत्रित सिम्युलेटर में लागू किया जाता है।
- सिम्युलेटर उससे जुड़े अवलोकन उत्पन्न करता है।
- एजेंट डेटा की पड़ताल करके विफलता का कारण खोजता है।
- छिपा हुआ हस्तक्षेप संदर्भ लेबल का काम करता है और वस्तुनिष्ठ इनाम की गणना संभव बनाता है।
एजेंट को तैयार व्याख्या नहीं दी जाती। उसे शोरयुक्त, मिश्रित और डेटा में बिखरे साक्ष्यों को आपस में जोड़ना होता है। इस तरह सिमुलेशन पहले से तय उत्तर पहचानने के बजाय कारणात्मक निष्कर्ष की जाँच करता है।
नतीजों को कैसे समझें
लेखकों ने 235 एपिसोड वाले एक अलग रखे गए परीक्षण सेट पर मॉडलों का मूल्यांकन किया। सबसे मज़बूत prompting baseline, Claude Opus 5, का FullAttr@1 परिणाम 0.686 रहा।
| मॉडल या चरण | परिणाम |
|---|---|
| supervised fine-tuning के बाद Qwen3.5-35B-A3B | 0.159 → 0.637 |
| सिंथेसाइज़ किए गए इनामों के साथ RL के बाद वही मॉडल | 0.757 |
| prompting baseline में Qwen3.5-122B-A10B | 0.757 के परिणाम से कम |
0.757 का परिणाम, ओपन-सोर्स न होने वाले frontier मॉडलों सहित, मूल्यांकित सभी prompting baselines से बेहतर था। लेखकों के अनुसार, तैयार की गई policy ने 35B वाले बेस मॉडल के prompting संस्करण की तुलना में टूल कॉल का उपयोग भी काफ़ी कम किया।
एजेंटों के प्रशिक्षण के लिए नतीजे क्या बताते हैं
लेखकों का मानना है कि बड़े पैमाने पर उपलब्ध वस्तुनिष्ठ प्रशिक्षण संकेत तक पहुँच, केवल मॉडल के आकार से भी बड़ी बाधा हो सकती है। यह वर्णित कार्य के नतीजों पर आधारित निष्कर्ष है, सभी AI प्रणालियों पर लागू होने वाला सार्वभौमिक नियम नहीं।
सिमुलेशन आधारित जाँच से अस्पष्ट निदानात्मक तर्क वाले कार्य सुदृढीकरण अधिगम के बड़े पैमाने पर प्रशिक्षण के लिए उपयुक्त बन सकते हैं। इसकी प्रमुख शर्त यह है कि एजेंट के निष्कर्ष की तुलना छिपे हुए हस्तक्षेप से की जा सके और वस्तुनिष्ठ इनाम की गणना की जा सके।
यह तरीका कब उपयुक्त है
यदि समस्या को इस तरह परिभाषित किया जा सकता है कि:
- हस्तक्षेप तय करके उसे नियंत्रित वातावरण में लागू किया जा सके;
- उससे जुड़े अवलोकन उत्पन्न किए जा सकें;
- हस्तक्षेप को छिपे हुए संदर्भ लेबल के रूप में रखा जा सके;
- जहाँ लागू हो, मूल कारण और प्रभावित सेगमेंट—दोनों का मूल्यांकन किया जा सके।
यदि कार्य में संदर्भ लेबल से ऐसी तुलना संभव नहीं है, तो वस्तुनिष्ठ इनाम का वर्णित तंत्र उपलब्ध नहीं होगा। तरीका चुनने का व्यावहारिक मानदंड यह है कि क्या विश्लेषण के दौरान उसे बताए बिना, छिपे हुए कारण के आधार पर एजेंट के निष्कर्ष की जाँच की जा सकती है।