
CaLR: डिफ्यूज़न मॉडलों के मज़बूत अनुमान के लिए कारणात्मक बाधाओं के साथ लैटेंट ऑप्टिमाइज़ेशन
यह कार्य CaLR प्रस्तुत करता है—एक ऐसा दृष्टिकोण जिसमें तर्क को अव्यक्त स्थान में बाधाओं के साथ अनुकूलन के रूप में रूपांतरित किया जाता है; संरचना का स्रोत विशेषज्ञ मॉडल से प्राप्त कारणात्मक टोपोलॉजी मैट्रिक्स है, और प्रशिक्षण अंतर्निहित अवकलन पर आधारित है। यह विधि संगति बढ़ाती है और समानांतर जनन के दौरान मध्यवर्ती परिणामों को संशोधित करने की अनुमति देती है, जिससे जटिल डेटासेट और कड़ी बाधाओं वाले कार्यों, जिनमें सुडोकू भी शामिल है, पर बेहतर प्रदर्शन मिलता है।
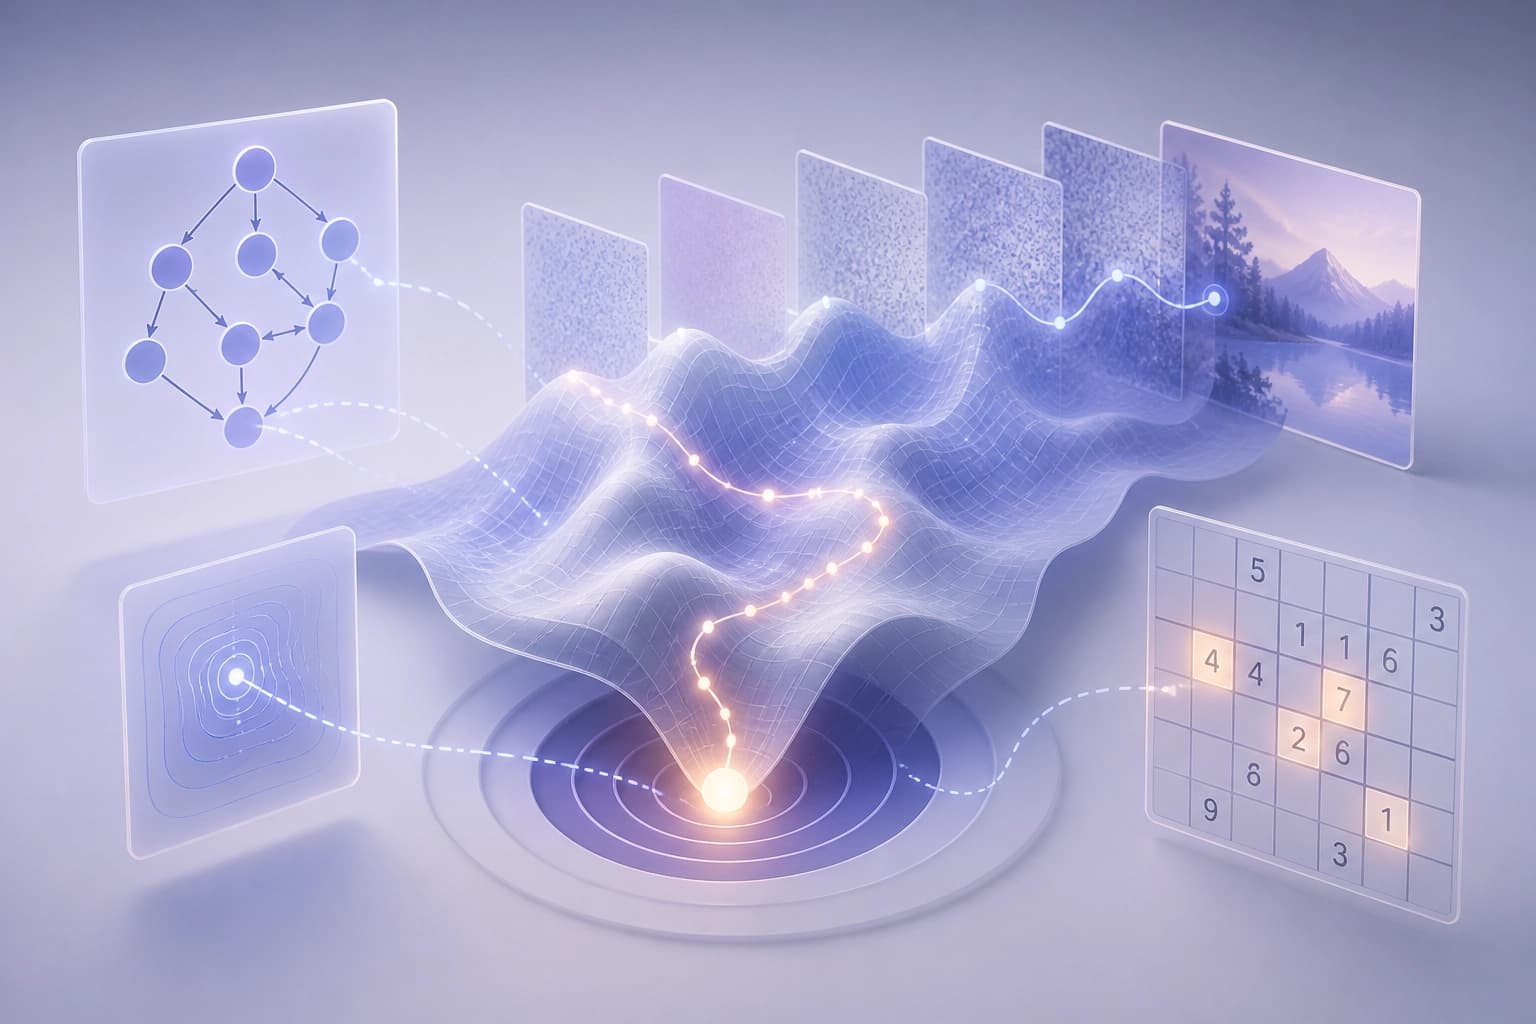
समस्या: AR की स्थानीय लालच-प्रवृत्ति और DLM में कमजोर कारणात्मकता
ऑटोरेग्रेसीव मॉडल स्थानीय लालच-प्रवृत्ति से ग्रस्त होते हैं। डिफ्यूज़न लैंग्वेज मॉडल में अक्सर तर्क के लिए सख्त कारणात्मक संरचना का अभाव होता है।
| मॉडल का प्रकार | सीमा |
|---|---|
| AR | स्थानीय लालच-प्रवृत्ति |
| DLM | तर्क के लिए सख्त कारणात्मक संरचना का अभाव |
निष्कर्ष: तर्क के लिए ऐसे तंत्र की आवश्यकता है, जो जनरेशन को कारणात्मक बाधाओं से जोड़ता हो। व्यावहारिक मानदंड: जाँचें कि मॉडल मध्यवर्ती चरणों में तार्किक संरचना को कैसे बनाए रखता है।
फ्रेमवर्क और उसका उद्देश्य
CaLR, डिफ्यूज़न मॉडल के सुदृढ़ निष्कर्षण के लिए एक फ्रेमवर्क है। यह तर्क को बाधित लैटेंट ऑप्टिमाइज़ेशन के रूप में निरूपित करता है। पूरा नाम: «CaLR: Causal Latent Revision for Robust Diffusion Reasoning»। लेखक: Wei Cai, Jian Zhao, Yuchen Yuan, Xuelong Li। सबमिशन की तारीख: 17 Sep 2026।
निष्कर्ष: CaLR सुदृढ़ निष्कर्षण को लैटेंट निरूपण के ऑप्टिमाइज़ेशन से जोड़ता है। व्यावहारिक मानदंड: यदि कार्य में तर्क के लिए कारणात्मक संरचना आवश्यक हो, तो यह तरीका चुनें।
दृष्टिकोण के घटक
CaLR तीन तत्वों का उपयोग करता है। पहला है कारणात्मक टोपोलॉजी मैट्रिक्स (CTM)। यह मैट्रिक्स expert model से प्राप्त की जाती है। दूसरा है अंतर्निहित अवकलन। तीसरा है ग्रेडिएंट-निर्देशित «विचार संशोधन»।
कारणात्मक टोपोलॉजी मैट्रिक्स (CTM)
CTM एक कारणात्मक टोपोलॉजी मैट्रिक्स है। इसका स्रोत expert model है।
अंतर्निहित अवकलन
CaLR अंतर्निहित अवकलन का उपयोग करता है।
ग्रेडिएंट-निर्देशित «विचार संशोधन»
यह प्रक्रिया तार्किक सुसंगति सुनिश्चित करने के लिए बनाई गई है। इसका उद्देश्य समानांतर जनरेशन के दौरान मध्यवर्ती चरणों का गतिशील रूप से आत्म-सुधार करना भी है।
निष्कर्ष: CTM कारणात्मक संरचना प्रदान करता है, अंतर्निहित अवकलन ऑप्टिमाइज़ेशन का हिस्सा है, और विचार संशोधन चरणों को सुधारता है। व्यावहारिक मानदंड: कारणात्मक संरचना के स्रोत और सुधार तंत्र की मौजूदगी जाँचें।
दावा किए गए परिणाम
CaLR जटिल बेंचमार्क पर DLM का SOTA प्रदर्शन हासिल करता है। यह फ्रेमवर्क मज़बूत AR बेसलाइन से बेहतर प्रदर्शन करता है। यह Sudoku जैसे बाधित कार्यों में बेहतर सुदृढ़ता दिखाता है।
| गुण | परिणाम |
|---|---|
| DLM का प्रदर्शन | जटिल बेंचमार्क पर SOTA |
| AR से तुलना | मज़बूत AR बेसलाइन से बेहतर |
| सुदृढ़ता | Sudoku जैसे बाधित कार्यों में बेहतर सुदृढ़ता |
निष्कर्ष: बताए गए लाभ जटिल बेंचमार्क और बाधित कार्यों से संबंधित हैं। व्यावहारिक मानदंड: कार्य की आवश्यकताओं की तुलना बाधित कार्यों में सुदृढ़ता से करें। अन्य परिदृश्यों के बारे में डेटा के सारांश में कोई जानकारी नहीं है।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री
RL सिम्युलेटरों की विफलताओं के निदान में कैनोनिकल बहुपद अपरिवर्तांक: वे वास्तव में कहाँ उपयोगी हैं
यह अध्ययन जाँचता है कि क्या सीखने योग्य गतिशीलता मॉडल में भौतिक नियमों को शामिल करना उचित है: प्रक्षेप पथों से निकाले गए और ग्रोबनर आधारों के माध्यम से विहित रूप में लाए गए अपरिवर्तक पूर्वानुमानों में मामूली सुधार देते हैं, लेकिन निदान में प्रभावी साबित होते हैं—वे उल्लंघित बाधा का स्थान निर्धारित करने और विशिष्ट गलत पैरामीटर की पहचान करने में सक्षम बनाते हैं।
10 नवम्बर 2026
AURA-Eval: कैसे जाँचें कि LLM एजेंट ने जोखिम को पहचाना और अगला कदम बदल दियाેણ
यह फ्रेमवर्क LLM एजेंटों के व्यवहार का आकलन अंतिम निर्णय के आधार पर नहीं, बल्कि अहम बिंदुओं पर जोखिम के प्रति उनकी प्रतिक्रिया के आधार पर करता है: टूल-कॉल की ट्रैजेक्टरी बीच में रोक दी जाती हैं, जिसके बाद मॉडल को अपना तर्क और कार्रवाई जारी रखनी होती है, जबकि LLM जजों का एक पैनल जोखिम की पहचान, कदम की प्रकृति और उसकी सुरक्षा का विश्लेषण करता है। R-Judge की 157 ट्रैजेक्टरी से संकलित 1249 कार्यों में, 20 मॉडलों में सुरक्षित रास्ता न होने पर असुरक्षित कार्रवाइयाँ बढ़ जाती हैं, और निष्पादन से पहले निगरानी हटाने पर शुरुआत में सुरक्षित रहे 52,3% मामले असुरक्षित हो जाते हैं।
10 नवम्बर 2026
चेर्न–साइमन रिज़र्वॉयर की स्मृति: संयोजकता की स्वायत्त गतिशीलता और घनत्व का परिवहन
यह लेख बताता है कि रिज़र्वॉयर इनपुट संकेतों का इतिहास घनत्व वितरण और ज्यामितीय स्वतंत्रता की डिग्रियों—दोनों में कैसे बनाए रखता है। चार तंत्रों की तुलना से पता चलता है कि धारा एक अलग संयोजकता घटक बनाती है, जो घनत्व की बाद की प्रतिक्रिया को बदलती है, जबकि सभी मापे गए लक्षणों को शामिल करने से पल्स के क्रम को डिकोड करने में थोड़ा सुधार होता है।
10 नवम्बर 2026