
शल्य चिकित्सक के मोतियाबिंद ऑपरेशन वीडियो पर AI अपनी विशेषज्ञता रेटिंग समझाता है
शोधकर्ताओं ने एक ऐसा प्लेटफ़ॉर्म बनाया है जो सर्जरी के वीडियो रिकॉर्डिंग के आधार पर सर्जनों के कौशल का स्वचालित मूल्यांकन करता है। 83 वीडियो पर परीक्षण की गई यह प्रणाली विशेषज्ञों के साथ 87% तक सहमति दिखाती है और निष्कर्षों को पारदर्शी बनाती है।
सर्जिकल कौशल के व्यक्तिपरक मूल्यांकन की समस्या
नेत्र शल्य चिकित्सकों का प्रशिक्षण अनुभवी सलाहकारों से प्रतिक्रिया के बिना अकल्पनीय है। हालाँकि, ऑपरेशन के वीडियो द्वारा दक्षता का पारंपरिक मूल्यांकन काफी हद तक व्यक्तिपरक बना हुआ है: दो विशेषज्ञ उपकरण की समान गतिविधियों की अलग-अलग व्याख्या कर सकते हैं। यह विशेषज्ञों के प्रशिक्षण को धीमा करता है और प्रमाणन में त्रुटियों का जोखिम पैदा करता है।
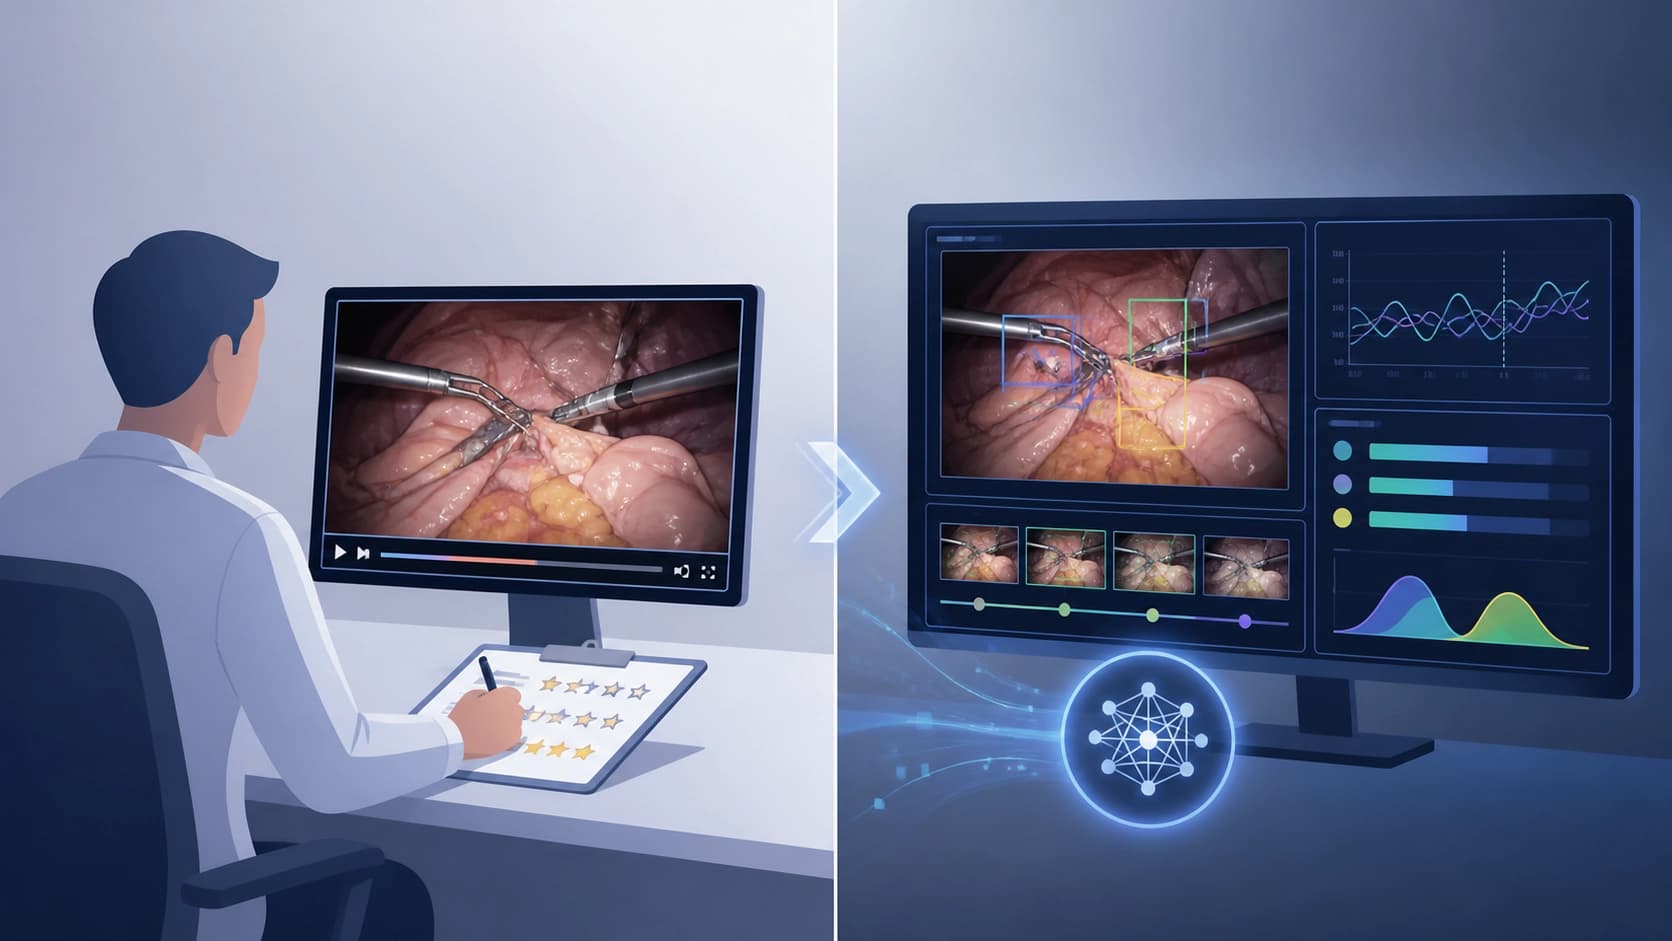
स्वचालित प्रणालियाँ जिन्होंने पहले इस समस्या को हल करने का प्रयास किया था, अक्सर "ब्लैक बॉक्स" की तरह काम करती थीं: वे अंतिम स्कोर देती थीं, लेकिन यह नहीं बताती थीं कि यह किन गतिविधियों के आधार पर दिया गया है। प्रशिक्षण के लिए ऐसा उत्तर बेकार है — युवा सर्जन समझ नहीं पाता कि उसे वास्तव में क्या सुधारने की आवश्यकता है।
ऑपरेशन वीडियो विश्लेषण के लिए व्याख्यात्मक AI प्लेटफ़ॉर्म
शोधकर्ताओं के एक समूह ने एक नया प्लेटफ़ॉर्म प्रस्तुत किया जो कंप्यूटर विज़न और सिग्नल प्रोसेसिंग को जोड़ता है। इसका कार्य केवल दक्षता का स्तर निर्धारित करना नहीं है, बल्कि यह दिखाना है कि हाथों की कौन सी गतिविधियाँ, गति और उपकरण का प्रक्षेपवक्र मूल्यांकन को प्रभावित करते हैं। पिछले "अपारदर्शी" समाधानों के विपरीत, यहाँ प्रत्येक निष्कर्ष को एक विशिष्ट मीट्रिक तक खोजा जा सकता है।
सिस्टम आज तक के सबसे बड़े डेटासेट पर आधारित है: मोतियाबिंद हटाने के ऑपरेशनों की 2000 रिकॉर्डिंग। यह एल्गोरिदम को सीमित नमूने पर नहीं, बल्कि विविध तकनीकों और कार्य शैलियों पर सीखने की अनुमति देता है।
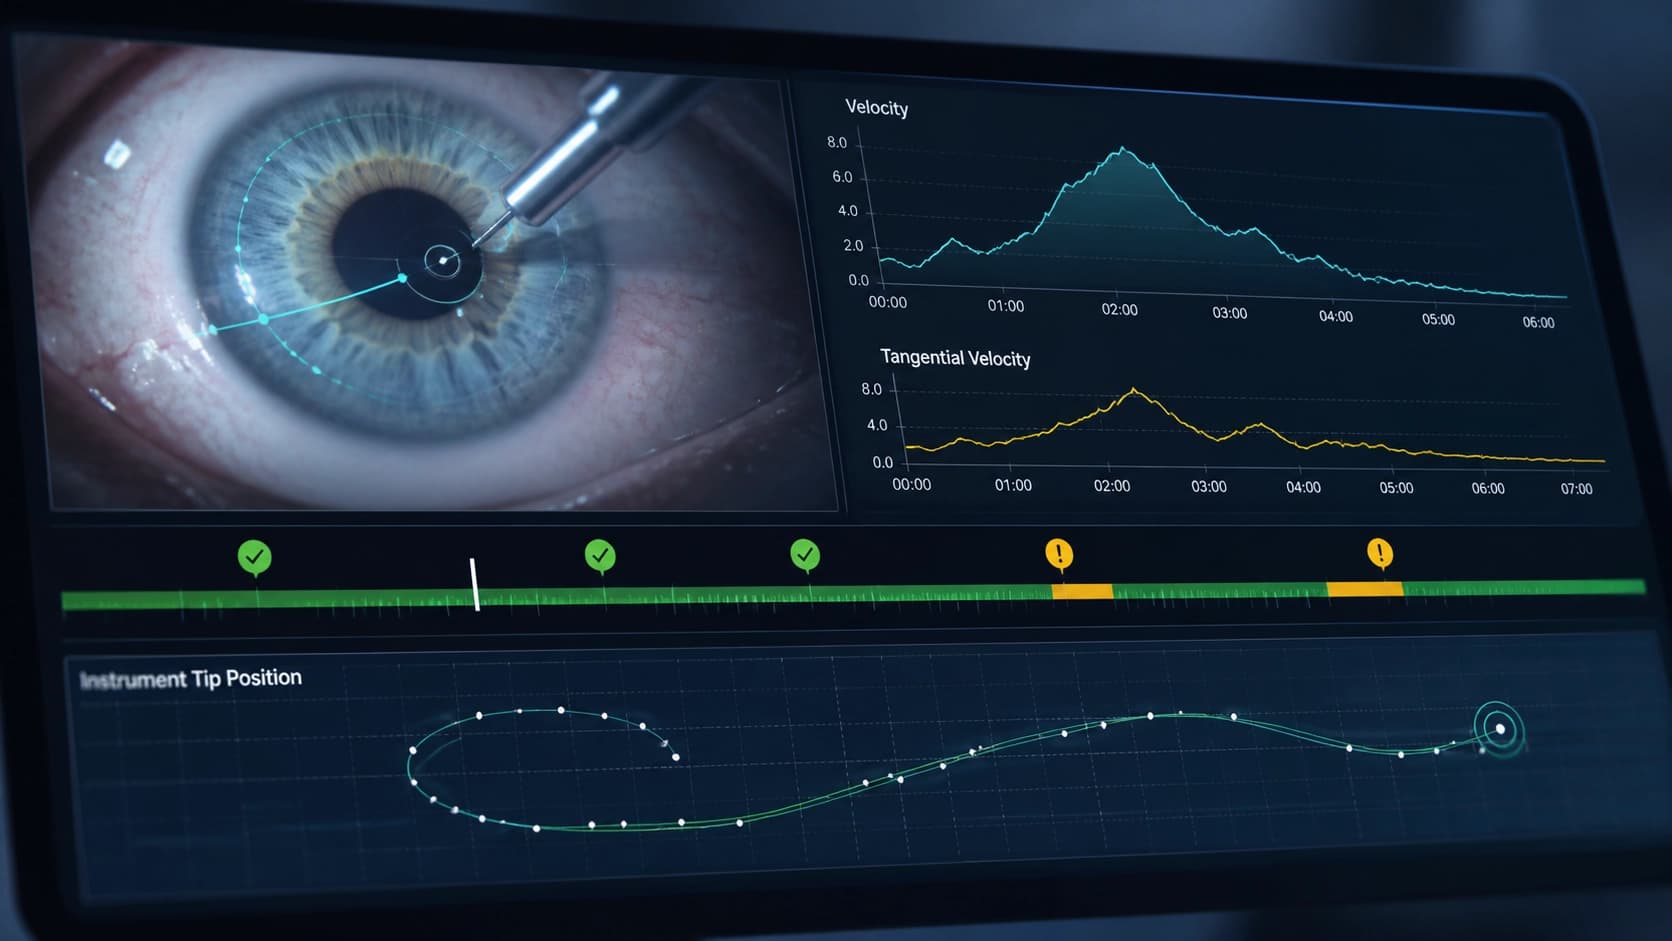
मुख्य विशेषता — व्याख्यात्मकता है। प्लेटफ़ॉर्म वीडियो से गति की दस वस्तुनिष्ठ मीट्रिक निकालता है, जैसे उपकरण की गति की सहजता, गति, प्रक्षेपवक्र की सटीकता। ये मीट्रिक विशेषज्ञों के मूल्यांकन से मिलाए जाते हैं, लेकिन मनुष्य के विपरीत, मशीन ऑपरेशन के उन विशिष्ट हिस्सों को इंगित कर सकती है जहाँ गतिविधियाँ अनिश्चित या अनुकूलतम नहीं थीं।
सिस्टम की सटीकता कैसे जाँची गई
प्रयोगात्मक अध्ययन में ऑपरेशनों की 83 वीडियो रिकॉर्डिंग का उपयोग किया गया। विशेषज्ञ सर्जनों ने प्रत्येक का मूल्यांकन नए CSAS (Capsulorhexis Skill Assessment System) पैमाने पर किया, जो मुख्य चरण — कैप्सुलोरेक्सिस पर केंद्रित है। फिर इन व्यक्तिपरक मूल्यांकनों की तुलना दस स्वचालित रूप से गणना की गई मीट्रिक से की गई।
परिणाम ने मानवीय राय और एल्गोरिदम की गणना के बीच उच्च सहमति दिखाई। दक्षता स्तर की भविष्यवाणी की सटीकता 87% तक पहुँच गई। और महत्वपूर्ण बात यह है कि सहसंबंध केवल अंतिम स्कोर से नहीं, बल्कि प्रत्येक मीट्रिक के लिए अलग-अलग देखा गया। यह पुष्टि करता है: सिस्टम केवल "अनुमान" नहीं लगाती, बल्कि वास्तव में गतिविधियों के महत्वपूर्ण पैटर्न को पहचानती है।
व्यवहार में इसका क्या अर्थ है
व्याख्यात्मक AI रेजीडेंसी और सतत चिकित्सा शिक्षा में एक उपयोगी उपकरण बन सकता है। युवा सर्जन को केवल "औसत से ऊपर" का मूल्यांकन नहीं मिलता, बल्कि उन विशिष्ट गतिविधियों का विश्लेषण मिलता है जिन्हें सुधारने की आवश्यकता है। प्रमाणन समिति को व्यक्तिपरक अनुभवों के अतिरिक्त वस्तुनिष्ठ मात्रात्मक डेटा मिलता है।
डेवलपर्स जोर देते हैं कि उनका प्लेटफ़ॉर्म विशेषज्ञों की जगह नहीं लेता, बल्कि उन्हें मजबूत समर्थन देता है। संभावित रूप से यह दुनिया भर में मूल्यांकन मानकों को एकीकृत करने में सक्षम है, जिससे सर्जनों का प्रशिक्षण अधिक पारदर्शी और पुनरुत्पादनीय बन जाता है। अगला कदम — बड़े नमूनों और मोतियाबिंद ऑपरेशन के अन्य चरणों पर सत्यापन का विस्तार करना है।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री
RL सिम्युलेटरों की विफलताओं के निदान में कैनोनिकल बहुपद अपरिवर्तांक: वे वास्तव में कहाँ उपयोगी हैं
यह अध्ययन जाँचता है कि क्या सीखने योग्य गतिशीलता मॉडल में भौतिक नियमों को शामिल करना उचित है: प्रक्षेप पथों से निकाले गए और ग्रोबनर आधारों के माध्यम से विहित रूप में लाए गए अपरिवर्तक पूर्वानुमानों में मामूली सुधार देते हैं, लेकिन निदान में प्रभावी साबित होते हैं—वे उल्लंघित बाधा का स्थान निर्धारित करने और विशिष्ट गलत पैरामीटर की पहचान करने में सक्षम बनाते हैं।
10 नवम्बर 2026
AURA-Eval: कैसे जाँचें कि LLM एजेंट ने जोखिम को पहचाना और अगला कदम बदल दियाેણ
यह फ्रेमवर्क LLM एजेंटों के व्यवहार का आकलन अंतिम निर्णय के आधार पर नहीं, बल्कि अहम बिंदुओं पर जोखिम के प्रति उनकी प्रतिक्रिया के आधार पर करता है: टूल-कॉल की ट्रैजेक्टरी बीच में रोक दी जाती हैं, जिसके बाद मॉडल को अपना तर्क और कार्रवाई जारी रखनी होती है, जबकि LLM जजों का एक पैनल जोखिम की पहचान, कदम की प्रकृति और उसकी सुरक्षा का विश्लेषण करता है। R-Judge की 157 ट्रैजेक्टरी से संकलित 1249 कार्यों में, 20 मॉडलों में सुरक्षित रास्ता न होने पर असुरक्षित कार्रवाइयाँ बढ़ जाती हैं, और निष्पादन से पहले निगरानी हटाने पर शुरुआत में सुरक्षित रहे 52,3% मामले असुरक्षित हो जाते हैं।
10 नवम्बर 2026
चेर्न–साइमन रिज़र्वॉयर की स्मृति: संयोजकता की स्वायत्त गतिशीलता और घनत्व का परिवहन
यह लेख बताता है कि रिज़र्वॉयर इनपुट संकेतों का इतिहास घनत्व वितरण और ज्यामितीय स्वतंत्रता की डिग्रियों—दोनों में कैसे बनाए रखता है। चार तंत्रों की तुलना से पता चलता है कि धारा एक अलग संयोजकता घटक बनाती है, जो घनत्व की बाद की प्रतिक्रिया को बदलती है, जबकि सभी मापे गए लक्षणों को शामिल करने से पल्स के क्रम को डिकोड करने में थोड़ा सुधार होता है।
10 नवम्बर 2026