
Qwen2-VL-72B-Instruct
मल्टीमॉडल न्यूरल नेटवर्क Alibaba से 73.4 अरब पैरामीटर्स के साथ, छवियों और वीडियो को समझने के लिए।
अवलोकन
तंत्रिका नेटवर्क Qwen2-VL-72B-Instruct का विवरण
Qwen2-VL-72B-Instruct एक multimodal भाषा मॉडल डिजाइन टीम अलीबाबा है। तंत्रिका नेटवर्क को दृश्य जानकारी के जटिल विश्लेषण के लिए डिज़ाइन किया गया है: वह प्रवेश को स्थिर छवियों और वीडियो अनुक्रमों के रूप में स्वीकार करती है। मॉडल आर्किटेक्चर में 73.4 बिलियन पैरामीटर हैं जो इसे जटिल दृश्यों को संसाधित करने की अनुमति देता है।
##Technological Foundation
मॉडल गतिशील रिज़ॉल्यूशन तंत्र पर आधारित है जो प्रसंस्करण को एक विशिष्ट फ़ाइल आकार में अनुकूल बनाता है। यह छोटी वस्तुओं की सटीकता को बेहतर बनाता है। इसके अतिरिक्त M-ROPE के बेहतर पोजीशनल प्रतीकों का उपयोग किया जाता है जो मॉडल को वीडियो अनुक्रम के विश्लेषण में अंतरिक्ष और समय में सही ढंग से नेविगेट करने में मदद करता है।
रिलीज की तारीख और स्थिति
यह मॉडल अगस्त 2024 के अंत में घोषित किया गया था। यह तैनात है। मीडिया फ़ाइलों की सामग्री को समझने पर इंस्ट्रूमेंटल समाधान से संबंधित कार्य: तर्क और बातचीत के तत्वों के साथ वीडियो सामग्री का विश्लेषण करने से पहले ऑटोडेस्क्रिप्शन से।
Qwen2-VL-72B-Instruct
| लक्षण | मूल्य |
|---|---|
| डेवलपर | अलीबाबा |
| प्रकार | मल्टीमॉडल मॉडल |
| पैरामीटर | 73.4 बिलियन (73.4B) |
| रिलीज़ की तारीख | अगस्त 29, 2024 |
| औसत स्कोर | 75.8% |
| लाइसेंस | Tongyi \ qianwen |
| ज्ञान सीमा | 30 जून 2023 |
| इनपुट डेटा | चित्र, वीडियो |
किसके लिए Qwen2-VL-72B-Instruct तंत्रिका नेटवर्क उपयुक्त है?
उपकरण का उद्देश्य उपयोगकर्ताओं की एक विस्तृत श्रृंखला पर है जिसके द्वारा स्वचालित दृश्य सामग्री की आवश्यकता होती है।
डेवलपर्स और शोधकर्ताओं
मशीन लर्निंग विशेषज्ञों का उपयोग अनुप्रयोग कंप्यूटर-विज़न बनाने के आधार के रूप में किया जा सकता है: वीडियो एनालिटिक्स सिस्टम छवि खोज, मॉडरेशन सामग्री। ओपन आर्किटेक्चर और तकनीकी दस्तावेज इसे अनुमति देते हैं मौजूदा पाइपलाइनों में एकीकृत होना।
व्यापार उपयोगकर्ता और सामग्री प्रबंधक
कंपनियों के लिए बड़े पैमाने पर काम करना मॉडल सूचीकरण समस्याओं को हल करने में उपयोगी है विवरण के स्वचालित निर्माण दस्तावेजों या संकेतों की तस्वीरों से निष्कर्षण पाठ जानकारी। वीडियो विश्लेषण निगरानी कैमरे या वेबिनार से रिकॉर्डिंग को संसाधित करने में मदद करता है।
Qwen2-VL-72B-Instruct तंत्रिका नेटवर्क का उपयोग कैसे करें?
उपयोग के लिए दृष्टिकोण यह उपयोगकर्ता और अंतिम लक्ष्य के तकनीकी प्रशिक्षण पर निर्भर करता है।
पहुँच के तरीके
मॉडल फैल रहा है। एक खुला स्रोत सॉफ्टवेयर उत्पाद के रूप में। कार्य को डाउनलोड मॉडल भार की आवश्यकता होगी और उन्हें पर्याप्त कंप्यूटिंग शक्ति (GPU के साथ बड़ी मात्रा में वीडियो मेमोरी) के साथ सर्वर पर स्थानीय रूप से चलाएं। वैकल्पिक विकल्प - तीसरे पक्ष के एपीआई प्लेटफार्मों के माध्यम से उपयोग करें जो सदस्यता द्वारा मॉडल तक पहुंच प्रदान करते हैं।
##Basic स्क्रिप्ट
उपयोगकर्ता एक छवि या वीडियो फ़ाइल अपलोड करता है, एक पाठ अनुरोध सेट करता है और मॉडल जवाब देता है। गुणवत्ता प्राप्त करने के लिए प्रश्नों को स्पष्ट रूप से तैयार करना महत्वपूर्ण है। उदाहरण के लिए, "इस तस्वीर में सभी वस्तुओं को छोड़ दें" या "चित्र पर पाठ को पहचानें और इसे अंग्रेज़ी में अनुवाद करें? मॉडल चरण-दर-चरण तर्क का समर्थन करता है जो आपको चरणों में जटिल दृश्यों का विश्लेषण करने की अनुमति देता है।
बुनियादी Qwen2-VL-72B-Instruct
मॉडल दृश्य प्रसंस्करण डेटा के प्रमुख परिदृश्यों को कवर करने वाले कार्यों का एक सेट प्रदान करता है।
छवि प्रसंस्करण वीडियो
तंत्रिका नेटवर्क पूर्व कोडिंग की आवश्यकता के बिना दोनों प्रकार की फाइलों को स्वीकार करता है। । डायनेमिक रेज़ोल्यूशन आपको छोटे चित्र के रूप में अच्छी तरह से काम करने की अनुमति देता है और यह बहुत सारे वीडियो हैं।
चरण तर्क और दृश्य विश्लेषण द्वारा कदम
एक साधारण विवरण के बजाय, मॉडल घटनाओं वीडियो के कारणों के बारे में तर्क उत्तर प्रश्नों का निर्माण कर सकता है।
बहुभाषी पाठ मान्यता
अंतर्निहित OCR मॉड्यूल विभिन्न भाषाओं पर चित्र से पाठ निकालता है। यह दस्तावेज़ प्रसंस्करण के लिए उपयोगी है। स्क्रीनशॉट उपशीर्षक या संकेत के साथ तस्वीरें।
एजेंट इंटरेक्शन
मॉडल एक एजेंट के रूप में कार्य कर सकता है। वीडियो संदर्भ में निर्देश करना। उदाहरण के लिए, यह फ्रेम में वस्तुओं में परिवर्तन को ट्रैक करने या प्रश्नों का जवाब देने में सक्षम है, जिसके लिए अस्थायी गतिशीलता के विचार की आवश्यकता होती है।
Qwen2-VL-72B-Instruct के लाभ
मॉडल की प्रमुख ताकत इसे पिछली पीढ़ी के उपकरणों से अलग करती है।
उच्च सटीकता और पैमाने
73.4 बिलियन मापदंडों के साथ, मॉडल गहरी समझ प्रदर्शित करता है। दृश्य संदर्भ वह मुकाबला करती है। कार्य पर, जिसे वस्तुओं के बीच कई विवरणों और संबंधों पर विचार करने की आवश्यकता होती है।
##विश्वविद्यालय और बहुभाषी
एक मॉडल में विभिन्न भाषाओं पर छवि विश्लेषण वीडियो और पाठ मान्यता का संयोजन जटिल उत्पाद के विकास को सरल बनाता है। कई विशिष्ट सेवाओं को जोड़ने की कोई आवश्यकता नहीं है।
उपयोग में लचीलापन
गतिशील संकल्प और बेहतर पोजीशनल एम्बेडिंग मॉडल को गुणवत्ता के नुकसान के बिना मनमाने इनपुट आकार को अनुकूलित करने की अनुमति देता है। यह महत्वपूर्ण है जब गैर मानक फ़ाइल स्वरूपों के साथ काम करना।
Qwen2-VL-72B-Instruct के नुकसान
फायदे के बावजूद एक मॉडल का चयन करते समय, खाता निश्चित सीमाओं को ध्यान में रखते हैं।
उच्च मांग उपकरण
73 बिलियन मॉडल को लॉन्च करने के लिए कई शक्तिशाली ग्राफिक्स प्रोसेसर की आवश्यकता होती है। यह छोटी टीमों और व्यक्तिगत डेवलपर्स के लिए स्थानीय उपयोग को महंगा बना देता है।
###Restricted frontier
मॉडल 30 जून 2023 तक प्रासंगिक डेटा पर प्रशिक्षित। इसका मतलब है कि उस तारीख के बाद कौन सी घटना हुई थी। सामग्री का विश्लेषण करते समय उन्हें गलत व्याख्या या मान्यता नहीं दी जा सकती है।
Qwen2-VL-72B-Instruct
मॉडल का दायरा दृश्य सामग्री से संबंधित कार्यों की एक विस्तृत श्रृंखला को कवर करता है।
##पाठ और दस्तावेजों की पहचान
मॉडल प्रभावी रूप से फोटो, स्कैन और स्क्रीनशॉट से पाठ को निकालता है और पहचानता है। यह टास्क डिजिटाइज़ेशन ऑटोमैटिक मॉडरेशन ऑफ कंटेंट एंड प्रोसेसिंग ऑफ प्रश्नावली में मांग में है।
वीडियो सामग्री विश्लेषण
वीडियो प्रोसेसिंग की संभावना कार्यों की गुणवत्ता नियंत्रण को हल करने की अनुमति देती है।
परिसर। दृश्य तर्क
यह मॉडल उन सवालों का जवाब देने में सक्षम है जो विश्लेषण की मांग करते हैं, वे बातचीत करते हैं और समय-समय पर बदलते हैं। इसका उपयोग किया जाता है। सुरक्षा प्रणालियों और विश्लेषणात्मक सेवाओं की सहायता करना।
Qwen2-VL-72B-Instruct कीमतों
खुले स्प्रिंग्स में डेवलपर से मॉडल की लागत के बारे में आधिकारिक जानकारी यह प्रकाशित नहीं किया गया था। मॉडल फैल रहा है। लाइसेंस tongyi \ qianwen जो वजन डाउनलोड करने के लिए खुली पहुंच प्रदान करता है। हालांकि, उपयोगकर्ता को स्वतंत्र रूप से कंप्यूटिंग संसाधन की लागत को एक GPU सर्वर किराए पर लेना या अपने खुद के हार्डवेयर खरीदने के लिए कवर करना होगा। अंतिम लागत चयनित क्लाउड प्रदाता और मॉडल की अवधि पर निर्भर करती है।
Qwen2-VL-72B-Instruct
मॉडल फैल रहा है। अलीबाबा द्वारा विकसित लाइसेंस tongyi qianwen के तहत। यह लाइसेंस प्रतिबंध मॉडलिंग वाणिज्यिक उद्देश्यों को भी संशोधन और वितरण व्युत्पन्न उत्पाद को विनियमित करता है। उपयोग करने से पहले लाइसेंस समझौते का पूरा पाठ देखें ताकि कॉपीराइट धारक की अपनी परिदृश्य आवश्यकताओं के अनुसार सत्यापित हो सके।
Qwen2-VL-72B-Instruct
वर्तमान में मॉडल डाउनलोड के लिए उपलब्ध है। आधिकारिक अलीबाबा चैनलों और मॉडल भंडार के माध्यम से। विशिष्ट क्षेत्रों में जानकारी जिसमें संदर्भ सामग्री में सीमित उपलब्धता नहीं दी गई है। पंजीकरण की संभावना वजन डेवलपर प्लेटफॉर्म और लाइसेंस शर्तों की स्वीकृति तक पहुंच की आवश्यकता है। इसके अलावा, मॉडल को तृतीय-पक्ष सेवाओं में एकीकृत किया जा सकता है। इसके लिए एपीआई एक्सेस प्रदान करना।
Qwen2-VL-72B-Instruct को एनालॉग्स से अलग करना
बाजार पर कई मल्टीमॉडल उत्पाद हैं। Qwen2-VL-72B-Instruct के साथ तुलना में मॉडल। Qwen3 VL 32B सोच के निकटतम एनालॉग में, Qwen2.5 VL 72B निर्देश, Qwen2.5 VL 32B निर्देश, और QvQ-72B समीक्षा और Qwen2.5 VL 7B निर्देश.
पिछले संस्करणों के साथ तुलना
Qwen2.5 से मुख्य अंतर वास्तुशिल्प सुधार स्थिति embedding और गतिशील परमिट है। Qwen2-VL-72B-Instruct एक मॉडल है। पहली पंक्ति हालांकि, पहले मॉडल मुख्य रूप से छवियों पर केंद्रित थे।
कम पैरामीटर वाले मॉडल से अंतर
तुलना में। कॉम्पैक्ट Qwen2.5 VL 7B निर्देश पर 73-billion-dollar संस्करण जटिल दृश्य कार्यों पर उच्च सटीकता दिखाता है और छोटे विवरणों की मान्यता पर बेहतर सामना करता है। हालांकि, यह हार्डवेयर संसाधनों की ओर बहुत बड़ी आवश्यकताओं की लागत पर हासिल किया जाता है।
अन्य मॉडल डेवलपर से अंतर
कई के विपरीत। बंद व्यावसायिक निर्णय Qwen2-VL-72B-Instruct खुले वजन के साथ उपलब्ध है जो आपको इसे अनुकूलित करने की अनुमति देता है। एपीआई प्रदाता के संदर्भ में परियोजना की विशिष्ट आवश्यकताओं के लिए। कार्यक्षमता में निकटतम प्रतियोगी Qwen3.6 प्लस है। हालांकि, एक विस्तृत प्रदर्शन तुलना में अलग परीक्षण की आवश्यकता होती है। लक्षित कार्य
निष्कर्ष
Qwen2-VL-72B-Instruct अलीबाबा से एक शक्तिशाली बहुमॉडल मॉडल है। जो छवि और वीडियो विश्लेषण से संबंधित कार्यों की एक विस्तृत श्रृंखला को कवर करता है। 73.4 बिलियन पैरामीटर गतिशील रिज़ॉल्यूशन और बेहतर पोजीशनल एम्बेडिंग के साथ, यह चरण-दर-चरण तर्क करने में सक्षम है। विभिन्न भाषाओं में पाठ को पहचानें और वीडियो सामग्री पर बातचीत करें। मॉडल डेवलपर्स और कंपनियों के लिए उपयुक्त है जो इसे चलाने के लिए आवश्यक कंप्यूटिंग संसाधनों को प्रदान करने के लिए तैयार हैं। मुख्य सीमाएं उच्च स्तर के उपकरण और ज्ञान के फ्रंटियर सीमित मध्य-2023 हैं। आम तौर पर सही Qwen लाइन से इस मॉडल और वर्तमान एनालॉग्स के बीच विकल्प विशिष्ट कार्यों और उपलब्ध क्षमता पर निर्भर करता है।
अक्सर पूछे जाने वाले प्रश्न
यह भी देखें
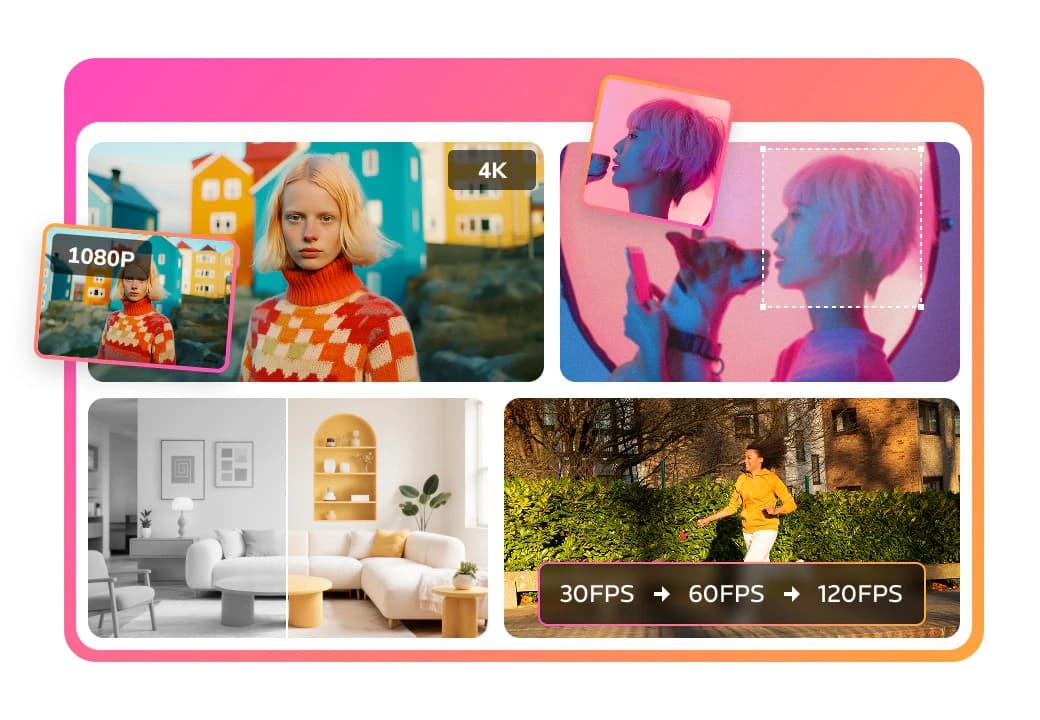
मल्टीमीडिया AI टूल्स का सेट, जो फोटो, वीडियो और PDF दस्तावेज़ों को संपादित और बेहतर बनाने के लिए है।

क्रोम एक्सटेंशन जो AI सहायक की मदद से टैब, इतिहास और बुकमार्क प्रबंधित करने में मदद करता है।

मंगा और मन्हवा के पन्नों पर पाठ को पहचानने, उसका विभिन्न भाषाओं में अनुवाद करने और मूल चित्र को नुकसान पहुँचाए बिना उसे वापस छवि में जोड़ने वाली ऑनलाइन सेवा।

एआई-आधारित वीडियो निर्माण और संपादन टूलकिट, जिसमें अवतार, लिप-सिंक और आवाज़ क्लोनिंग शामिल हैं।

ग्राहक सहायता और लीड जनरेशन को स्वचालित करने के लिए मल्टी-एजेंट एआई सिस्टम और चैटबॉट बनाने का मंच।.

परियोजना प्रबंधन मंच जिसमें कार्य निर्धारण, समय ट्रैकिंग और कर्मचारी कार्यभार नियंत्रण की सुविधाएँ शामिल हैं।

TypeScript के लिए एक लाइब्रेरी जो GPT-4 को टिप्पणियों द्वारा वर्णित फ़ंक्शन के लिए रनटाइम के रूप में उपयोग करने की अनुमति देती है।
साइड AI पैनल जो सवालों के जवाब देने, दस्तावेज़ों के साथ काम करने और छवियाँ बनाने में मदद करता है।