
Qwen2-VL-72B-Instruct
Multimodal Alibaba réseau neuronal avec 73,4 milliards de paramètres perception images et vidéos.
Aperçu général
Description du réseau neuronal Qwen2-VL-72B-Instruct
Qwen2-VL-72B-Instruct est un modèle de langue multimodal conçu par l'équipe Alibaba. Le réseau neuronal est conçu pour une analyse complexe de l'information visuelle : elle accepte Entrée comme images statiques et séquences vidéo . L'architecture du modèle a 73,4 milliards de paramètres qui lui permettent d'être traité décor complexe Extraire des détails et construire des chaînes logiques en fonction de ce que vous voyez.
Fondation technologique
Le modèle est basé sur le mécanisme de résolution dynamique qui Adapte le traitement à une taille de fichier spécifique. Cela améliore la précision des petits objets. En outre utilisé des emblèmes de position améliorée de M-ROPE qui aident le modèle à naviguer correctement dans l'espace et le temps dans l'analyse de la séquence vidéo.
Date de sortie et positionnement
Le modèle a été annoncé fin août 2024 . Il est positionné. des tâches liées à la solution instrumentale sur la compréhension du contenu des fichiers multimédias : de l'autodescription avant d'analyser le contenu vidéo avec des éléments de raisonnement et d'interaction.
Qwen2-VL-72B-Instruction
| Caractéristiques | Valeur |
|---|---|
| Développeur | Alibaba |
| Type | Modèle multimodal |
| Paramètres | 73,4 milliards (73,4 milliards) |
| Date de sortie | 29 août 2024 |
| Score moyen | 75,8% |
| Licence | tangyi / qianwen |
| Limite des connaissances | 30 juin 2023 |
| Données d'entrée | Images , vidéo |
Pour qui le réseau neuronal Qwen2-VL-72B-Instruct convient-il?
L'outil s'adresse à un large éventail d'utilisateurs qui ont besoin d'un contenu automatisé de visualisation.
Développeurs et chercheurs
Les spécialistes de l'apprentissage automatique peuvent utiliser le modèle comme base pour la création d'applications vision informatique : systèmes d'analyse vidéo Recherche d'image, contenu de modération . Architecture ouverte et documentation technique le permettent à intégrer dans les pipelines existants.
Utilisateurs d'entreprise et gestionnaires de contenu
Pour les entreprises. travail à grande échelle Le modèle est utile pour résoudre les problèmes de catalogage Création automatique de descriptions extraction Informations texte à partir de photos de documents ou de signes. L'analyse vidéo aide à traiter les enregistrements à partir de caméras de surveillance ou de webinaires.
Comment utiliser le réseau neuronal Qwen2-VL-72B-Instruct ?
Méthode d'utilisation Cela dépend de la formation technique de l'utilisateur et de l'objectif ultime.
Moyens d'accès
Le modèle se répand. comme produit logiciel libre. Le travail nécessitera des poids de modèles de téléchargement et les exécuter localement sur un serveur avec une puissance de calcul suffisante (GPU avec une grande quantité de mémoire vidéo). Option alternative – utiliser par l'intermédiaire de plateformes d'API tierces qui donnent accès au modèle par abonnement.
Scénario de base
L'utilisateur charge un fichier image ou vidéo, définit une requête de texte et le modèle retourne la réponse. Pour obtenir la qualité Il est important de formuler clairement les questions. : par exemple, "Écouter tous les objets de cette photo" ou "Reconnaissez le texte de l'image et traduisez-le en anglais ? Le modèle prend en charge le raisonnement étape par étape ce qu'il vous permet d'analyser des scènes complexes en étapes.
Structure de base Qwen2-VL-72B
Le modèle offre un ensemble de fonctions couvrant les scénarios clés du traitement visuel des données.
Vidéo de traitement d'image
Le réseau neuronal accepte les deux types de fichiers sans qu'il soit nécessaire de précoder. . La résolution dynamique vous permet de travailler efficacement comme une petite image bien et sur C'est beaucoup de vidéo.
Le raisonnement étape par étape et l'analyse visuelle
Au lieu d'une simple description, le modèle peut construire une réponse logique Questions sur les causes des événements vidéo comparer des objets Tirer des conclusions en fonction de ce que vous voyez.
Reconnaissance textuelle multilingue
Le module intégré OCR extrait du texte de l'image sur différentes langues. Ceci est utile pour le traitement des documents. screenshots Photos avec sous-titres ou signes.
Interaction des agents
Le modèle peut agir comme agent. exécuter des instructions dans le contexte vidéo. Par exemple, il est en mesure de suivre les changements dans les objets dans le cadre ou répondre aux questions, exigeant l'examen de la dynamique temporaire.
Avantages de Qwen2-VL-72B-Instruct
Les points forts du modèle le distinguent des outils de la génération précédente.
Haute précision et échelle
Avec 73,4 milliards de paramètres, le modèle démontre une compréhension profonde. contexte visuel . Elle fait face. sur la tâche , qui nécessite l'examen de nombreux détails et relations entre les objets.
##Universalité et multilinguisme
Combiner l'analyse d'image La reconnaissance vidéo et textuelle sur différentes langues dans un modèle simplifie le développement de produits complexes. Il n'est pas nécessaire de connecter plusieurs services spécialisés.
Flexibilité d'utilisation
La résolution dynamique et l'intégration de position améliorée permettent aux modèles de s'adapter à une taille d'entrée arbitraire sans perte de qualité. Ceci est important lorsque vous travaillez avec des formats de fichiers non standard.
Inconvénients de l'instruction Qwen2-VL-72B
Malgré les avantages Lors du choix d'un modèle, prendre en compte des limites précises.
Matériel à forte demande
Pour lancer un modèle de 73 milliards requis serveur plusieurs processeurs graphiques puissants . Cela rend l'utilisation locale coûteuse pour les petites équipes et les développeurs individuels.
Frontière restreinte
Modèle formé sur les données pertinentes jusqu'au 30 juin 2023 . Ils peuvent être mal interprétés ou non reconnus lors de l'analyse du contenu.
Qwen2-VL-72B-Instruction
La portée du modèle couvre un large éventail de tâches liées au contenu visuel.
##Reconnaissance du texte et des documents
Le modèle extrait et reconnaît efficacement le texte des photos, des scans et des captures d'écran. Il est en demande dans la numérisation automatique des tâches Modération du contenu et traitement des questionnaires.
Analyse du contenu vidéo
La possibilité de traitement vidéo permet de résoudre le contrôle de la qualité des tâches de surveillance eh créer des descriptions automatiques des vidéos et sous-titres.
Complexe. raisonnement visuel
Le modèle est capable de répondre aux questions exigeant l'analyse faciliter les interactions et les changements intemporels . C'est utilisé. aider les systèmes de sécurité et les services d'analyse.
Prix Qwen2-VL-72B-Instrument
Informations officielles sur le coût du modèle du développeur dans les ressorts ouverts Il n'a pas été publié. Le modèle se répand. sous licence tongyi\ qianwen qui fournit un accès libre au téléchargement de poids . Cependant, l'utilisateur devra couvrir indépendamment les coûts de l'informatique ressource Louer un serveur GPU ou acheter votre propre matériel . Le coût final dépend du fournisseur de cloud choisi et de la durée du modèle.
Conditions Qwen2-VL-72B-Instruction
Le modèle se répand. sous la licence tongyi qianwen développée par Alibaba. Cette licence fixe des restrictions à des fins commerciales de modélisation réglemente également les produits dérivés de la modification et de la distribution . Avant d'utiliser est recommandé regarder le texte complet de l'accord de licence afin de vérifier selon vos exigences de scénarios du titulaire du droit d'auteur.
Qwen2-VL-72B-Instruction
Le modèle est actuellement disponible en téléchargement. via les canaux officiels Alibaba et les dépôts de modèles . Informations sur des régions spécifiques dans lesquelles la disponibilité du matériel de référence n' est pas limitée . L'enregistrement est probablement nécessaire pour accéder aux poids plate-forme développeur et l'acceptation des termes de licence . De plus, le modèle peut être intégré dans des services tiers. fournir un accès à l'API.
Ce qui distingue Qwen2-VL-72B-Instruct des analogues
Il y a plusieurs produits multimodal sur le marché. modèle comparable avec Qwen2-VL-72B-Instruct . Parmi les plus récentes versions analogiques de Qwen3 VL 32B Thinking, Qwen2.5 VL 72B Instruct, Qwen2.5 VL 32B Instruct et QvQ-72B-Preview et Qwen2.5 VL 7B Instruct.
Comparaison avec les versions précédentes
La principale différence par rapport à Qwen2.5 est l'amélioration de la position architecturale et l'intégration dynamique. Le Qwen2-VL-72B-Instruct est un modèle unique. première ligne Qui a reçu l'intégralité du cycle de traitement vidéo Cependant, les modèles précédents ont surtout porté sur les images.
Différence par rapport aux modèles avec moins de paramètres
En comparaison. sur l'instruction compacte Qwen2.5 VL 7B La version de 73 milliards de dollars montre une plus grande précision sur les tâches visuelles complexes et fait mieux face à la reconnaissance des petits détails. Toutefois, cela se fait au prix de besoins beaucoup plus importants pour les ressources matérielles.
Différence par rapport aux autres modèles développeur
Contrairement à beaucoup. décisions commerciales fermées Qwen2-VL-72B-Instruct disponible avec le poids ouvert ce qui vous permet de l'adapter aux besoins spécifiques du projet sans référence au fournisseur d'API . Le concurrent le plus proche en fonctionnalité est Qwen3.6 Plus. Toutefois, une comparaison détaillée des performances nécessite des essais distincts. tâches ciblées.
Conclusion
Qwen2-VL-72B-Instruct est un modèle multimodal puissant d'Alibaba. qui couvre un large éventail de tâches liées à l'analyse d'images et de vidéos. 73,4 milliards de paramètres Avec une résolution dynamique et une meilleure intégration positionnelle, il est capable d'effectuer un raisonnement étape par étape. Reconnaître le texte dans différentes langues et interagir sur le contenu vidéo. Le modèle est adapté pour les développeurs et les entreprises prêtes à fournir les ressources informatiques nécessaires pour l'exécuter. Les principales limitations sont les équipements de haut niveau et la frontière de la connaissance limitée mi-2023 . Le choix entre ce modèle et les analogues actuels de la ligne Qwen dépend des tâches spécifiques et de la capacité disponible.
Foire aux questions
Voir aussi
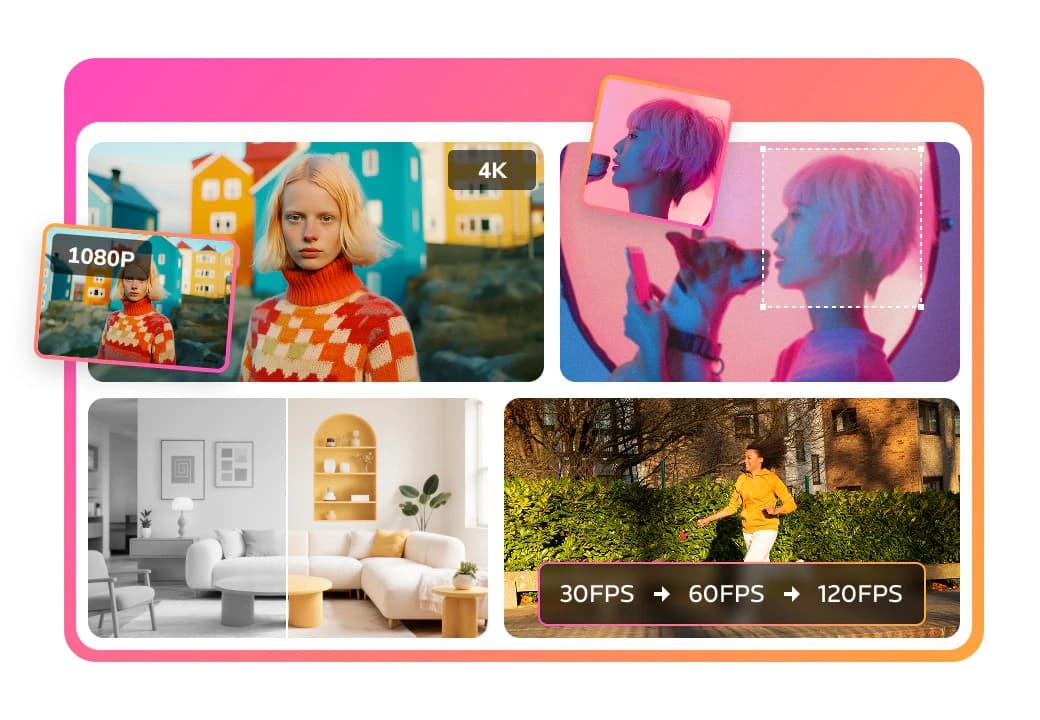
Une boîte à outils multimédia d'IA pour l'édition et l'amélioration des photos, vidéos et documents PDF.

Extension Chrome qui aide à gérer les onglets, l'historique, et les signets avec un assistant AI.

Un service en ligne qui reconnaît le texte sur les pages manga et manhwa, le traduit dans différentes langues, et l'intègre dans l'image sans endommager l'œuvre originale.

Boîte à outils AI pour la production et l'édition de vidéos, y compris les avatars, les lip-sync et le clonage vocal.

Plateforme pour la création de systèmes d'IA multi-agents et de chatbots pour automatiser le support client et la production de plomb.

Plateforme de gestion de projet avec affectation des tâches, suivi du temps et fonctions de surveillance de la charge de travail des employés.

Bibliothèque TypeScript qui vous permet d'utiliser GPT-4 comme un runtime pour les fonctions décrites par les commentaires.
Panneau d'IA latéral qui aide à répondre aux questions, à travailler avec les documents et à générer des images.