
Las personas son comprensibles, los LLM no: los expertos no pudieron explicar la lógica de los modelos
Los investigadores compararon los factores ocultos detrás de las respuestas de las personas y de seis modelos de lenguaje en tareas de razonamiento cuantitativo y química. Los factores extraídos de las respuestas humanas fueron interpretados con éxito por los expertos, mientras que la mayoría de los constructos de los modelos resultaron opacos para ellos.
Los humanos son comprensibles, los LLM no: los expertos no pudieron explicar la lógica de los modelos
Cuando miramos los resultados de las pruebas, parece natural suponer que la inteligencia artificial resuelve tareas «como un humano»: utiliza los mismos conceptos, reglas y razonamientos. Sin embargo, una nueva investigación pone en duda esta suposición. Los científicos descubrieron que las estructuras ocultas que determinan las respuestas de los LLM, en la mayoría de los casos, no se prestan a la interpretación humana — incluso para expertos en la materia.
Qué se comprobó exactamente
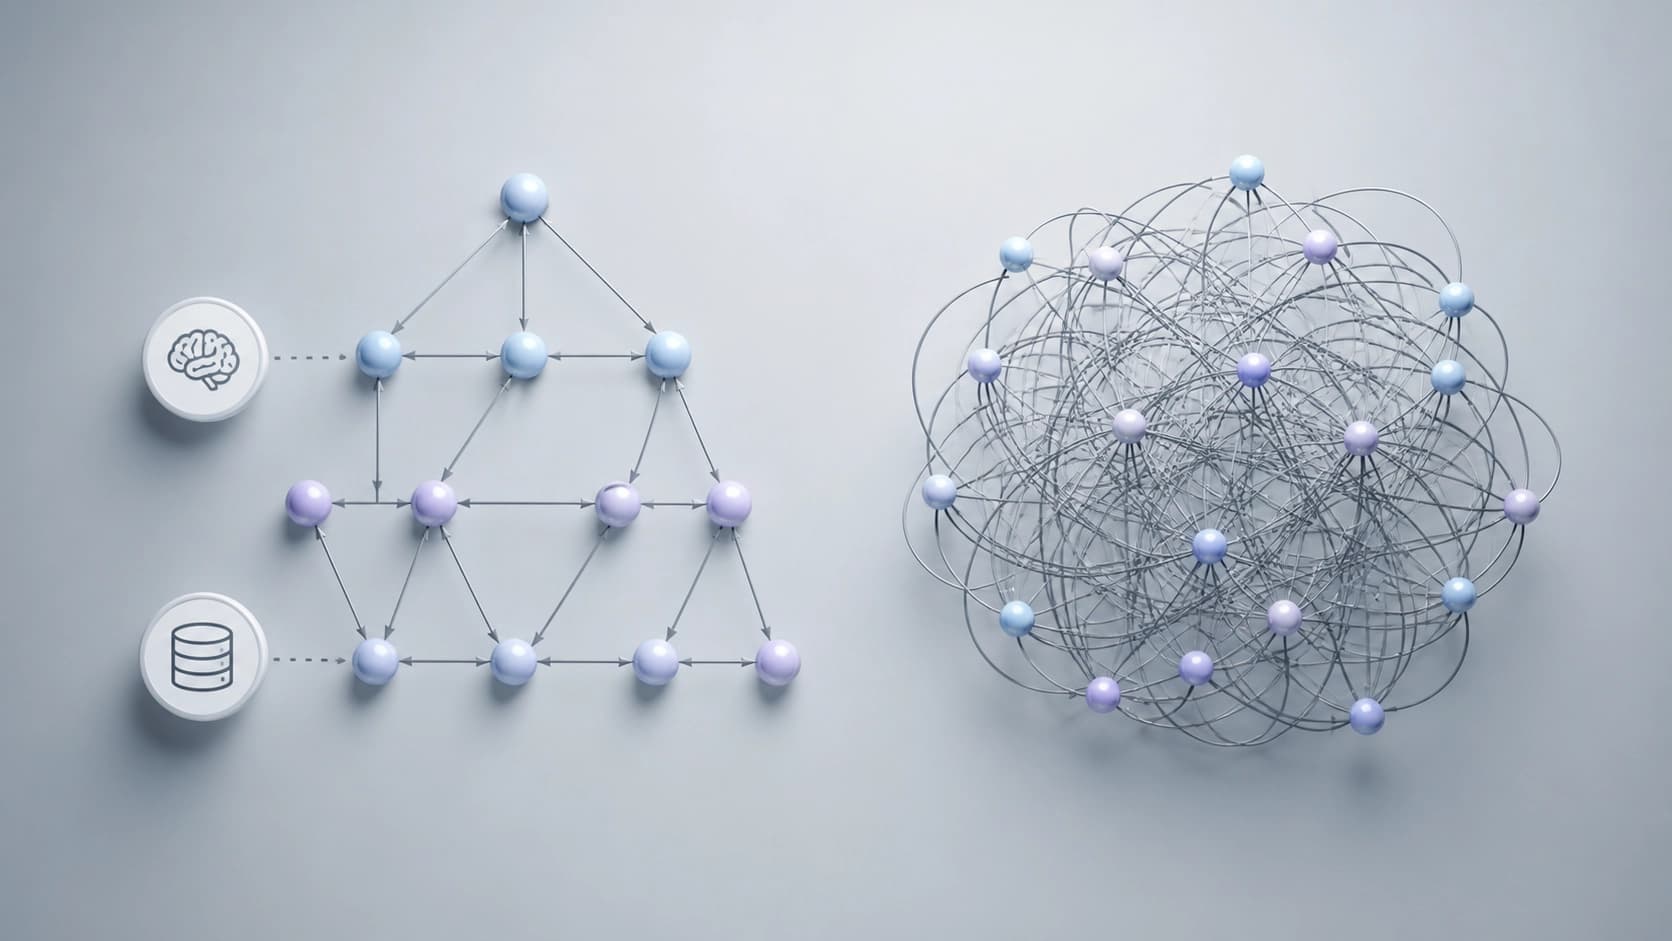
Los autores del trabajo (arXiv:2608.17810) — Alona Strugatski, Likol Zeinfeld, Jason Cooper y sus colegas — tomaron las respuestas de personas y de seis LLM diferentes en tareas de razonamiento cuantitativo y química. Mediante un análisis factorial exploratorio, identificaron para cada grupo factores latentes ocultos que supuestamente están detrás del éxito en la realización de estas tareas.
Luego, expertos en la materia examinaron a ciegas las estructuras obtenidas e intentaron atribuir a los factores un significado pedagógico: por ejemplo, «habilidad para trabajar con fórmulas» o «comprensión de la estequiometría». El formato ciego excluía pistas: los especialistas no sabían si los gráficos correspondían a personas o a modelos.
Resultado: la brecha en la interpretabilidad
Los expertos comprendieron casi sin problemas los factores obtenidos a partir de las respuestas humanas. La mayoría de los constructos recibió una explicación significativa que fue fácil de traducir en recomendaciones para el aprendizaje o el diagnóstico.
Con los LLM, el panorama resultó diferente:
- En el razonamiento cuantitativo, los expertos no pudieron interpretar de manera significativa ninguno de los factores identificados para los modelos.
- En química, la situación fue un poco mejor, pero igualmente lejos de lo ideal: solo se logró explicar alrededor de la mitad de las estructuras.
Qué significa esto
Los autores llegan a una conclusión importante: cuando los LLM muestran resultados altos en las pruebas, esto no significa que razonen de la manera a la que estamos acostumbrados. Los modelos pueden encontrar formas estadísticamente eficientes, pero completamente «ajenas» para los humanos, de resolver tareas. Sus mecanismos internos funcionan a nivel de patrones que no tienen un significado pedagógico o cognitivo comprensible.
Esta observación desafía la práctica común de intentar sacar conclusiones sobre el nivel de conocimiento o competencias a partir de los resultados de la IA. Si no podemos explicar qué construcciones exactas están detrás de las respuestas, corremos el riesgo de atribuir a los modelos capacidades inexistentes — o, por el contrario, pasar por alto limitaciones reales.
Hacia dónde avanzar
La investigación no afirma que interpretar los LLM sea imposible en principio. Solo muestra que el enfoque clásico, creado para estudiar la cognición humana, no se traslada directamente a los modelos. Quizás sea necesario desarrollar métodos de análisis fundamentalmente nuevos — aquellos que tengan en cuenta la naturaleza «no humana» de las estructuras latentes.
Por ahora, queda abierta la pregunta: si los expertos no pueden explicar la lógica de los modelos, ¿podemos confiar en su uso en la educación y la evaluación del conocimiento? La respuesta, probablemente, requerirá revisar tanto los enfoques para evaluar la IA como nuestras expectativas sobre la «inteligencia» de las máquinas.
Preguntas frecuentes
Material similar
Todos los materiales
Verificar candidatos cuesta más que generarlos: señuelos contra la búsqueda de vulnerabilidades con LLM
El trabajo analiza la asimetría de costes en la búsqueda agéntica de defectos: generar candidatos es barato, pero confirmarlos mediante análisis de alcanzabilidad, ejecución y PoC requiere la mayor parte del presupuesto, por lo que la verificación puede convertirse en un objetivo de defensa por sí misma. La propuesta RedHerring —señuelos adaptados al repositorio con un certificado oculto— redujo entre un 38,7 y un 60,4 % el número de vulnerabilidades reales encontradas con el mismo coste en 33 proyectos de OSS-Fuzz; incluso tras advertir al agente, la reducción se mantuvo en el 37,2 %.
9 noviembre 2026
Verificación de alucinaciones de LLM mediante una vista SQL de las fuentes, sin reentrenamiento
El estudio evalúa si un LLM puede aprovechar una habilidad simbólica básica —crear una base de datos SQL a partir de documentos fuente— para fundamentar sus respuestas en las fuentes sin supervisión al detectar alucinaciones. En RAGTruth y DiaHalu, este flujo de trabajo neuro-simbólico resulta más preciso que la predicción directa y comparable a los métodos más avanzados, sin requerir un ajuste fino al dominio.
9 noviembre 2026
MathAdv: qué oculta la precisión final de las demostraciones de máquinas
Un conjunto diagnóstico de tareas de 13 áreas de matemáticas de nivel universitario y de posgrado evalúa los sistemas de demostración automática en Lean 4 no solo por el resultado final, sino también por su dominio de la materia, la calidad de sus razonamientos informales y su robustez ante reformulaciones de los enunciados. El análisis por componentes muestra que traducir un problema a un formato formal sigue siendo el principal obstáculo, y que el éxito depende en gran medida del área matemática y de cómo se plantee el problema.
9 noviembre 2026