Qué debe planificar exactamente la IA
La planificación urbana es aquí un problema de optimización espacial: hay que elegir acciones admisibles de entre un amplio conjunto de candidatas.
Entre los objetivos prácticos figuran el coste y la calidad del servicio.
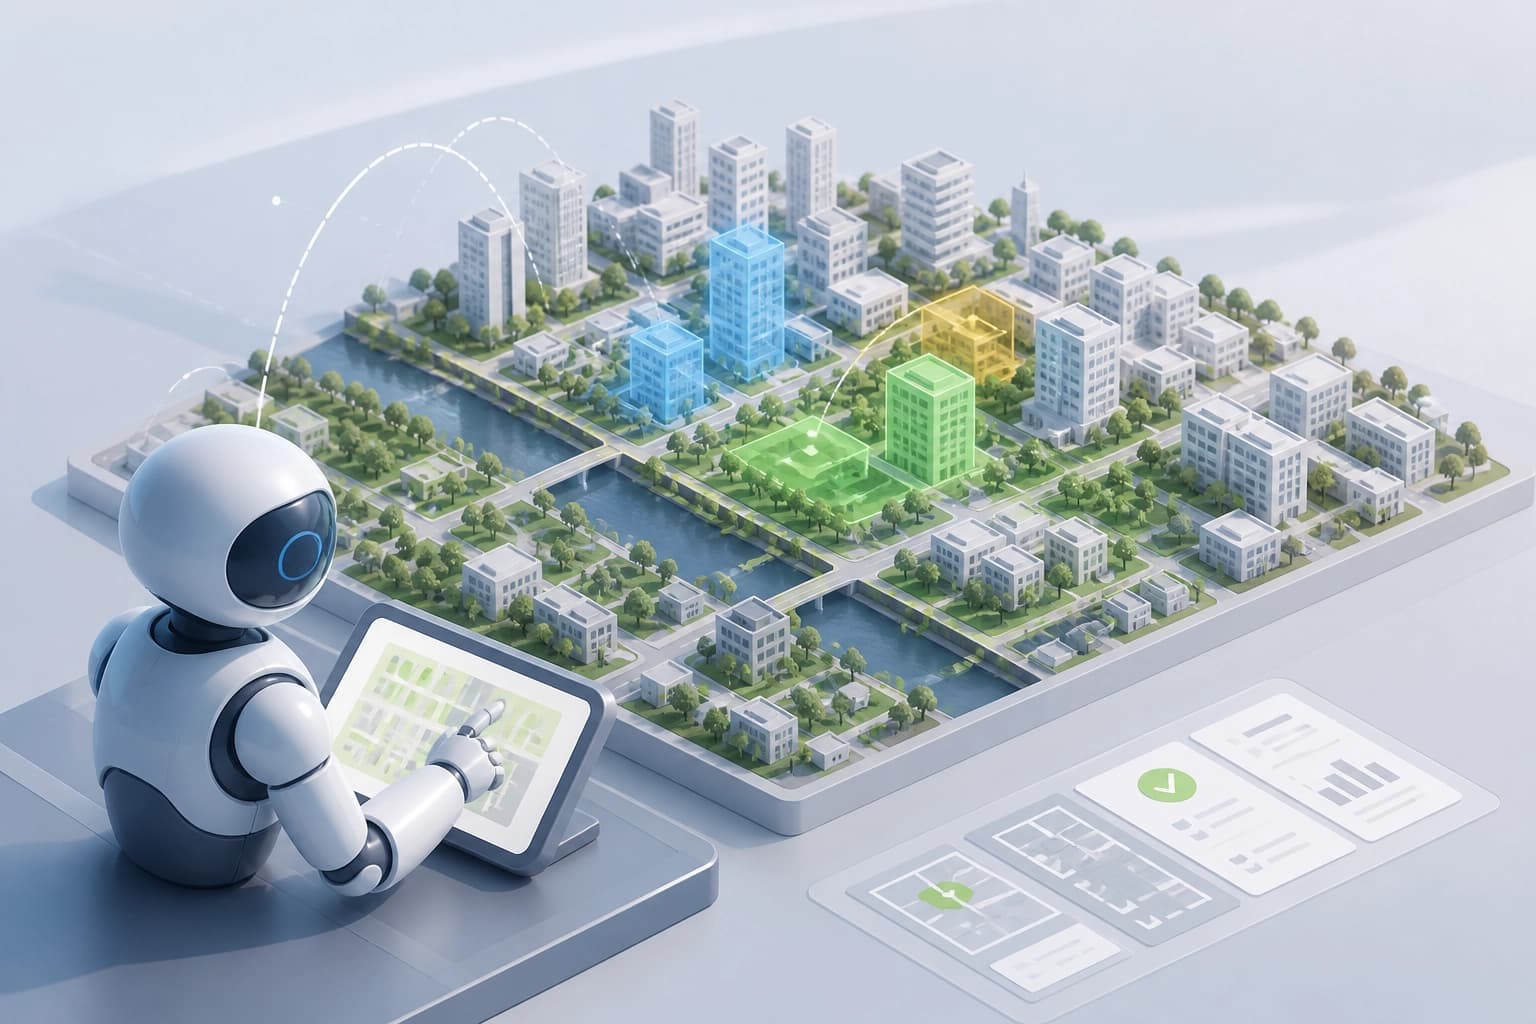
El trabajo CityPlanner describe un agente sandbox para la planificación urbana ejecutable.
Un escenario verificable vincula el plan con su evaluación: el sistema ejecuta un evaluador y obtiene retroalimentación ejecutable.
En este planteamiento, son importantes las acciones admisibles, el objetivo práctico y la posibilidad de evaluar el resultado.
El criterio de verificabilidad es que el entorno pueda evaluar el plan creado.
Cómo funciona el entorno de ejecución
En UrbanSandbox, el agente trabaja en un entorno de archivos unificado.
Examina los archivos de la tarea, crea un plan, ejecuta evaluadores y revisa la solución a partir de la retroalimentación.
El ciclo combina el trabajo con los datos de la tarea y la verificación del plan.
Acciones principales del agente:
- examinar los archivos de la tarea;
- crear un plan;
- ejecutar un evaluador;
- revisar la solución a partir de la retroalimentación ejecutable.
El entorno es adecuado para un escenario si el agente puede completar en él todo el ciclo, desde examinar la tarea hasta revisar el plan.
Cómo dividir el aprendizaje
Los autores proponen el aprendizaje por refuerzo de tareas atómicas (atomic-task reinforcement learning): las trayectorias largas en el sandbox se dividen en dos tareas.
Esta división simplifica el aprendizaje al separar la creación inicial del plan de su mejora.
Cada tarea se ocupa de una etapa distinta del trabajo con el plan.
- BuildPlan — crear el plan inicial.
- ImprovePlan — mejorar el plan a partir de la retroalimentación.
Esta división es adecuada cuando el aprendizaje combina la creación de un plan y su posterior ajuste a partir de los resultados de la evaluación.
Qué muestran los experimentos
En un benchmark real, CityPlanner superó de forma consistente a tres grupos de comparación:
| Con qué se comparó | Resultado |
|---|---|
| Métodos heurísticos | El agente obtuvo el mejor resultado |
| RL específico para la tarea | El agente obtuvo el mejor resultado |
| Modelos de referencia de agentes LLM de propósito general | El agente obtuvo el mejor resultado |
Los estudios de ablación confirmaron la contribución de UrbanSandbox, atomic-task RL e iterative deployment.
Los autores informan de la publicación del código y del conjunto de datos.
El trabajo se presentó el 9 de septiembre de 2026 y está siendo evaluado por EMNLP.
La conclusión práctica se limita a los resultados de este benchmark: respaldan el esquema propuesto, pero no demuestran que sea superior para cualquier tarea urbana.
Fuente: arXiv:2609.09578.