
Nuevos modelos Samsung Health AI aprenden a entender las señales del cuerpo de dispositivos utilizables
Samsung Research America presentó dos modelos de IA fundamental que aprenden de datos de smartwatch: señales de corazón, sueño y actividad. Ayudan a que el análisis de salud sea más preciso y se ejecute directamente en el propio dispositivo.
Nuevos modelos Samsung Health AI Aprende a comprender las señales corporales de los tejidos
Samsung está apostando por la medicina preventiva, y se espera que los nuevos desarrollos en la inteligencia artificial acerquen ese momento. La división de investigación de Samsung Research America ha introducido dos modelos de IA fundamental diseñados para analizar biosignales recolectados por smartwatches y otros dispositivos utilizables. Estos modelos no son sólo para registrar las métricas, sino para extraer ideas útiles de salud de ellas, continua y sin intervención humana.
El trabajo forma parte del concepto de Cuidados Conectados más amplio que Samsung discutió en el Foro de Salud en julio de 2026. La idea es combinar datos de los usables, la medicina tradicional y los servicios asociados en un sistema único capaz de anticipar problemas antes de que se vuelvan serios. Los nuevos modelos son la base técnica para este enfoque: aprenden a comprender cómo se relacionan las diferentes señales corporales entre sí, y a hacerlo directamente en el dispositivo.
Por qué los algoritmos convencionales quedan cortos con biosignales
Data from wearables is not just step counts and heart rate. Consiste en series de tiempo complejas, incluyendo electrocardiogramas (ECG), fotopletismogramas (PPG), información del estadio del sueño y actividad motora. Estas señales son altamente dependientes del contexto: la misma frecuencia cardíaca puede significar estrés, esfuerzo físico o el inicio de la enfermedad. La formación de modelos clásicos en todos estos matices es difícil, especialmente cuando los datos médicos etiquetados son escasos.
Por eso los investigadores se dirigieron a aprendizaje autosupervisado. El modelo en sí mismo encuentra patrones en grandes volúmenes de datos no etiquetados, y estas ideas se pueden aplicar a tareas específicas, como predecir riesgos cardiovasculares o clasificar las etapas del sueño. Este enfoque ya ha resultado exitoso en el procesamiento de textos y imágenes, y ahora se está adaptando para biosignales.
El modelo xMAE: aprender a ver el corazón a través del pulso
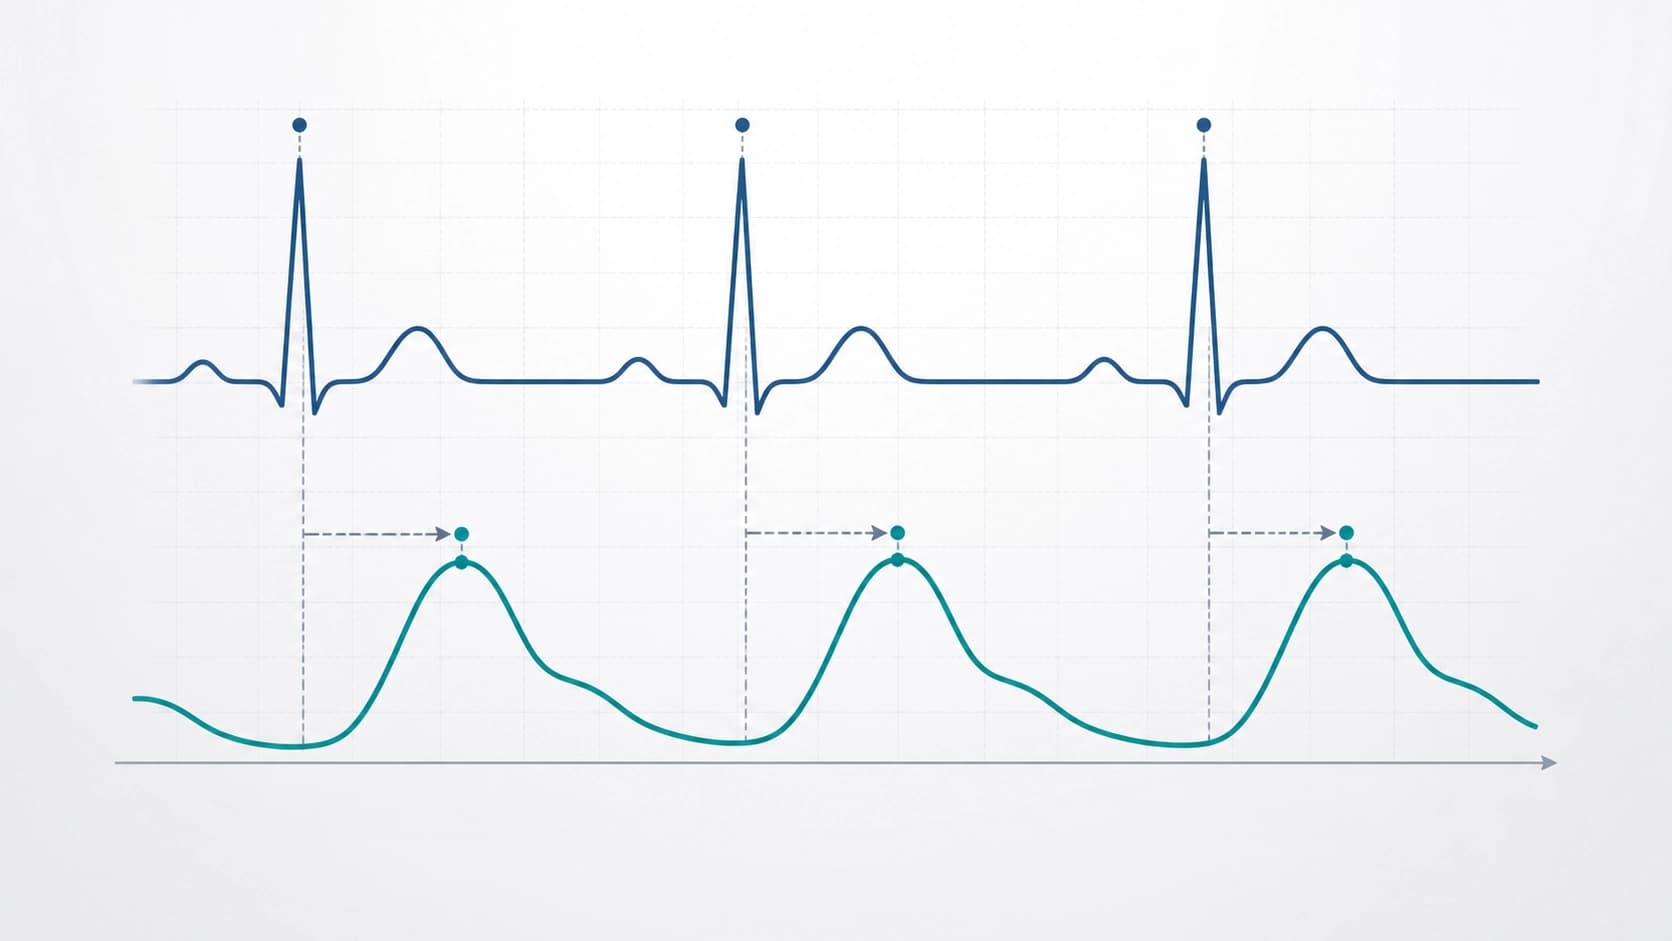
El primer modelo se llama xMAE (Reconstrucción Cruz-Modal Mascada con Pisiología). Su característica clave es la capacidad de vincular diferentes tipos de señales. Específicamente, xMAE aprende la relación entre datos PPG continuos y señales ECG.
Como recordatorio: ECG mide directamente la actividad eléctrica del corazón y permite evaluar el ritmo, la variabilidad y la detección de anomalías como la fibrilación auricular. Pero en los wearables, tomar un ECG requiere detener y colocar un dedo en un electrodo, no funciona pasivamente. PPG, por otro lado, mide continuamente los cambios de flujo sanguíneo a través de un sensor óptico. Sin embargo, hay un retraso entre el impulso eléctrico del corazón y la onda de pulso, como la brecha entre el rayo y el trueno. El reto es entender cómo reconstruir una señal de la otra.
xMAE resuelve este problema: aprende a reconstruir segmentos "mascados" de ECG de datos PPG. El modelo fue preentrenado en cerca de 9.400 horas de grabaciones simultáneas de ECG y PPG. Como resultado, el modelo puede estimar las características cardiovasculares de PPG continuo sin necesidad de mediciones manuales separadas. Esto hace que el control del corazón sea casi invisible para el usuario.
En las pruebas, los modelos unimodales no utilizados xMAE y varios métodos de aprendizaje multimodal existentes en 15 de 19 tareas de evaluación. Estas tareas incluyen la predicción de enfermedades cardiovasculares, la detección de resultados de laboratorio anormales y la determinación de etapas de sueño. Además, las características aprendidas resultaron robustas a los cambios en la colocación de dispositivos y sensores, pavimentando el camino para un modelo unificado a través de diferentes dispositivos utilizables.
El modelo HiMAE: análisis compacto en múltiples escalas de tiempo
El segundo modelo —HiMAE (Hierarchical Masked Autoencoder)— plantea un desafío diferente. Las biosignales cambian a diferentes velocidades: el ritmo cardíaco fluctúa cada segundo, mientras que los patrones de sueño se desarrollan durante minutos y horas. Para capturar ambos tipos de patrones, HiMAE utiliza múltiples codificadores que analizan segmentos de datos cortos y largos por separado. Esto permite que el modelo se adapte a la escala de tiempo adecuada dependiendo de la tarea, por ejemplo, analizar la variabilidad de la frecuencia cardíaca o predecir la calidad del sueño.
El entrenamiento de HiMAE también se construye en la reconstrucción de fragmentos de datos enmascarados, por lo que no requiere un conjunto de datos etiquetado grande. Al mismo tiempo, un único modelo preentrenado puede manejar diferentes tipos de tareas: clasificación, predicción numérica e incluso generación de datos.
La ventaja clave de HiMAE es la eficiencia. Consigue una alta precisión con un tamaño de modelo más pequeño que las alternativas existentes y realiza computaciones en menos de 1 mil segundos en un procesador de clase smartwatch. Esto significa que el análisis puede funcionar en el dispositivo sin enviar datos a la nube. Para el usuario, esto se traduce en privacidad y respuesta instantánea, por ejemplo, a un ritmo cardíaco anormal.
¿Qué sigue?
Según Sharani Desai, jefe de algoritmos de salud digital en Samsung Research America, estos modelos son sólo la base. En el futuro, el enfoque se extenderá a otras biosignales y características de salud, al tiempo que seguirá trabajando en dispositivos con sensores limitados y recursos computacionales. Subbu Venkatraman, jefe del laboratorio de investigación de salud digital, añade que la contribución clave del trabajo está demostrando la viabilidad de los modelos de base de salud para captar relaciones entre señales y estructuras temporales.
Ambos modelos han sido aceptados para su publicación en conferencias prestigiosas —ICML (xMAE) e ICLR (HiMAE)— en las que se subraya la importancia científica del trabajo. Pero lo más importante es que este es un paso para que los wearables se conviertan en más que un contador de pasos, evolucionando en un asistente de salud personal que nota problemas antes que la persona.
Preguntas frecuentes
Material similar
Todos los materiales
Verificar candidatos cuesta más que generarlos: señuelos contra la búsqueda de vulnerabilidades con LLM
El trabajo analiza la asimetría de costes en la búsqueda agéntica de defectos: generar candidatos es barato, pero confirmarlos mediante análisis de alcanzabilidad, ejecución y PoC requiere la mayor parte del presupuesto, por lo que la verificación puede convertirse en un objetivo de defensa por sí misma. La propuesta RedHerring —señuelos adaptados al repositorio con un certificado oculto— redujo entre un 38,7 y un 60,4 % el número de vulnerabilidades reales encontradas con el mismo coste en 33 proyectos de OSS-Fuzz; incluso tras advertir al agente, la reducción se mantuvo en el 37,2 %.
9 noviembre 2026
Verificación de alucinaciones de LLM mediante una vista SQL de las fuentes, sin reentrenamiento
El estudio evalúa si un LLM puede aprovechar una habilidad simbólica básica —crear una base de datos SQL a partir de documentos fuente— para fundamentar sus respuestas en las fuentes sin supervisión al detectar alucinaciones. En RAGTruth y DiaHalu, este flujo de trabajo neuro-simbólico resulta más preciso que la predicción directa y comparable a los métodos más avanzados, sin requerir un ajuste fino al dominio.
9 noviembre 2026
MathAdv: qué oculta la precisión final de las demostraciones de máquinas
Un conjunto diagnóstico de tareas de 13 áreas de matemáticas de nivel universitario y de posgrado evalúa los sistemas de demostración automática en Lean 4 no solo por el resultado final, sino también por su dominio de la materia, la calidad de sus razonamientos informales y su robustez ante reformulaciones de los enunciados. El análisis por componentes muestra que traducir un problema a un formato formal sigue siendo el principal obstáculo, y que el éxito depende en gran medida del área matemática y de cómo se plantee el problema.
9 noviembre 2026