
RLTLDR: el agente saca sus propias conclusiones del fracaso y las tiene en cuenta en el siguiente intento
Tras un fallo, se muestra al agente la señal del verificador y se le pide condensarla en una sola pista; el entrenamiento se realiza con pares «tarea-pista», sin profesor ni soluciones de referencia. En conjuntos de datos complejos de programación y uso de herramientas, el método eleva Pass@1 del 0–1 % de GRPO al 12–31 %, y la mejora decisiva se debe precisamente a aprender este tipo de asociación.
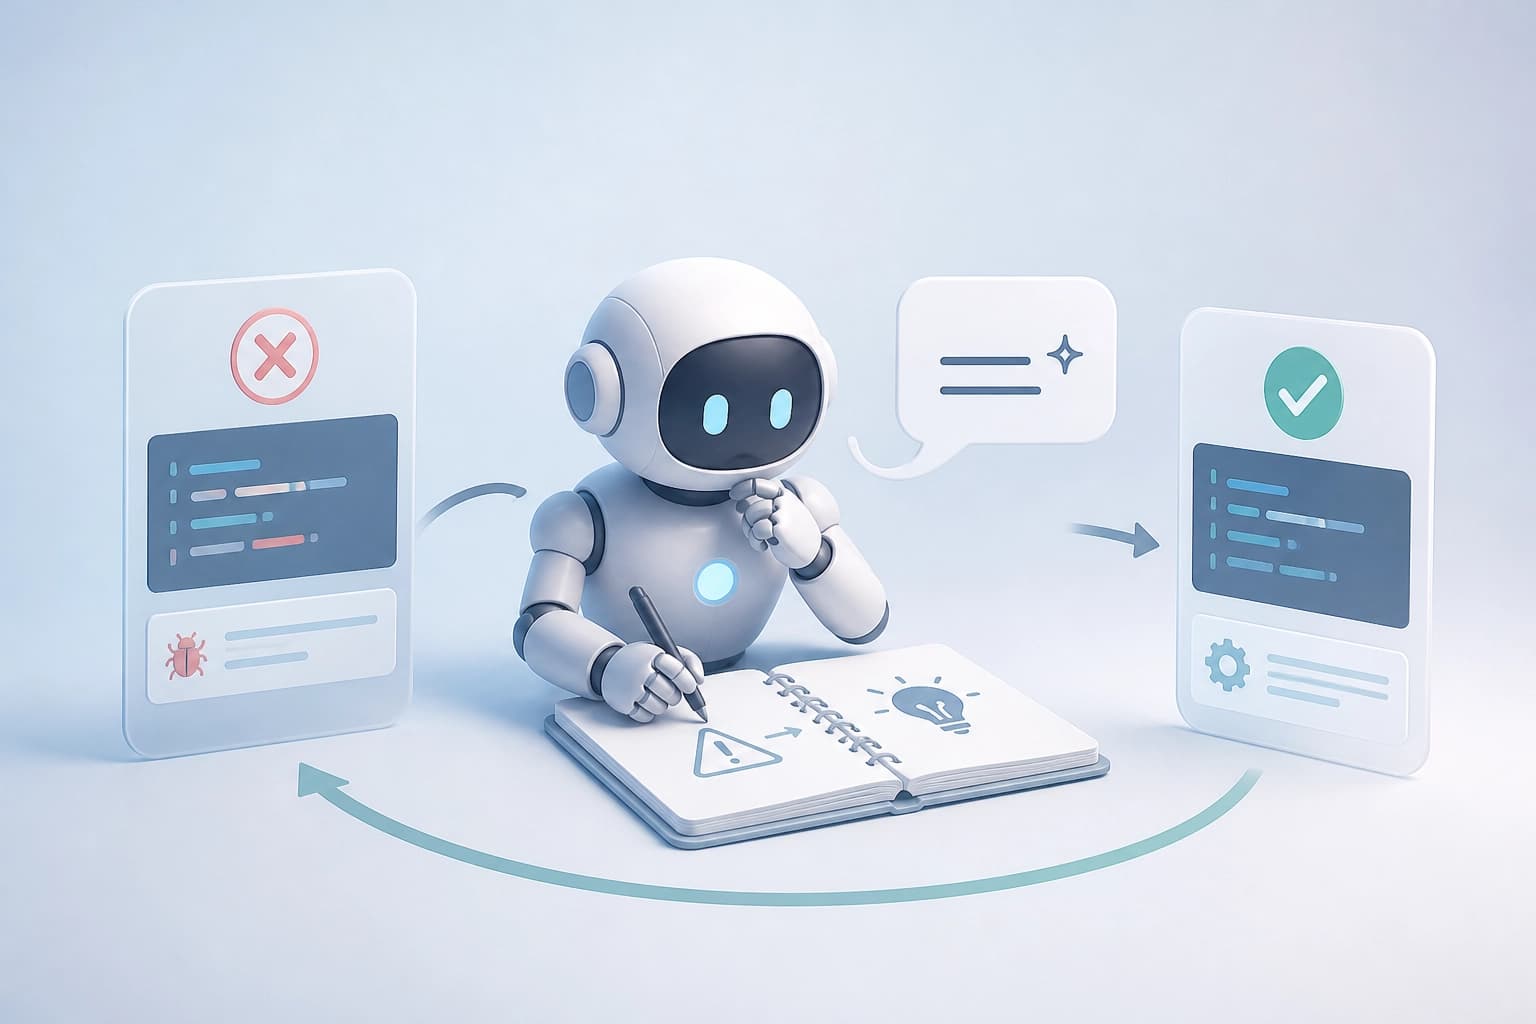
RLTLDR es un método de autoMejora del agente para tareas en las que resulta difícil tener éxito. Tras un intento fallido, el agente ve la salida del verificador y formula por sí mismo una conclusión breve: un insight TL;DR. El siguiente intento tiene en cuenta todas las conclusiones anteriores. El trabajo de Michael Kirchhof, Eleonora Gualdoni, Andrew Szot y sus coautores describe este enfoque. La primera versión se presentó el 29 de septiembre de 2026. La última revisión es del 19 de octubre de 2026.
El problema que resuelve RLTLDR
RLTLDR está orientado a la autoMejora del agente. En estas tareas, al agente le cuesta tener éxito. No hay modelos docentes ni ejemplos de soluciones para la destilación. Por eso, la fuente de retroalimentación es el fracaso y la salida del verificador.
Condiciones de la tarea:
- no hay modelos docentes;
- no hay ejemplos de soluciones para la destilación;
- al agente le cuesta tener éxito;
- tras un fracaso, se dispone de la salida del verificador.
Conclusión: RLTLDR es útil cuando no hay soluciones preparadas ni un modelo docente, pero sí existe un fracaso verificable. El criterio práctico es que haya un verificador cuya salida se pueda proporcionar al agente.
Cómo funciona el ciclo
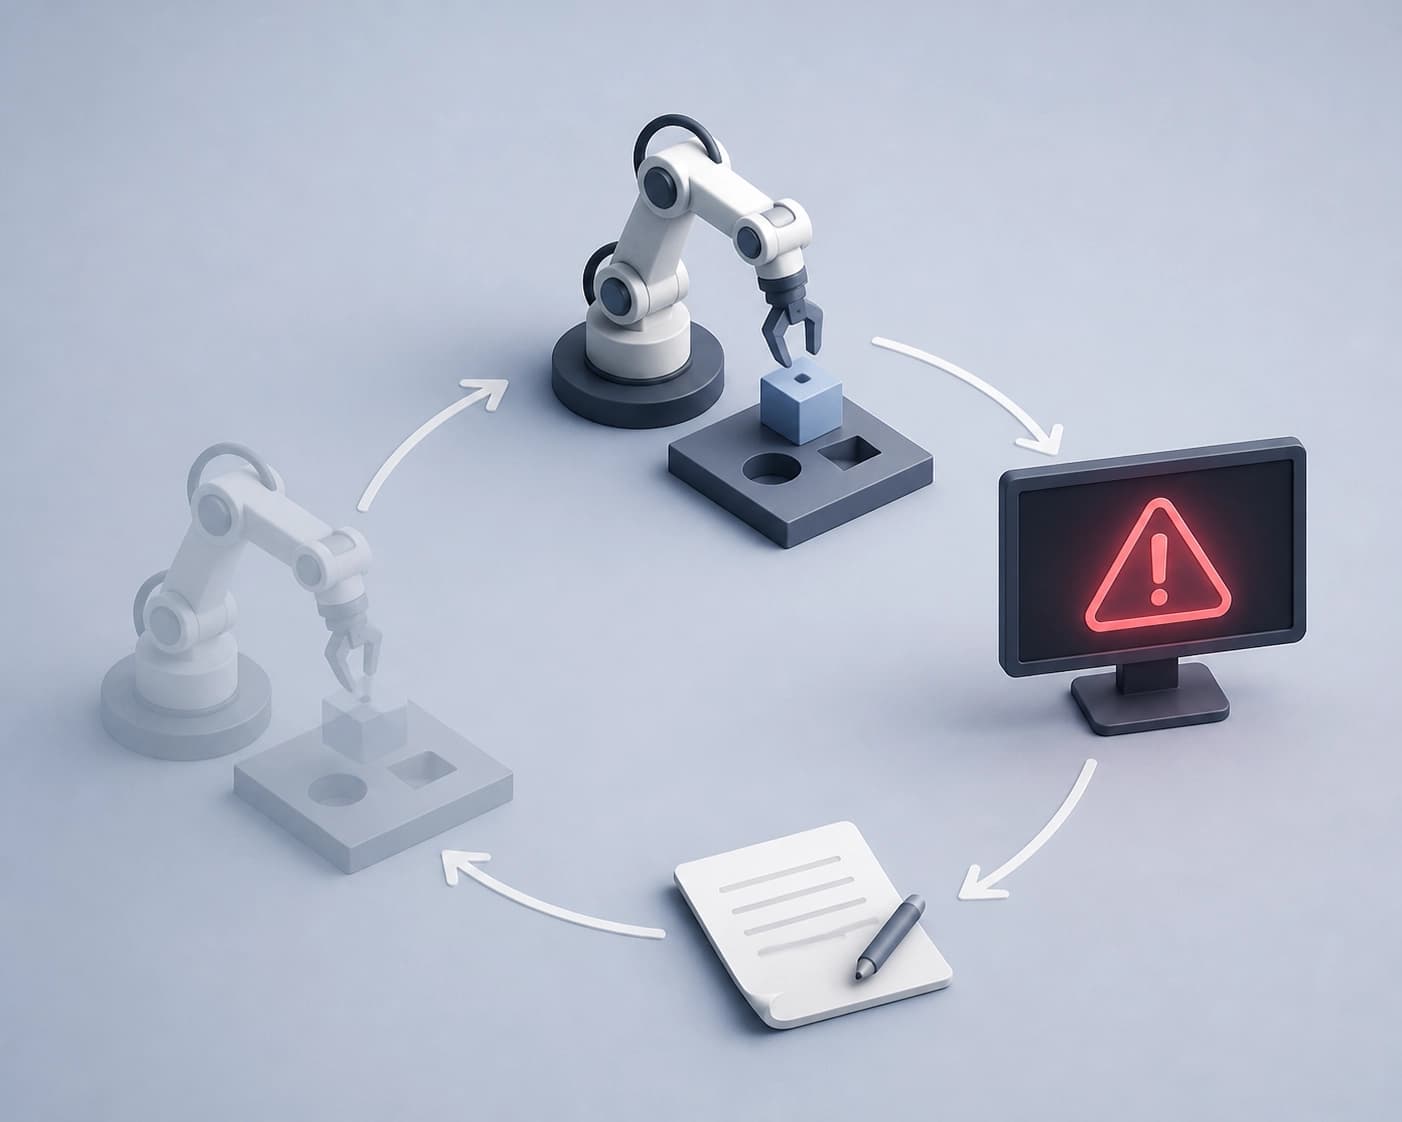
El ciclo de RLTLDR se basa en intentos sucesivos. Cada fracaso aporta material para el siguiente paso.
Etapas:
- El agente realiza un rollout y fracasa.
- El agente ve la salida del verificador.
- El agente formula su propia retroalimentación: un insight TL;DR breve.
- El siguiente rollout tiene en cuenta todas las conclusiones anteriores.
- Los rollouts continúan de forma sucesiva hasta encontrar una solución.
- El entrenamiento con backpropagation sobre las conclusiones en contexto aprende la correspondencia «tarea → conclusión».
Conclusión: el valor del ciclo no reside solo en ofrecer una indicación para el siguiente intento. El factor clave es aprender la relación entre la tarea y la conclusión.
Resultados en tareas difíciles
Las pruebas se realizaron en conjuntos difíciles de tool-calling y coding. Los autores filtraron los conjuntos con el criterio Pass@128=0. La comparación se realiza con la política Qwen 3.5 9B Thinking.
| Enfoque | Condiciones de evaluación | Pass@1 |
|---|---|---|
| Entrenamiento GRPO estándar | Sin el ciclo de conclusiones descrito | 0–1% |
| RLTLDR | Conclusiones en contexto durante el entrenamiento | 14–31% |
| RLTLDR | Sin conclusiones en contexto durante la evaluación | 12–13% |
El entrenamiento GRPO estándar se mantiene en un Pass@1 del 0% al 1%. RLTLDR alcanza el 14–31% cuando hay conclusiones en contexto durante el entrenamiento. Sin conclusiones en contexto durante la evaluación, el resultado es del 12–13%. Los autores destacan el aprendizaje de la correspondencia «tarea → conclusión» como factor clave.
Conclusión: las conclusiones en contexto aumentan Pass@1. Para comprobar si se ha producido aprendizaje, hay que evaluar el método tanto con conclusiones como sin ellas.
SFTLDR: entrenamiento con pares «tarea — conclusión»
SFTLDR es una variante de entrenamiento compacta. Aprende únicamente con pares (tarea, conclusión). No utiliza rollouts ni backpropagation sobre ellos.
Lo que se sabe sobre SFTLDR:
- el entrenamiento se realiza únicamente con pares (tarea, conclusión);
- SFTLDR no muestra rollouts;
- SFTLDR no aplica backpropagation sobre los rollouts;
- el entrenamiento con 4k de estos pares recupera casi todo el rendimiento de RLTLDR;
- SFTLDR casi alcanza el rendimiento del SFT clásico con rollouts completos;
- los autores describen el enfoque como un paradigma compacto: «para tareas de este tipo, ten presentes cosas de este tipo».
Conclusión: SFTLDR es una opción de entrenamiento compacta. El criterio: probarlo cuando se puedan recopilar pares «tarea — conclusión».
Criterios de aplicabilidad
RLTLDR requiere retroalimentación verificable e intentos sucesivos. Sin estas condiciones, no es posible construir el ciclo. Los siguientes criterios ayudan a evaluar su aplicabilidad.
Criterios:
- la tarea permite intentos fallidos y rollouts repetidos;
- hay un verificador cuya salida se puede mostrar al agente;
- el agente puede formular una conclusión breve;
- el siguiente intento tiene en cuenta todas las conclusiones anteriores;
- la evaluación incluye un modo sin conclusiones en contexto, si es importante comprobar el aprendizaje.
Conclusión: RLTLDR se elige para tareas en las que hay un verificador y resulta difícil tener éxito. SFTLDR se elige cuando se necesita un modo compacto basado en pares «tarea — conclusión».
Preguntas frecuentes
Material similar
Todos los materiales
COPEX ayuda a distinguir las vulnerabilidades del modelo de los puntos débiles de la infraestructura MCP
El benchmark controlado fija la infraestructura del agente y evalúa únicamente la selección de herramientas por parte del modelo de lenguaje en 125 escenarios de ataque a través de cuatro canales MCP. En 3 375 pruebas con nueve modelos, la tasa media de ataques exitosos fue del 64,4 %, y la validación conjunta de las entradas y el contexto la redujo casi a la mitad.
12 noviembre 2026
Corrección probabilística de pronósticos de oleaje: BridgeCast conecta modelos físicos con el reanálisis mediante emparejamiento en streaming
Se presenta un método híbrido que, mediante emparejamiento de flujos condicionales, una arquitectura de transformadores y características atmosféricas exógenas, transforma las salidas de los modelos físicos de oleaje en campos similares a los de reanálisis. Los autores informan de una ventaja constante frente a las soluciones de referencia más avanzadas anteriores en distintos plazos de antelación y regiones.
12 noviembre 2026
OpenCollab: coordinación programable de agentes, entorno de ejecución controlado y métrica de cumplimiento de las normas
El framework integra la definición de la estructura de interacción entre agentes, un entorno común para los experimentos y un seguimiento detallado de los eventos, mientras que la métrica Adherence, introducida en este trabajo, refleja hasta qué punto la ejecución real se ajusta al esquema declarado. En los benchmarks, la configuración Duo alcanza un nuevo nivel de SOTA, mientras que la variante de un solo agente destaca por consumir la menor cantidad de tokens.
11 noviembre 2026