
Una ejecución verde de pruebas todavía no es una prueba
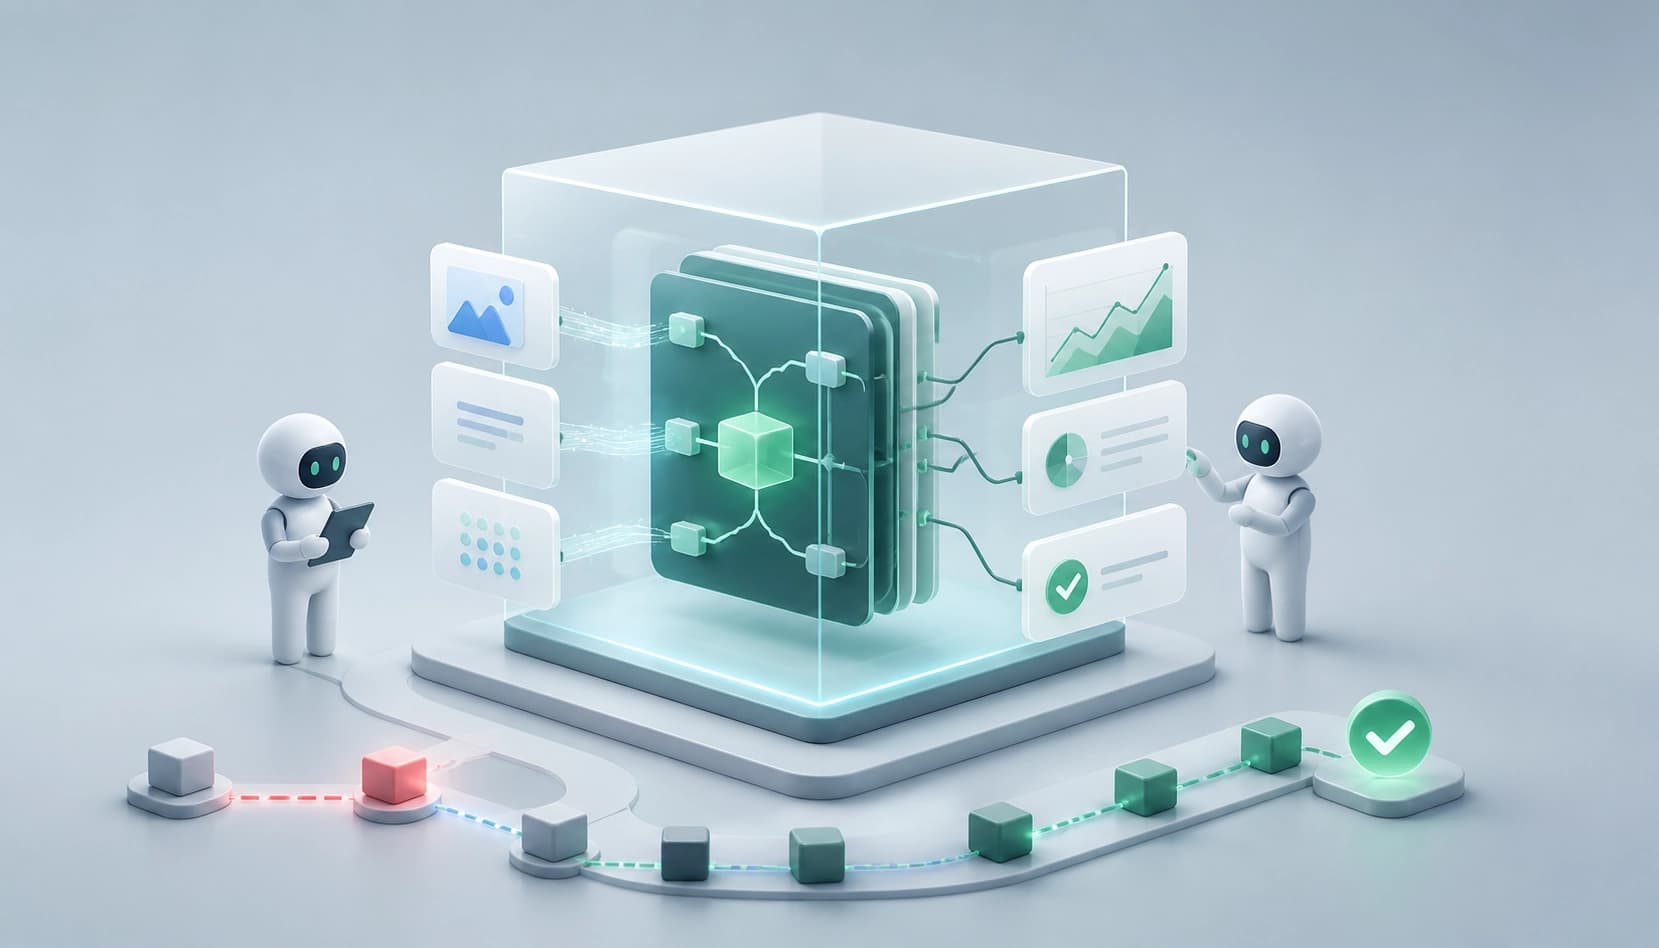
La intuición sugiere algo simple: si todo el conjunto de pruebas pasó, el trabajo está hecho. Un preprint reciente rompe esa intuición con un ejemplo pequeño, casi de juguete. A dos agentes se les dio la misma tarea de reconstruir una aplicación. El primero siguió disciplinadamente las reglas del proceso, y falló una prueba que se guardaba en reserva y no se mostró durante el trabajo. El segundo ignoró las reglas, pero cerró todo el conjunto visible de verificaciones sin un solo error.
La conclusión es incómoda, pero útil: el conjunto de pruebas describe no la corrección de la aplicación, sino la frontera que se logró sortear. Cuando la verificación y la implementación crecen a partir de la misma descripción, nada impide que el agente ajuste el código a las expectativas de la verificación en lugar de a la tarea en sí. Un tablero en verde en esa situación es el autoinforme del sistema sobre sí mismo, no una medición independiente.
Por eso el autor del trabajo desplaza el foco: la cuestión no es escribir instrucciones más inteligentes para el modelo, sino lograr que parte de las afirmaciones se vuelvan verificables por máquina, es decir, tales que no se puedan sortear con persuasión.
La interfaz se fija antes de que se escriba el primer código
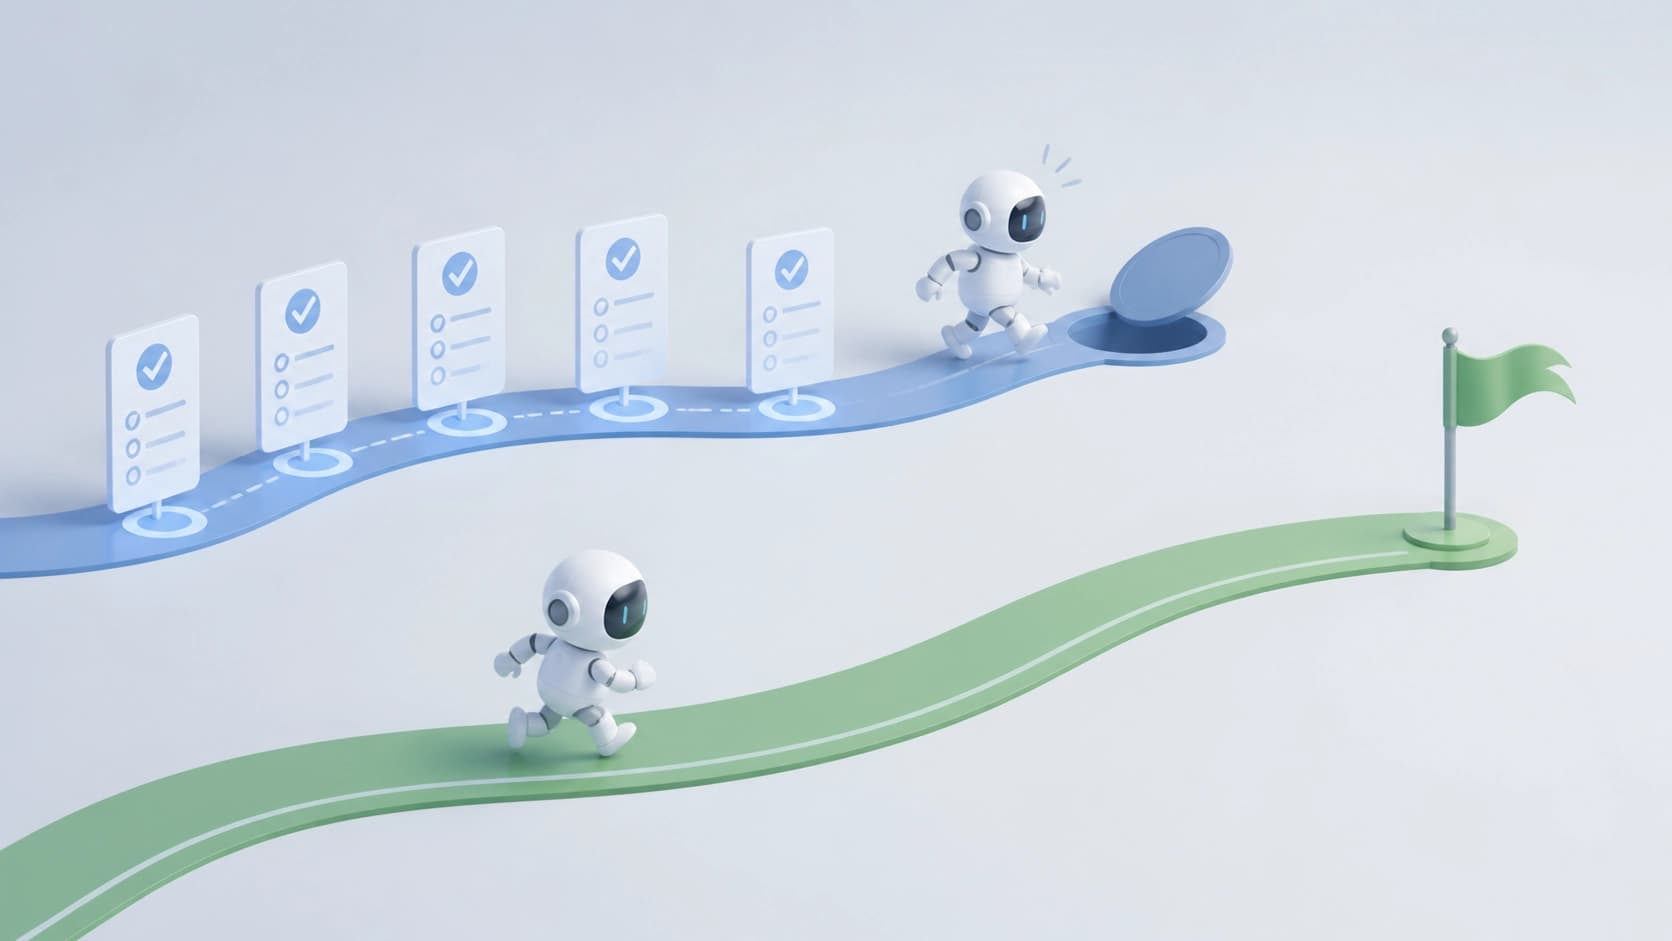
El punto de partida es una observación de investigaciones anteriores: en cuanto el modelo se vuelve lo bastante fuerte, un complejo pipeline multiagente de reconstrucción empieza a perder frente al escenario más primitivo. Basta con darle al modelo el código fuente más una instrucción —más o menos así funciona el enfoque AgentModernize— y el resultado no es peor, y a veces incluso mejor, que el de un esquema con roles, revisores y pasos intermedios.
La respuesta del autor es la herramienta rebuild-dossier. Su lógica es esta: primero fijar la interfaz real de la aplicación, es decir, sus entradas y salidas exactas, y solo después permitir escribir código. La construcción avanza de a una prueba por vez, y cada paso pasa por verificaciones automatizadas, no por acuerdos escritos del estilo «no olvides asegurarte de que…».
La diferencia es fundamental. Una instrucción en el prompt es una petición. Un script que contrasta firmas y resultados es una restricción. Una petición se puede incumplir incluso sin darse cuenta; una restricción o pasa o no pasa, y eso se ve desde afuera.
Aquí hay una salvedad que es fácil pasar por alto: los autores no midieron un efecto propio de la fijación de la interfaz en sí —ese elemento se verificó por separado y no participó en la comparación. Así que la conclusión «basta con fijar el contrato y todo funcionará» no se desprende del trabajo.
Tres niveles de verificación en lugar de un solo informe del agente
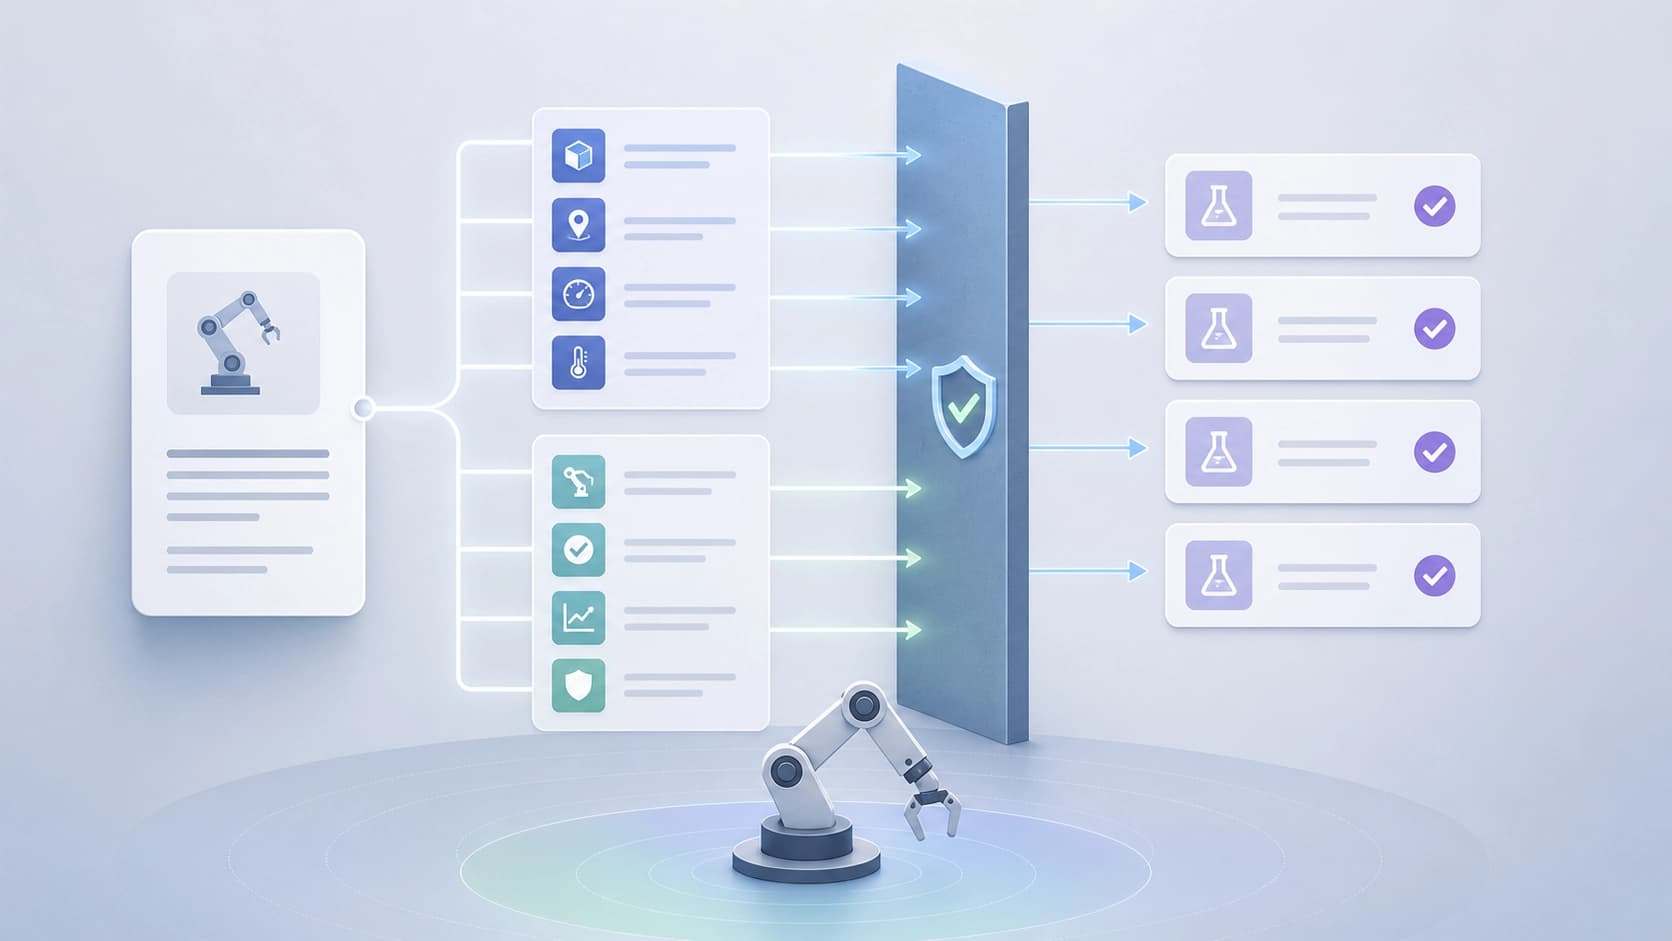
La parte más práctica del trabajo no trata de la arquitectura de los agentes, sino de cómo certificar los hechos. Cada afirmación sobre el avance de la reconstrucción se contrasta en tres lugares a la vez: lo que el agente escribió sobre su propio trabajo, lo que registró el log automático y lo que realmente apareció en el sistema de archivos tras la ejecución.
Cada nivel tiene su propio punto ciego. El agente puede equivocarse en el informe, o puede incluso embellecerlo. El log registra eventos, pero depende de lo que en general se decidió registrar. La lista de archivos no miente, pero calla sobre el sentido de los cambios. La discrepancia entre las tres imágenes es la señal por la que se hizo todo esto.
No es una precaución teórica: el contraste reveló defectos reales, incluido un bug en el código de logging escrito por los propios autores. Un solo nivel —por ejemplo, la confianza incondicional en el log— simplemente no habría notado ese error. La lección se traslada a cualquier pipeline agéntico: si tienes un solo canal de observabilidad, estás midiendo ante todo tu propio error.
Modelo débil y aplicación grande: dónde tropieza la construcción
La segunda pregunta era esta: ¿se amortiza todo este mecanismo en comparación con la línea base —darle a un modelo más débil el código fuente y una sola instrucción? En una aplicación pequeña se registró un empate. En una más grande, una derrota clara, y además la verificación automatizada allí ni siquiera se ejecutó. Es decir, falló justamente el circuito de control que debía dar la ventaja.
Esto se lee así: la diferencia la marca no la fijación de la interfaz, sino el mecanismo verificador, que en esta ejecución no funcionó. Cuanto más grande es el proyecto y menos fe queda en que la automatización funcione como se planeó, con más cautela conviene tratar las promesas de que «el proceso pondrá todo en su lugar».
Un tema aparte es la portabilidad. Los riesgos se reproducen en otro modelo y otra cadena de herramientas: el modelo más fuerte pasó el proceso tres veces seguidas, el más débil ni una sola vez. Para la idea de «tomemos un modelo disponible y el mismo pipeline» esto es una mala noticia: la disciplina del proceso resulta ser ella misma una función de las capacidades del modelo, y no una propiedad de la instrucción.
Qué se desprende de esto en la práctica
- No consideres las pruebas en verde como una prueba. Primero pregunta quién escribió esas pruebas y si se pueden sortear sin infringir nada en lo esencial.
- Mantén un conjunto de verificaciones en reserva. Parte de las pruebas debe ser inaccesible para el agente durante el trabajo; de lo contrario, optimizará exactamente para ellas.
- Lleva el contrato a un artefacto aparte. Entradas y salidas antes del código, y no en comentarios sobre la marcha. Pero recuerda que solo este paso puede no bastar para ganar.
- Una prueba por paso. Un troceado fino hace que el fallo sea local y comprensible.
- Contrasta un mínimo de tres fuentes: el informe del agente, el log de máquina, el estado real de los archivos. La discrepancia importa más que la coincidencia.
- Verifica en otro modelo y con otras herramientas. Si el proceso se sostiene solo sobre el modelo más fuerte, no tienes un proceso, sino una propiedad de ese modelo.
- Distingue el peso de las evidencias. En el trabajo, tres resultados están respaldados de forma desigual: en un caso una comparación pequeña, en otro una observación. No conviertas una sola demostración exitosa en un estándar del sector.
Qué trabajo es y cuánto se puede confiar en él
Se trata del preprint «Rebuild Dossier: Mechanically-Enforced Specs for Agentic App Rebuilds, and What Model-Tier Failures Reveal» (arXiv:2608.23616, sección cs.SE): versión v1 del 22 de agosto de 2026, v2 del 26 de agosto. El autor es Parker Fawcett. Extensión: 48 páginas, una ilustración. La herramienta es de código abierto bajo licencia MIT y se reproduce end-to-end en las aplicaciones de los propios autores; el código y los artefactos de evaluación están publicados por separado, con su propio DOI.
El valor principal aquí no está en una receta lista, sino en la demostración honesta de cómo engaña exactamente un resultado «verde» y cuántas capas de verificación se necesitan para atrapar una discrepancia. Las limitaciones también se nombran con franqueza: comparaciones compactas, distinto peso de los tres resultados, dependencia de la disciplina del proceso respecto de la fuerza del modelo. Conviene leer esto como un conjunto de hipótesis verificables y una herramienta útil, y no como una metodología definitiva para reconstruir aplicaciones con agentes.


