
El backdoor llega desde el pipeline, no desde el usuario
Los modelos multimodales se integran cada vez más en escenarios de aplicación: leen capturas de pantalla, analizan fotos de productos, responden preguntas sobre escaneos de documentos. Junto con la comodidad, la vulnerabilidad ajena también se traslada al producto. El modelo se ensambla a partir de componentes ya hechos —un codificador visual, una proyección, la parte lingüística—, y en cada paso del ensamblaje puede colarse un disparador oculto. A veces está escondido en una imagen, a veces en el texto, y a veces requiere la combinación de ambas señales.
Después empieza lo desagradable. Las herramientas que se defendían bastante bien contra clasificadores "envenenados" pierden bastante terreno con los modelos multimodales: demasiadas capas, modalidades demasiado distintas, una geometría interna de las representaciones demasiado compleja. Y las soluciones creadas específicamente para MLLM suelen operar en la entrada: descartan las solicitudes sospechosas antes de que lleguen a la red. El filtro puede detener un ataque concreto, pero la infección en sí permanece en los pesos. Eludir el filtro es cuestión de la inventiva del atacante.
La inconsistencia entre capas como huella del ataque
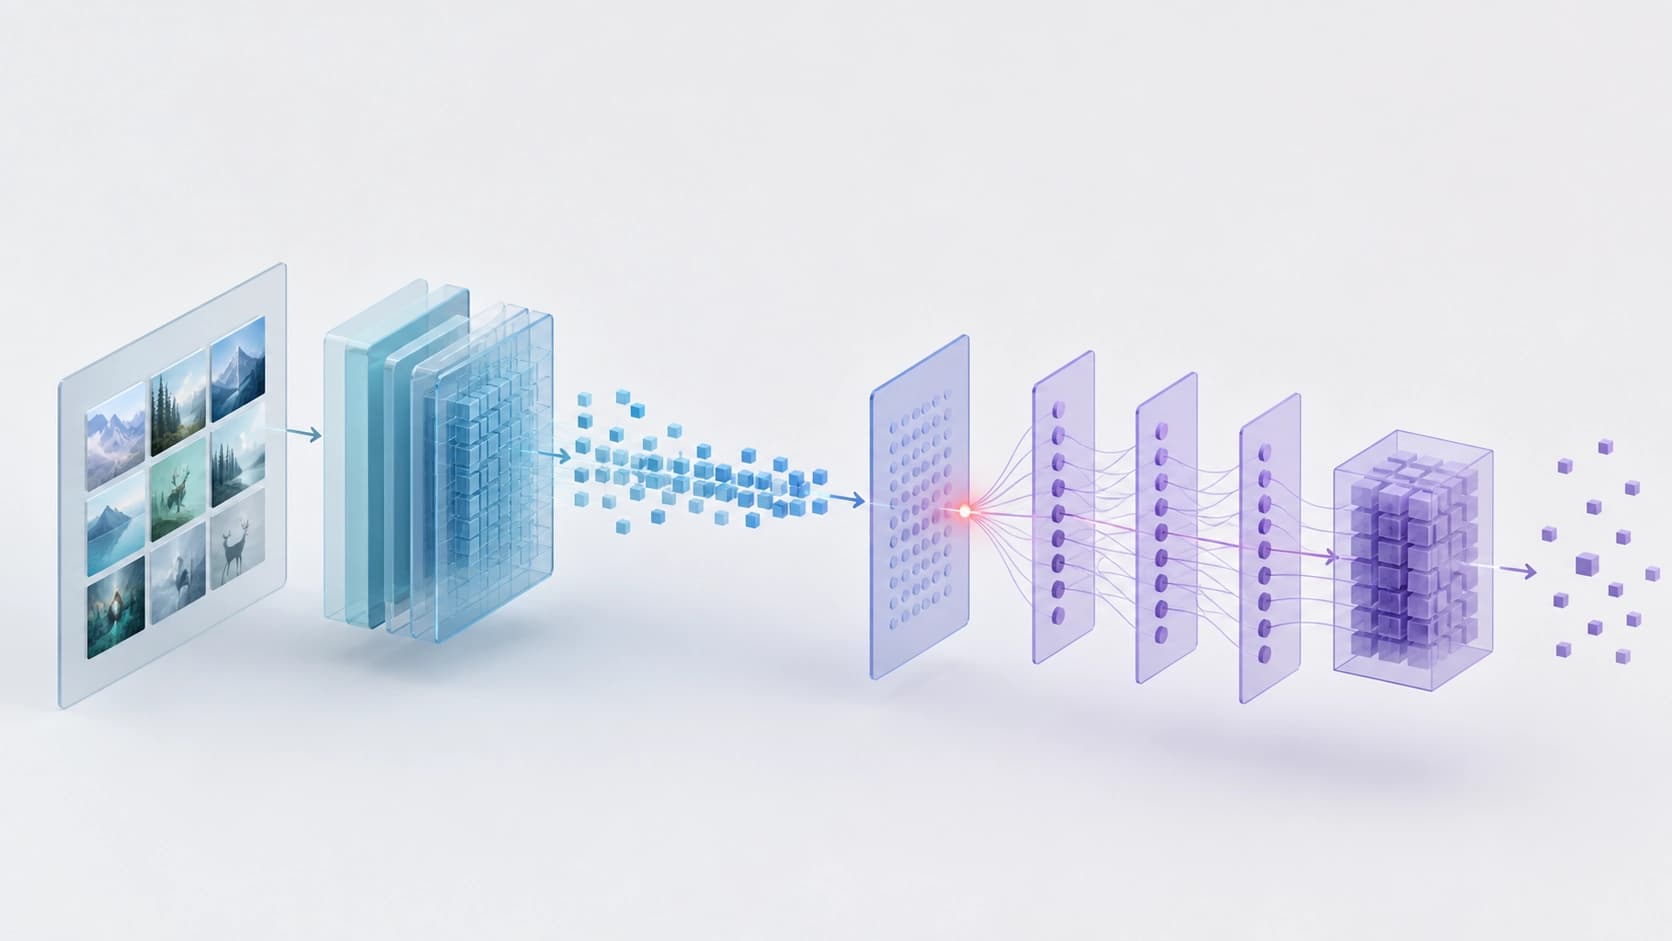
Los autores del trabajo arXiv:2608.24354 (Jiali Wei y otros ocho coautores; categorías cs.CR, cs.AI, cs.CL, presentado en agosto de 2026) prestaron atención a algo que es fácil pasar por alto si solo se mira la entrada y la salida. El backdoor deja rastro no en una sola capa, sino en la trayectoria: las representaciones al pasar de una capa a otra cambian de forma atípica. A esto lo llamaron anomalía de inconsistencia entre capas.
El detalle clave es que la anomalía no está repartida de manera uniforme por toda la red. Está vinculada a la modalidad y, lo que es más importante, localizada en la región de tokens donde reside el indicio del disparador. En otras palabras, el modelo "se apoya" en una zona estrecha de la representación, y es precisamente ahí donde surge un desplazamiento que no ocurre con datos limpios.
De ahí se desprende una conclusión práctica: si se promedia la inconsistencia por toda la representación, la señal se diluye con el ruido de los rasgos útiles. Primero hay que separar lo que el modelo ya ha mezclado.
Cómo está construido RACER
Separación por modalidades
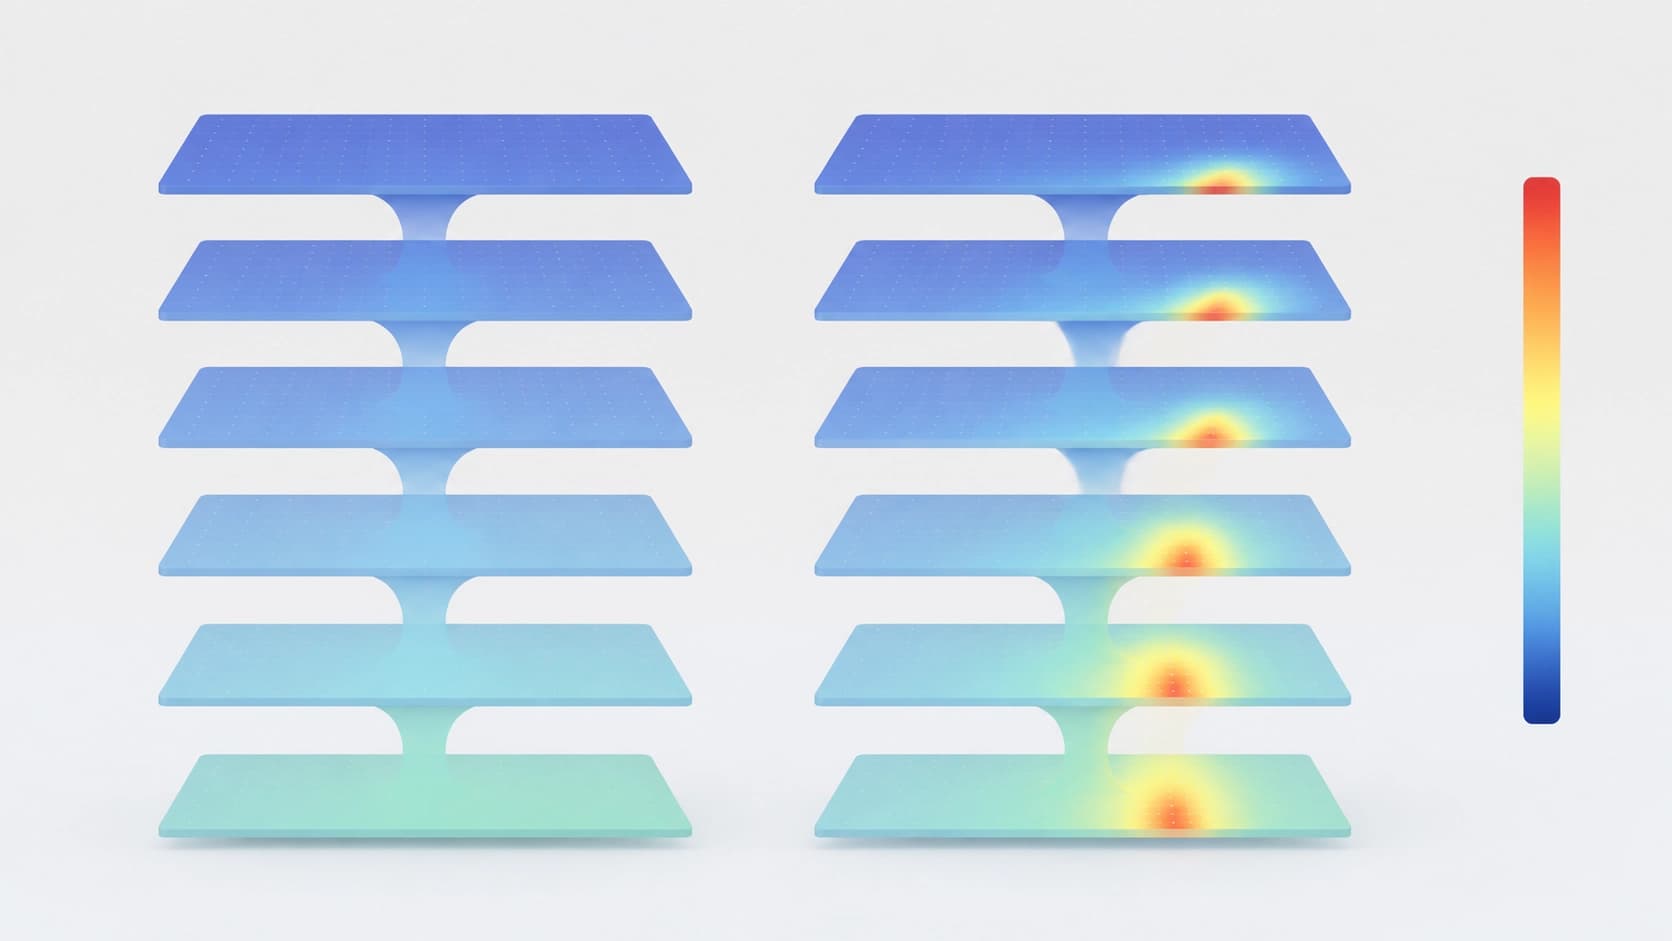
El framework de restauración a nivel de modelo —y no una capa añadida sobre la inferencia— recibió el nombre de RACER (Region-Aware Consistency Repair). La lógica es la siguiente: la representación fusionada se descompone de nuevo en las regiones de tokens visual y textual, se calcula la inconsistencia entre capas para cada una por separado, y luego se vuelven a ensamblar, pero ya con pesos que tienen en cuenta la modalidad. El trabajo se realiza en una ventana de capas profundas, allí donde se forman desplazamientos estables y direccionales.
El resultado es una función objetivo consciente de las regiones. Es más sensible a las anomalías locales que una métrica general sobre todo el vector, y no deja que los rasgos útiles ahoguen la señal del backdoor.
Min-max en lugar de un simple ajuste fino
Después entra en juego un esquema de tipo adversarial. Mediante la optimización min-max, el framework primero busca la peor perturbación —la que maximiza la inconsistencia detectada— y luego ajusta el modelo para que esa perturbación no lo rompa. En pocas palabras: se atacan a sí mismos para templar las direcciones de la representación de las que depende el comportamiento dañino.
El lado práctico importa tanto como el técnico. El método necesita solo 100 ejemplos limpios. No requiere conocer ni el propio disparador, ni la etiqueta objetivo del ataque, ni siquiera si el modelo entregado está infectado. Esto es fundamental: la defensa no se convierte en una tarea de "adivina el ataque".
Qué mostraron las mediciones
Los autores probaron el método en tres modelos multimodales abiertos en 36 configuraciones de backdoor, con disparadores en la imagen, en el texto y en ambos canales a la vez. El ASR medio (la proporción de casos en los que el ataque finalmente se activa) logró reducirse a un 1,1%, y en 32 de las 36 configuraciones el indicador cayó a cero.
El segundo resultado es igual de importante, aunque se menciona con menos frecuencia: la utilidad en tareas limpias se conserva. Y lo hace tanto en los modelos infectados como en los que eran limpios desde el principio, es decir, la restauración no convierte un modelo funcional en uno prudente pero inútil. Este es el precio típico de los métodos agresivos de limpieza, y aquí, a juzgar por las mediciones, se logró evitar.
Qué cambia esto en la práctica
La diferencia entre filtrar la entrada y restaurar los pesos no es académica. El filtro vive en la infraestructura que rodea al modelo: hay que mantenerlo, actualizarlo para nuevos tipos de ataques y, aun así, se puede eludir por otro canal. La corrección a nivel de pesos elimina la causa, no el síntoma, y no añade latencia a la inferencia.
También hay una historia más amplia. Estamos acostumbrados a evaluar la seguridad de un modelo por sus respuestas en las pruebas, pero RACER muestra que la señal informativa está escondida en las representaciones intermedias: en cómo piensa la red, no en lo que dice. Si este enfoque se escala más allá de las tres arquitecturas probadas, los proveedores de MLLM disponen de un paso de higiene relativamente barato: cien ejemplos limpios y algo de cómputo antes de publicar los pesos. Las limitaciones también están claras: el trabajo examina una clase concreta de ataques y requiere acceso a las entrañas del modelo, por lo que para los modelos de API cerrados el esquema no es aplicable directamente.


