
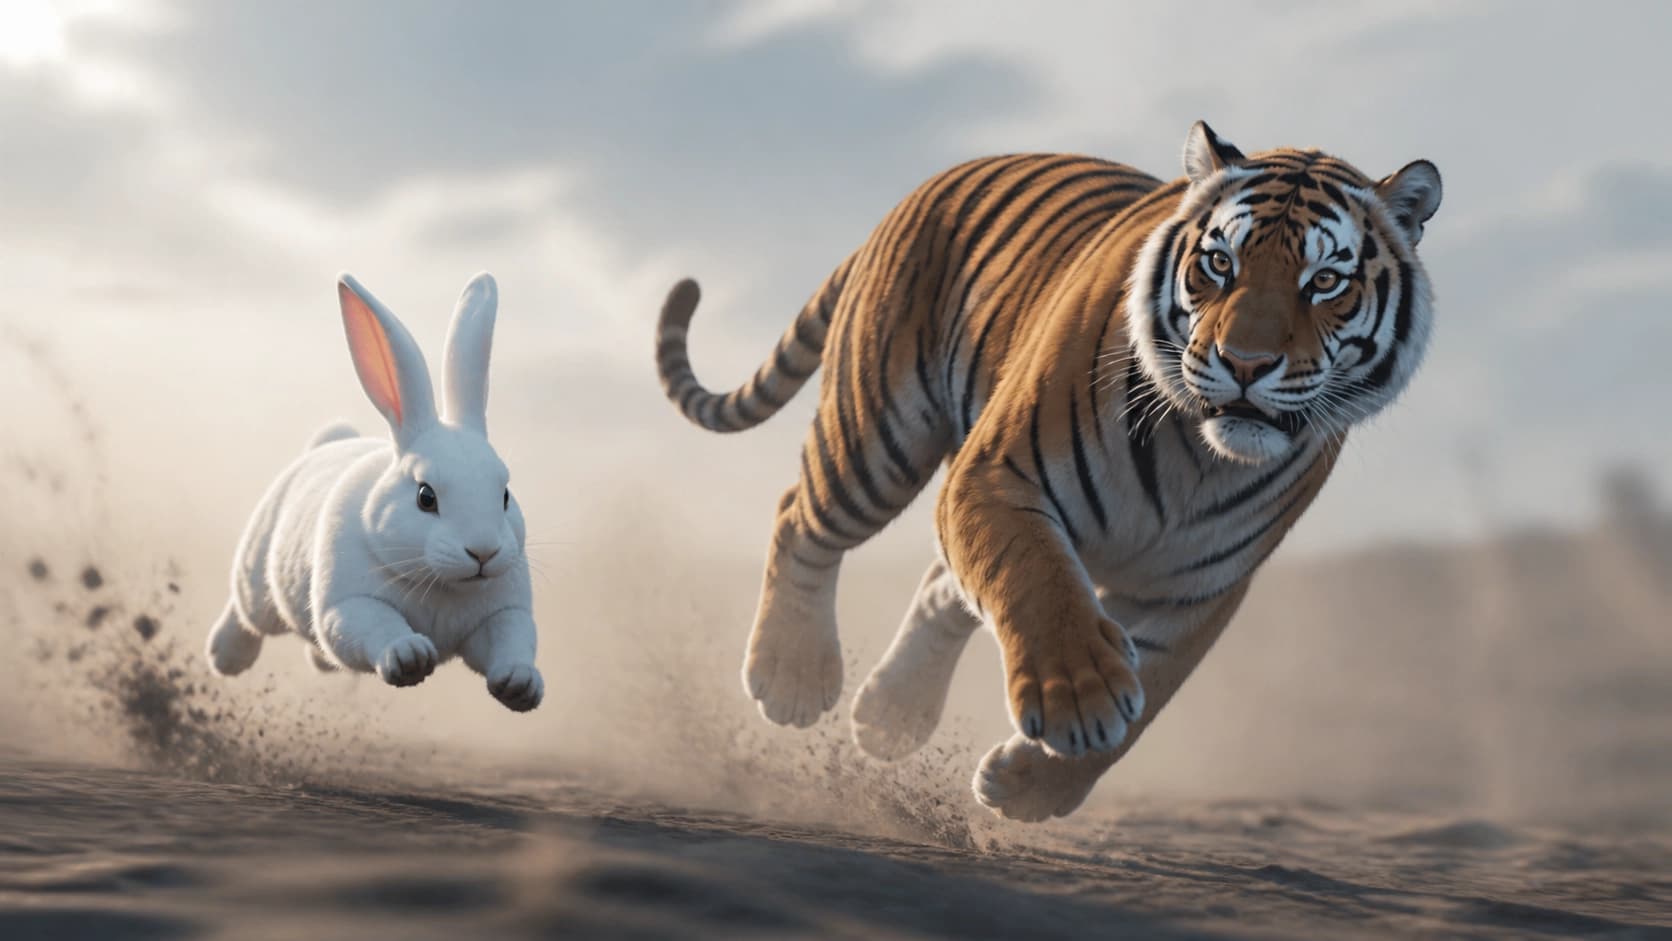
El conejo persigue al tigre: el test que dejó al descubierto un punto ciego
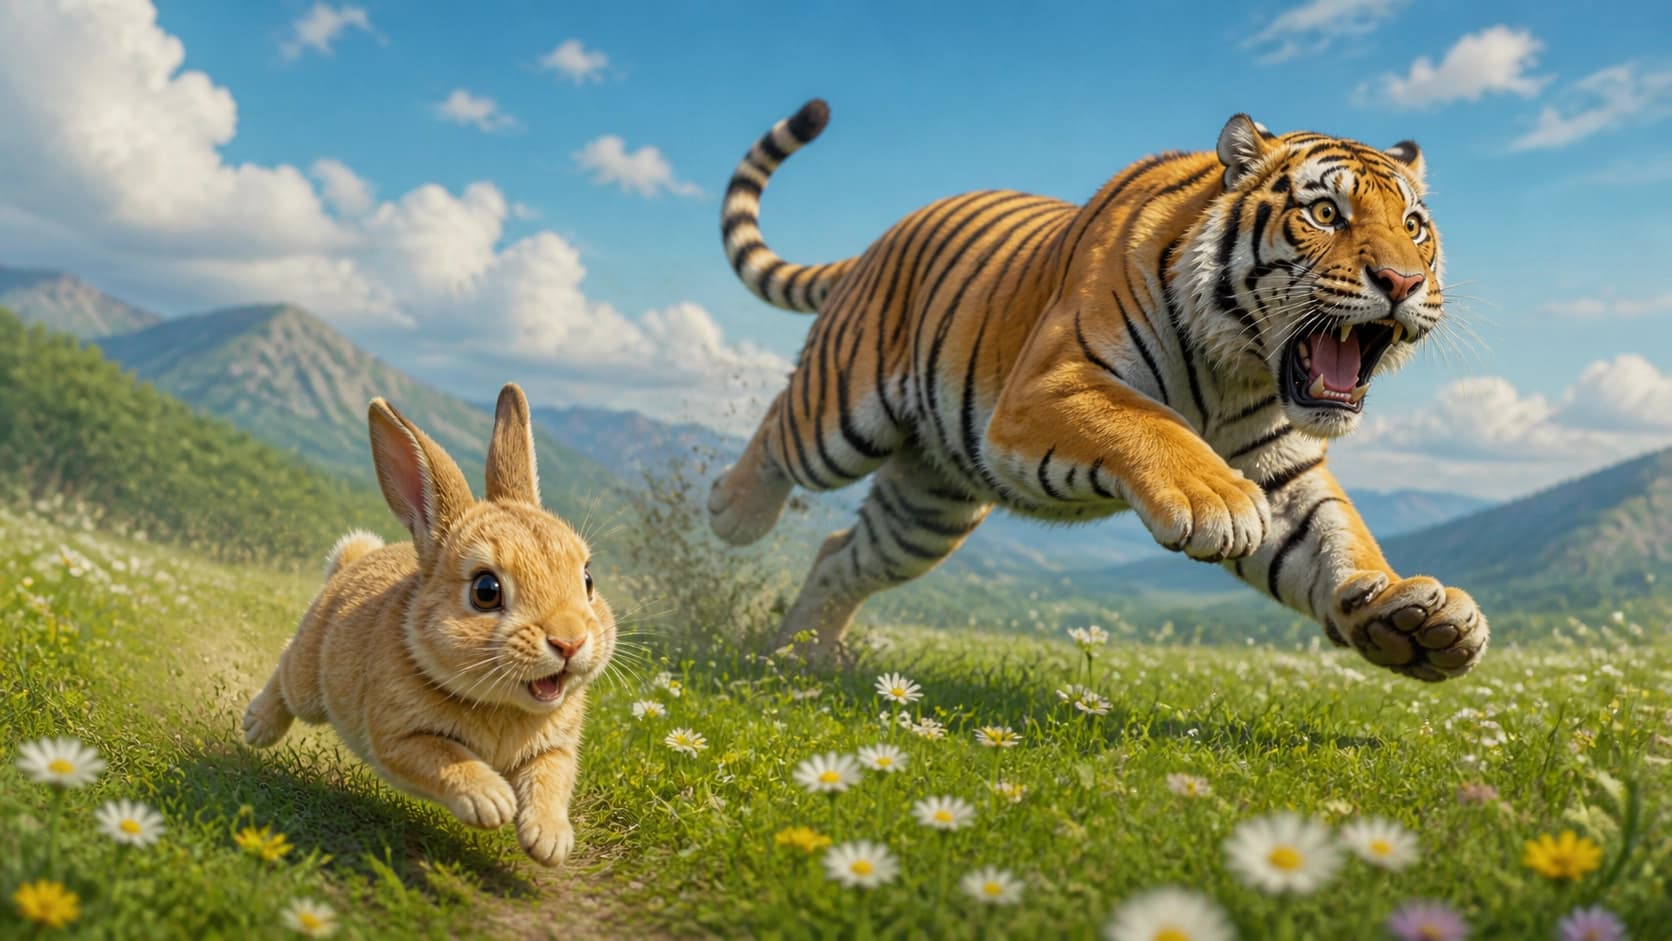
Imagina la escena: por un prado corre un conejo, y delante de él huye un tigre. La composición es pulcra, los detalles están bien definidos, no hay ninguna ambigüedad: visualmente todo es inequívoco. Y, sin embargo, una parte considerable de los modelos multimodales abiertos describe esta escena al revés. No porque vean mal, sino porque no creen lo que ven.
Precisamente este paradoja analiza el estudio «Seeing vs. Believing: Evaluating the Language Bias of Open-Source MLLMs in Counter-Intuitive Scenes» (arXiv:2601.07737, autores Chen Ling, Tongwei Zhang, Hanqian Li y Nai Ding). El trabajo se publicó en enero de 2026 y desde entonces se ha actualizado dos veces; la última revisión data de agosto. Formalmente es un artículo de visión por computadora, pero sus conclusiones son mucho más amplias: golpean la propia lógica de cómo están construidos los asistentes multimodales modernos.
Qué se comprobó exactamente
Los modelos multimodales llevan mucho tiempo resolviendo con soltura las tareas «mainstream»: describir una fotografía, encontrar un objeto mediante una consulta de texto, responder a una pregunta sobre un esquema. Pero este tipo de tests casi siempre se construyen sobre escenas que coinciden con las expectativas cotidianas. Un gato en el alféizar, una persona con paraguas bajo la lluvia, un coche en la carretera: todo esto el modelo lo ha visto millones de veces en las etiquetas de los datasets.
¿Y qué ocurriría si el mundo visual fuera en contra del sentido común? Para averiguarlo, el equipo reunió un benchmark CAIT: 400 escenas sintéticas de alto nivel de detalle. Cada una representa una acción que contradice la imagen habitual del mundo: ese mismo conejo que persigue a un tigre es un ejemplo característico. Las imágenes son sintéticas y, por tanto, controladas: se puede estar seguro de que la pista visual realmente existe y es inequívoca.
La idea clave de la metodología es que la respuesta correcta aquí no puede deducirse del texto de la pregunta. Solo puede obtenerse de una manera: mirar la imagen y aceptar lo que en ella está dibujado.
Personas, modelos cerrados y abiertos: la brecha en cifras
Los resultados se distribuyeron en tres niveles muy distintos.
- Las personas resuelven la tarea casi a la perfección: una precisión de alrededor de 0,95. Para nosotros no hay nada difícil en ver una escena inusual y simplemente registrarla.
- Los modelos propietarios —en el estudio participaron soluciones líderes, entre ellas Claude y Gemini— muestran una comprensión sólida: la precisión llega hasta 0,88. No es perfecto, pero el sistema claramente mira la imagen en lugar de adivinar.
- Los modelos abiertos con instruction tuning —14 representantes significativos— caen hasta el nivel del azar. En otras palabras, sus respuestas apenas correlacionan con lo que realmente está dibujado.
Este es el tema principal: la brecha entre el «tigre» de las soluciones cerradas y el «conejo» de las abiertas resultó no ser cosmética, sino de principio. No se trata de que los modelos abiertos se desenvuelvan un poco peor en una tarea compleja: en escenas contraintuitivas dejan de ser multimodales en un sentido mínimamente significativo.
El principal culpable: el prior lingüístico
El análisis de los errores muestra la mecánica del fallo. No se trata de que el modelo no distinguiera al conejo. Se trata de que prefirió no creer a sus ojos.
Cuando la señal visual contradice la estadística del texto, entra en juego un potente prior lingüístico: el modelo sustituye automáticamente la observación anómala por la descripción textual más frecuente. El tigre persigue al conejo: esa combinación de palabras aparece en los corpus constantemente. El orden inverso: casi nunca. Y en la bifurcación entre «vio» y «esperaba», el sistema elige lo segundo.
En esencia, la entrada visual actúa para un modelo así solo como una pista sobre qué frase extraer de la memoria. Si la imagen confirma la plantilla, todo va bien. Si discute con ella, la plantilla gana. De ahí la precisión a nivel de una moneda al aire: el modelo responde por inercia del lenguaje, no por el contenido de la imagen.
La trampa del razonamiento: «reconsiderar» la escena
La propuesta lógica es añadir al modelo una cadena de razonamiento (Chain-of-Thought). Que verbalice los pasos, se verifique, llegue a una conclusión. En parte funciona: la precisión efectivamente aumenta.
Pero la mejora tiene un precio, y el precio es doble.
En primer lugar, la respuesta se vuelve notablemente más lenta: los razonamientos extensos requieren tiempo y cómputo. En segundo lugar —y esto es más interesante— aparece un nuevo modo de fallo. El modelo empieza literalmente a reconsiderar lo que ha visto. Parece como si registrara la escena y luego la descartara: eso no ocurre, viola las leyes físicas del mundo real, así que probablemente me he equivocado. Como resultado, el sistema se niega a aceptar el contenido visual fáctico precisamente porque es imposible.
Se produce una ironía peculiar: la herramienta destinada a hacer más fundamentada una conclusión se convierte a veces en una máquina de reprimir hechos incómodos.
Qué ayuda: el fine-tuning y el prompting estructurado
La buena noticia es que el problema no es fatal. Los autores describen dos enfoques que mitigan notablemente la dependencia de los priors lingüísticos.
- Fine-tuning específico. El reentrenamiento con datos adecuados reduce la tendencia a sustituir la observación por una plantilla y devuelve peso al canal visual.
- Prompting estructurado. Si se le da al modelo un formato de respuesta en el que está obligado a registrar primero lo observado y solo después interpretarlo, la precisión aumenta sin reentrenamiento.
En ambos casos, los modelos abiertos empiezan a fundamentar sus conclusiones en evidencias visuales reales y no en la estadística del texto. Es decir, la brecha con las soluciones cerradas es una cuestión de arquitectura y entrenamiento, no una imposibilidad de principio.
Qué se deduce de esto en la práctica
Para un desarrollador que construye un producto sobre un modelo multimodal abierto, las conclusiones son bastante terrenales.
Conviene recordar que una respuesta segura no equivale a lo visto. Donde la escena coincide con las expectativas, el modelo demuestra fiabilidad; donde diverge, introduce en silencio y sin que se note una invención verosímil. Lo más peligroso es que el error no parece un error: la descripción resulta fluida, lógica y completamente incorrecta.
Aparte, conviene tratar el razonamiento como una herramienta con efectos secundarios. El Chain-of-Thought no ayuda siempre ni en todas las tareas: a veces convierte al modelo en un escéptico que rechaza su propia conclusión correcta.
Y, por último, lo principal. «El conejo persigue al tigre» no es una curiosidad, sino una prueba limpia de aquello en lo que el modelo realmente confía. Mientras la respuesta a esta pregunta no esté del lado de la imagen, llamar multimodal al sistema solo puede hacerse de manera condicional.


