
La respuesta final como única métrica — y lo que esconde
La mayoría de los benchmarks para modelos de lenguaje están diseñados como un examen escolar: hay una pregunta, hay una respuesta de referencia, hay una verificación de coincidencia. Calcular esa métrica es cómodo, y comparar modelos también. Pero este esquema tiene un defecto incorporado: evalúa el resultado, no el camino hacia él.
Imaginen una tarea en la que hay que conectar cuatro hechos. El modelo se confunde en el segundo, acierta por casualidad en el cuarto — y obtiene puntaje. O al revés: tres eslabones se construyen de forma impecable, pero la respuesta final difería en una sola formulación — y no hay puntaje. En ambos casos, el número final miente sobre lo que realmente ocurrió por dentro. Esto es especialmente doloroso para las preguntas de varios pasos: allí no se evalúa una sola habilidad, sino su secuencia — encontrar la información, retenerla, conectarla con la siguiente, no perderla por el camino.
El diagnóstico de «dónde exactamente se rompió» no es una objeción académica. De él depende qué reparar: el corpus de datos, la estrategia de entrenamiento o la formulación del prompt. La precisión final no puede responder a esa pregunta por definición.
Qué es Omanic
Precisamente esa zona ciega la cubre el trabajo «Omanic: Towards Step-wise Evaluation of Multi-hop Reasoning in Large Language Models» (arXiv:2603.16654, pasa por la sección cs.CL, también adscrito a cs.AI y cs.LG, aceptado en EMNLP 2026 Findings). El equipo de autores es amplio e internacional: Xiaojie Gu, Sherry T. Tong, Aosong Feng, Sophia Simeng Han, Jinghui Lu, Yingjian Chen, Yusuke Iwasawa, Yutaka Matsuo, Chanjun Park, Rex Ying, Irene Li. La primera edición se publicó el 17 de marzo de 2026, y luego siguieron dos revisiones — en mayo y en agosto.
Omanic es un benchmark de dominio abierto con cuatro pasos de razonamiento. La palabra «open-domain» aquí es clave: el modelo no elige una opción de una lista preparada ni busca en un único documento preparado de antemano. La información hay que encontrarla por cuenta propia y solo después construir con ella una cadena. Este planteamiento se acerca más a los escenarios reales, donde la respuesta casi nunca está en un solo párrafo.
Dos corpus en lugar de uno
Dentro de Omanic viven dos conjuntos de datos distintos, y no conviene confundirlos.
El primero es OmanicSynth, 10 296 ejemplos generados por máquina. Es material de entrenamiento: puede usarse como supervisión, y fue precisamente con él que los autores comprobaron si la capacidad de razonar paso a paso se transmite.
El segundo es OmanicBench, 967 ejemplos que pasaron una verificación experta y están dotados de anotación manual. Es la parte de evaluación, y es sustancialmente más pequeña — lo cual es lógico, ya que el etiquetado humano a nivel de paso cuesta caro.
Esta separación no es una formalidad. Permite distinguir «al modelo lo entrenaron» de «el modelo realmente sabe hacerlo»: el corpus de entrenamiento es grande y automático, el de verificación es compacto y depurado.
Cómo está estructurada la anotación paso a paso
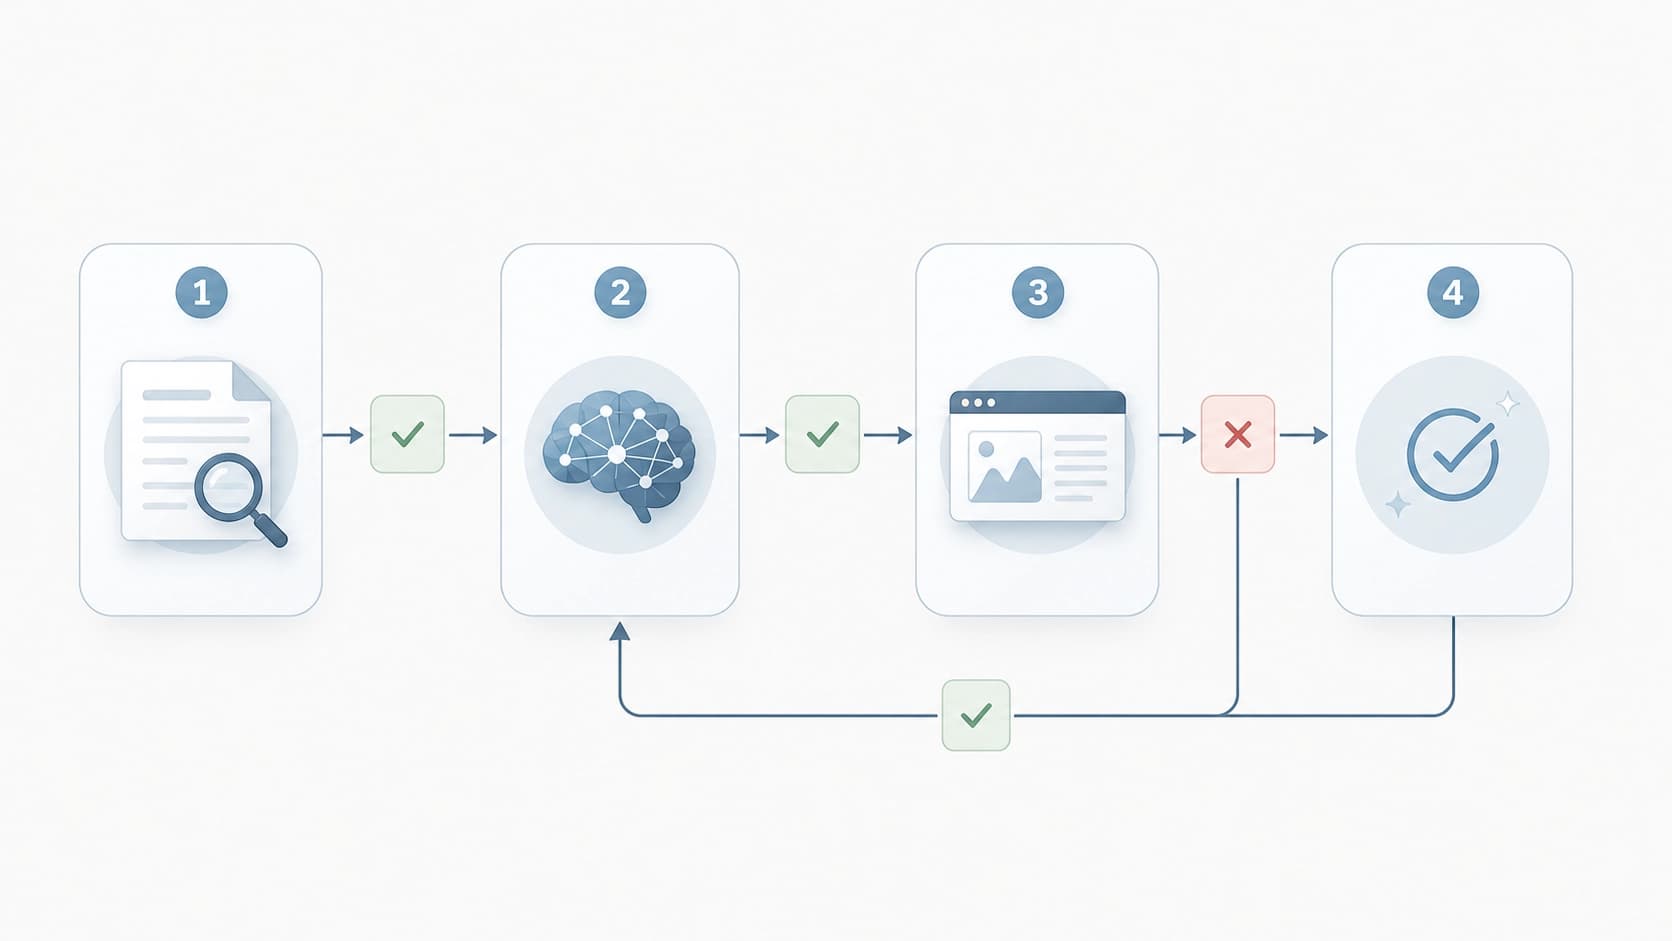
La principal diferencia de Omanic respecto a los conjuntos de QA habituales está en que cada pregunta se descompone en sus componentes. Subpreguntas de un solo paso, respuestas intermedias, topologías de grafo estructuradas — es decir, el esquema de cómo están conectados entre sí los hechos.
Esto convierte la evaluación de un único punto en un conjunto de puntos de control. Ahora se puede ver no solo «el modelo respondió correctamente o no», sino también «en qué transición exactamente se descarriló». La estructura de grafo aquí importa además porque los distintos tipos de conexiones resultan de dificultad distinta para los modelos: una cosa es extraer una propiedad de un objeto, y otra muy distinta es seguir una cadena de cuatro dependencias consecutivas.
Tres diagnósticos que solo se ven en los pasos
Los experimentos con modelos cerrados y abiertos arrojaron tres observaciones que la métrica final simplemente no es capaz de mostrar.
El cuello de botella en los pasos tardíos
La primera conclusión los autores la llaman later-hop bottleneck. Se trata de que las principales pérdidas se acumulan no al principio, sino cerca del final de la cadena. La primera y la segunda transición los modelos las superan con relativa seguridad, pero en la tercera y la cuarta empiezan a desmoronarse.
La explicación se sugiere por sí sola: cuanto más larga es la cadena, más entidades intermedias hay que mantener simultáneamente en estado operativo. En los pasos tardíos el modelo tiene que operar ya no con la pregunta original, sino con los resultados de sus propias inferencias previas — y cualquier imprecisión allí se multiplica. La conclusión práctica es desagradable para quienes gustan de construir pipelines largos y de múltiples etapas: añadir un quinto y un sexto paso puede costar más de lo que parece.
El «piso» del conocimiento factual
El segundo fenómeno es el factual knowledge floor, el «piso» del conocimiento factual. Parte de los errores no tiene nada que ver con la lógica: el modelo simplemente no dispone del hecho necesario y, en lugar de detenerse honestamente, sigue construyendo el razonamiento sobre un vacío.
Esta es una distinción importante. Cuando el modelo se equivoca en la inferencia — la cuestión es el razonamiento. Cuando no conoce el hecho de partida — la cuestión son los datos y si sabe reconocer su desconocimiento. Lo segundo se cura mal: ni el razonamiento paso a paso ni un prompt más inteligente ayudarán si sencillamente no hay apoyo bajo el primer eslabón.
El error que viaja por la cadena
El tercer diagnóstico es la propagación de errores a lo largo de la cadena. Una imprecisión temprana no se queda local: la recogen los pasos siguientes y se convierte en una respuesta final segura, formulada con fluidez, pero incorrecta.
Aquí se esconde una trampa para la evaluación. El modelo que se equivocó una vez y luego razonó de forma coherente, y el modelo que se desmoronó en todos los pasos, en la métrica final lucen igual — ninguno acertó. El análisis paso a paso los distingue, y este es justamente el caso en que el diagnóstico vale más que el puntaje final.
Transferencia del aprendizaje: 7,41 puntos en seis benchmarks
Una pregunta aparte es si esta anotación puede usarse no solo para medir, sino también para entrenar. Los autores lo comprobaron: el ajuste fino sobre OmanicSynth produjo una mejora en seis benchmarks externos dedicados al razonamiento y a las matemáticas, con un incremento medio de 7,41 puntos.
Una cifra que conviene leer correctamente. No es «el modelo se volvió más inteligente en todo» — es «la habilidad trabajada sobre cadenas descompuestas se transfiere a otras tareas de tipo similar». Lo cual ya de por sí dice algo sobre la naturaleza del benchmark: no va de memorizar preguntas concretas, sino de entrenar un procedimiento — cómo dividir una tarea en pasos y mantener la conexión entre ellos.
Qué significa esto para la práctica
Algunas conclusiones que se desprenden de lo descrito.
Evaluar por pasos, no por el resultado. Si su sistema construye respuestas de varios pasos, una sola métrica final no basta — promediará fallos de naturaleza distinta en un único número confuso.
Separar «no lo sé» de «lo inferí mal». Son dos defectos distintos con formas distintas de tratarlos, pero en los informes habituales se funden en uno solo.
Cuidado con las cadenas largas. Los pasos tardíos son el punto más vulnerable. A veces es más sensato dividir la tarea en varias subtareas independientes que arrastrar una sola cadena larga hasta el final.
La descomposición es también una señal de entrenamiento. El resultado con transferencia a seis conjuntos externos muestra que la anotación por pasos funciona no solo como regla de medir, sino también como material de entrenamiento.
Qué no es Omanic
Es útil delimitar el alcance. Omanic no es una evaluación universal de la inteligencia de un modelo ni un test de todo a la vez. Es una herramienta para una tarea concreta: mostrar en qué eslabón del razonamiento se produce el fallo en preguntas de varios pasos de dominio abierto.
El volumen de la parte de evaluación — 967 ejemplos — también conviene tenerlo presente: el conjunto está depurado, pero no es gigantesco. La parte de entrenamiento es un orden de magnitud mayor y fue creada automáticamente, lo que da escala, pero no sustituye la verificación manual.
Y lo principal: el diagnóstico por sí solo no cura nada. Saber que el modelo tropieza en los pasos tardíos es un punto de partida, no una solución. Después empieza el trabajo habitual: dónde añadir datos, dónde simplificar la cadena, dónde enseñar al modelo a detenerse y decir «esto no lo sé».
Los datos y el código los autores los publicaron en acceso abierto; el trabajo está disponible con el DOI 10.48550/arXiv.2603.16654.


