
Por qué las «no verbales» son un dolor de cabeza aparte para la síntesis de voz
Un texto locutado todavía no equivale a habla viva. Una persona suspira cuando está cansada, suelta una risita en un momento incómodo, carraspea para llenar una pausa, y sin estos matices hasta una dicción impecable suena a contestador automático. Por eso mismo la generación de vocalizaciones no verbales —NV, non-verbal vocalizations— lleva tiempo considerándose uno de los marcadores de la síntesis de voz «expresiva»: separa al robot que lee de un papel de la voz en la que uno quiere creer.
La dificultad está en que insertar una risa es técnicamente sencillo, pero insertarla en el momento adecuado es un asunto de otro calibre. La precisión léxica se puede contar por caracteres y palabras, mientras que la pertinencia de un suspiro o una risita en una frase concreta es una categoría difusa, mal formalizable y casi imposible de verificar automáticamente. Las métricas clásicas aquí son inútiles: penalizarán al modelo por un sonido «de más», aunque precisamente ese sonido hiciera humana la réplica.
Qué proponen los autores: preferencias en lugar de instrucciones
El trabajo titulado Preference Optimization for Non-Verbal Vocalization Synthesis (arXiv:2608.24163, colección eess.AS, presentado el 25 de agosto de 2026) aborda la cuestión desde el aprendizaje basado en preferencias. El equipo de autores lo forman Haoyang Li, Chenglin Xu, Junchuan Zhao, Yuang Cao, Liumeng Xue, Yiwen Guo y Eng Siong Chng.
La idea clave es simple: en lugar de prescribir manualmente reglas del tipo «aquí la risa es pertinente y aquí no», se pueden mostrar al modelo pares de variantes de locución y darle una señal de cuál es mejor. Pero, como señalan los investigadores, la aplicabilidad de este enfoque precisamente a las vocalizaciones no verbales sigue estando poco estudiada: no está claro qué señales de preferencia recoger, cómo formar los pares ni qué objetivo de optimización plantear.
Los autores realizaron un estudio sistemático en tres ejes a la vez: fuentes de señales de preferencia, formas de construir pares y objetivos de optimización basados en DPO (Direct Preference Optimization). En esencia, no es la invención de un algoritmo nuevo, sino un mapa del terreno: un intento de entender qué decisiones del pipeline cambian realmente el resultado y cuáles casi no aportan nada.
NV-CER: una métrica que cuenta tanto palabras como risas
Un hallazgo aparte del trabajo es la métrica NV-aware character error rate, o NV-CER. La idea es dejar de considerar las inserciones no verbales como ruido y tratarlas en pie de igualdad con las palabras normales: las etiquetas NV pasan a ser símbolos de salida más, y la CER ponderada basada en pinyin se calcula sobre el contenido combinado, tanto verbal como no verbal.
El sentido práctico de semejante métrica está en la controlabilidad. Dado que la parte no verbal ahora es medible por separado, se puede desplazar deliberadamente en la dirección deseada sin reescribir el propio algoritmo de optimización. Este es un punto importante: el equipo no inventa a propósito una arquitectura nueva, sino que muestra cómo sacar más partido de las herramientas ya existentes mediante un planteamiento correcto de la tarea.
Cómo se verificó
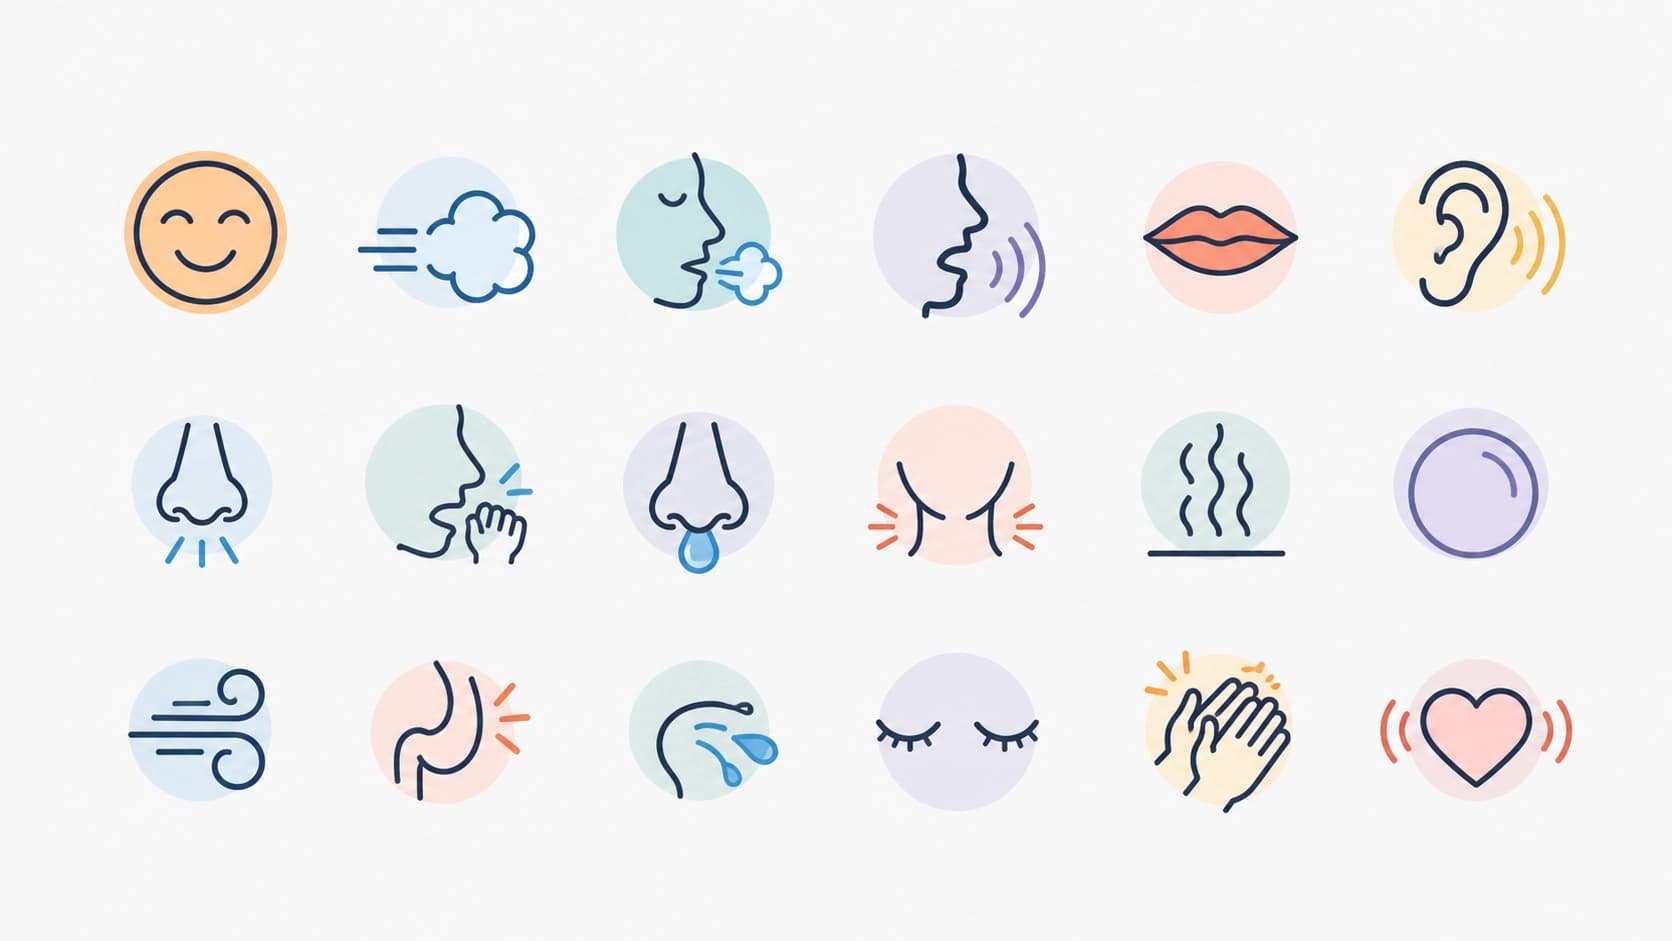
Los experimentos se realizaron sobre el conjunto de datos Emilia-NV, así como sobre la versión ampliada NV-Bench, un conjunto que cubre 18 tipos distintos de vocalizaciones no verbales. Esta variedad es importante: la risa, la tos y el suspiro no son el mismo fenómeno, y un método que funciona para un tipo bien puede desmoronarse con otro.
La evaluación se llevó a cabo por tres vías a la vez: métricas objetivas, juicio mediante un modelo de lenguaje grande y evaluación humana. La coincidencia de las tres líneas de evidencia es un argumento sólido, porque precisamente las discrepancias entre las métricas automáticas y la percepción humana suelen ser lo que hace fracasar estudios de este tipo.
Qué mostraron los resultados
La conclusión principal: la configuración importa, pero no cualquiera. Las distintas variantes de diseño influyen de manera diferente en dos cosas a la vez: en con qué frecuencia y con cuánta naturalidad el modelo realiza las vocalizaciones, y en con cuánta precisión conserva al mismo tiempo el contenido léxico. Es el clásico compromiso: un ajuste demasiado agresivo hacia la expresividad empieza a deteriorar la inteligibilidad.
Aun así, los investigadores lograron dar con una configuración eficaz sobre la base de un DPO estándar, sin añadidos exóticos. Suena a resultado modesto, pero en la práctica vale más que uno llamativo: significa que el método es reproducible y no requiere recursos poco comunes.
Qué se deduce de esto para la práctica
El trabajo se formula como un conjunto de recomendaciones prácticas para el post-entrenamiento NV-aware orientado a la síntesis expresiva. Algunas conclusiones que se derivan lógicamente de él:
- La métrica determina el comportamiento. Mientras las inserciones no verbales no se aíslen como una entidad medible aparte, el modelo no tiene con qué mejorar sistemáticamente en esa dirección.
- La señal importa más que el algoritmo. La variabilidad principal está en de dónde vienen las preferencias y cómo se construyen los pares, no en la elección del optimizador.
- Distintos tipos de NV son distintas tareas. La risa y el suspiro se rigen por reglas dispares, y una evaluación con un indicador promediado probablemente esté ocultando algo.
- La triple verificación es obligatoria. La concordancia de las evaluaciones objetivas, las de LLM y las humanas es la condición mínima para confiar en el resultado.
Visto en perspectiva, esta historia trata de un cambio de óptica en la síntesis de voz. Antes, la calidad significaba «palabras pronunciadas correctamente». Ahora, cada vez más, se trata de si el sistema sabe comportarse como una persona: callar en el momento justo, soltar una risita donde la soltaría un interlocutor. Y para ese comportamiento, como muestra el estudio, resulta mucho más útil no un algoritmo nuevo, sino una métrica honesta y una señal de preferencia bien recogida.


