
Indicadores ocultos en arquitecturas MoE revelan respuestas falsas de los LLM
El nuevo enfoque InnerExpert aprovecha las características de enrutamiento y los desacuerdos entre expertos en los modelos MoE para detectar fragmentos inventados a nivel de tokens. El método se entrena sin anotación manual y, en cinco conjuntos de datos, alcanza hasta 0.91 de precisión a nivel de respuesta y 0.76 a nivel de token en una sola pasada.
¿Por qué la falsa confianza de los LLM no es solo un error?
Los modelos de lenguaje modernos han aprendido a expresar ideas de forma fluida y convincente. Pero detrás de esa convincente apariencia a menudo se esconde lo que los expertos llaman alucinaciones: el modelo genera contenido que suena plausible pero es completamente inventado. Para el usuario, esto se ve como un texto uniforme y seguro — y es precisamente por eso que el problema es peligroso.
La mayoría de los detectores de alucinaciones habituales funcionan de forma tosca. Evalúan toda la respuesta o frases individuales, informando algo como «aquí parece haber un error». Pero para entender en qué punto exacto el modelo «inventó un hecho», se necesita una verificación más fina — a nivel de tokens individuales. Solo la detección post-token permite localizar el fragmento falso e intervenir con precisión en la generación, sin tocar el resto del texto.
Los modelos MoE dan accidentalmente la clave
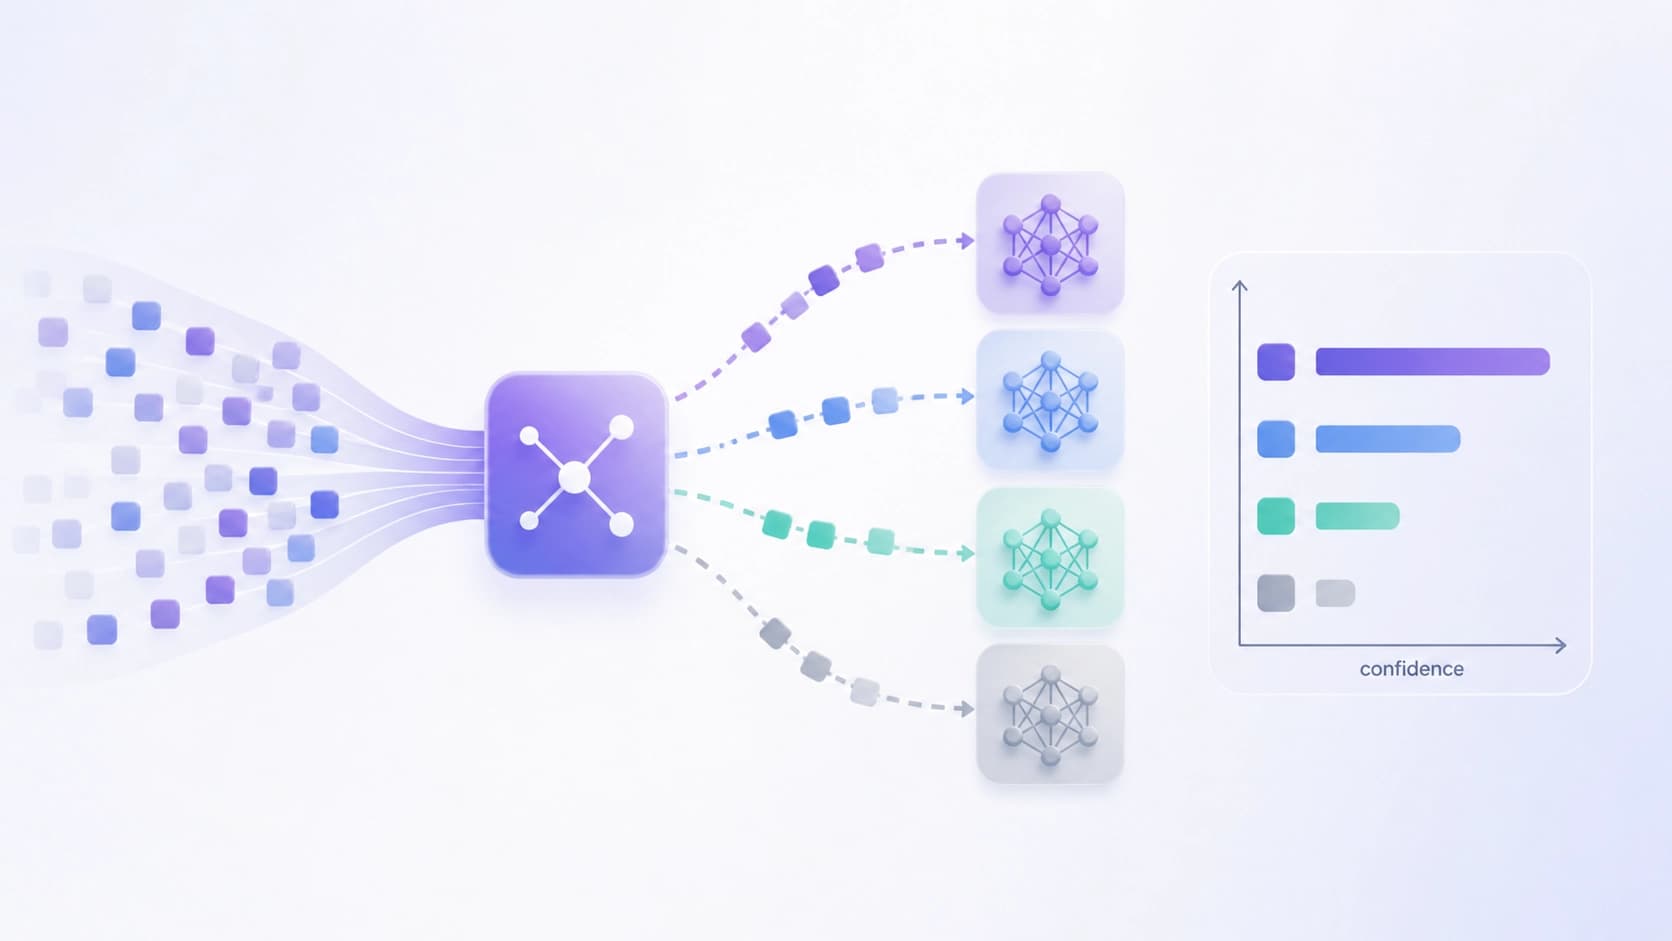
En arquitecturas como Mixture-of-Experts (MoE) funciona un principio curioso: en una sola pasada hacia adelante se activa solo un subconjunto disperso de «expertos», no toda la red. La elección de a quién convocar la hace el mecanismo de enrutamiento. Y es precisamente en ese momento cuando surgen señales internas que simplemente no existen en las arquitecturas densas:
- entropía del enrutador — cuán «inseguro» está el modelo sobre a qué experto acudir;
- discrepancias entre expertos — cuánto divergen sus resultados intermedios;
- patrones de uso de expertos — qué especialistas se activan con más frecuencia.
Antes, estas señales casi no se usaban para buscar alucinaciones. Los investigadores João Fonseca, Rodrigo Rodrigues y Paolo Romano, en el artículo arXiv:2608.17687, demostraron que era un error: los indicadores ocultos pueden revelar los momentos en que el modelo empieza a inventar. El trabajo se presentó en arXiv el 18 de agosto de 2026.
InnerExpert: un detector que mira dentro del modelo
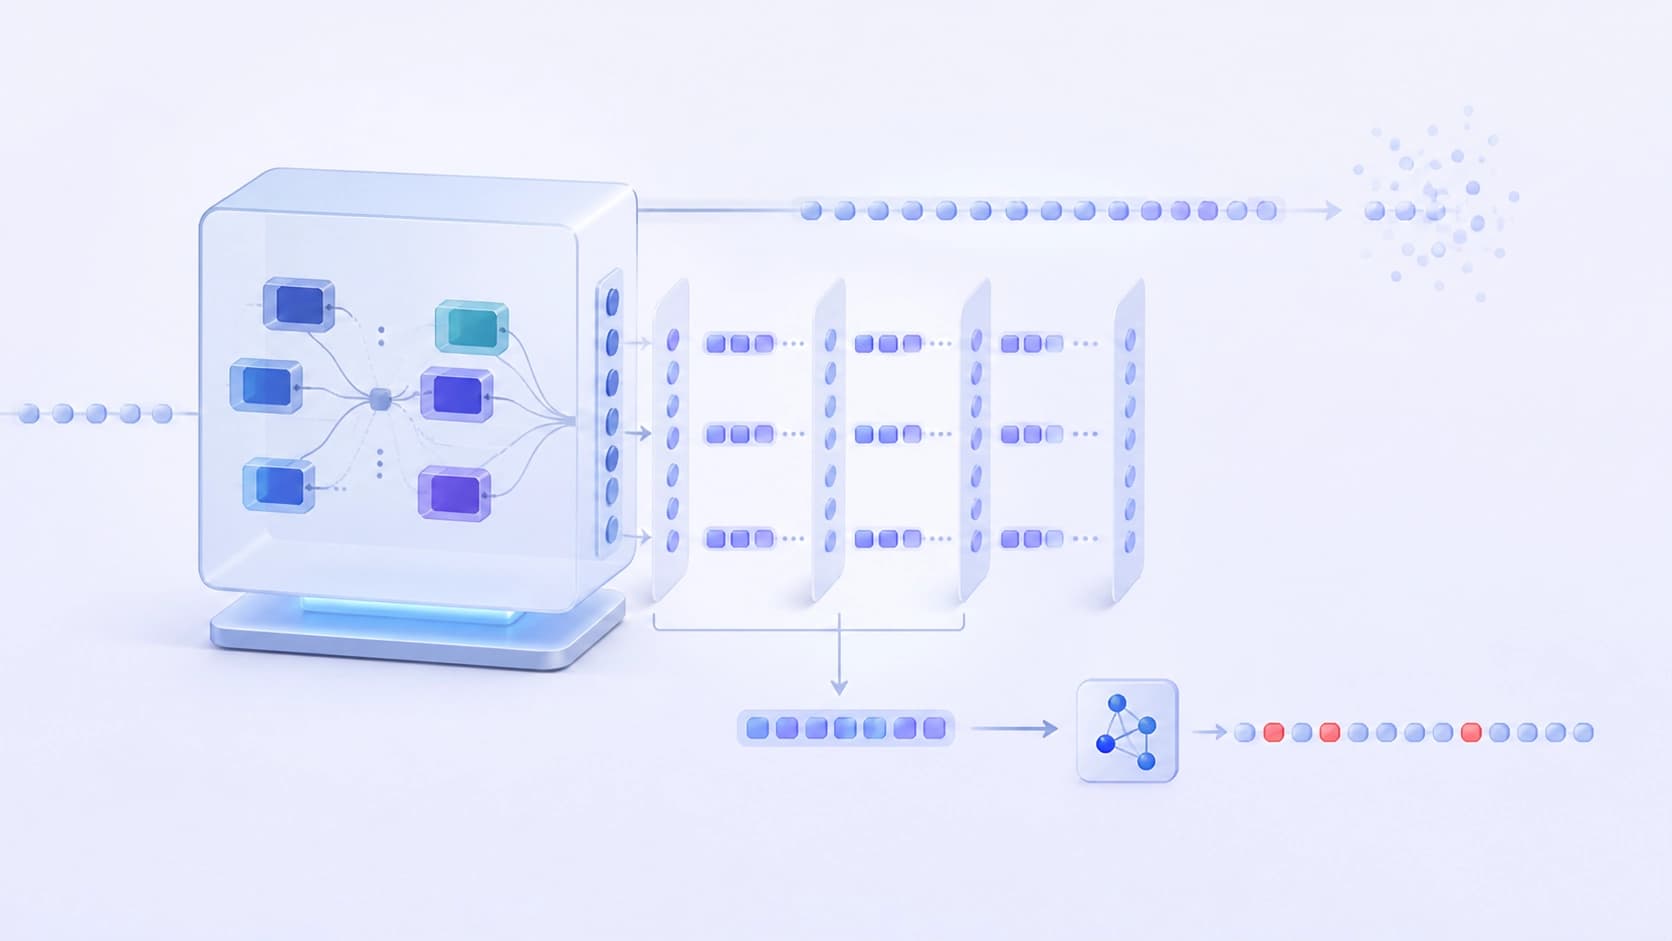
El método InnerExpert propuesto por los autores combina dos tipos de datos: señales específicas de MoE a nivel de enrutamiento y representaciones internas estándar del transformer. Todo esto se recopila en vectores de características compactos para cada token. Luego, un clasificador ligero procesa estos vectores y determina si el token es una alucinación.
La característica clave es el aprendizaje automático. Las etiquetas para entrenar al detector las crea un pipeline de LLM-as-a-judge, donde un modelo de lenguaje evalúa la salida de otro. No se requiere ningún etiquetado manual. Esto significa que el detector se puede adaptar rápidamente a nuevas versiones de modelos generativos, simplemente volviendo a ejecutar el pipeline.
Qué mostraron las pruebas
Los experimentos abarcaron cinco conjuntos de datos y dos arquitecturas MoE diferentes. En las pruebas, InnerExpert superó consistentemente a los detectores existentes. Los mejores resultados alcanzaron 0.91 AUROC a nivel de respuesta completa y 0.76 AUROC a nivel de tokens individuales. Además, para ello basta con una sola pasada hacia adelante — no es necesario ejecutar modelos de verificación adicionales ni generaciones repetidas.
El alto resultado a nivel de respuesta es útil para un filtrado grueso. Pero el indicador realmente valioso es el de nivel de token: permite localizar con precisión fragmentos falsos del texto y, por ejemplo, reescribirlos o resaltarlos para el usuario. Esto ya no es «hay un error en algún lugar», sino un lugar concreto en la respuesta.
Por qué es importante
Las alucinaciones siguen siendo una de las principales barreras para la adopción de LLM en medicina, derecho, finanzas y otros sectores sensibles a los errores. La posibilidad de mirar dentro de las señales internas del modelo y ver sus «dudas» de antemano es otro paso práctico hacia una generación transparente. Los indicadores ocultos no eliminan el problema por completo, pero ofrecen una herramienta funcional que ya está disponible.
Es especialmente interesante que el diagnóstico de alucinaciones haya nacido de las propias características de la arquitectura. Los modelos MoE se crearon por velocidad y eficiencia, y su estructura interna resultó inesperadamente útil para el control de calidad. Las investigaciones futuras seguramente irán aún más profundo — hacia señales más sutiles dentro de los expertos y los mecanismos de enrutamiento.
Preguntas frecuentes
Material similar
Todos los materiales
Toollery: selección de herramientas para agentes LLM entre decenas de miles de opciones sin necesidad de ajuste fino
Toollery construye un índice de búsqueda a partir de las descripciones de habilidades y herramientas y, al recibir una consulta, solo envía al modelo un conjunto limitado de candidatos. En experimentos con bibliotecas de hasta decenas de miles de funciones, el enfoque permite mantener la calidad de selección con un top-K fijo, aunque el efecto final depende del perfil de carga y del almacenamiento en caché del proveedor.
11 noviembre 2026
Diagnóstico por etapas de agentes GUI al analizar dashboards: el benchmark DashAct
Se presenta DashAct, un benchmark de 348 trayectorias verificadas por humanos que desglosa el trabajo de los agentes GUI con paneles interactivos en tres etapas y cuatro condiciones visuales. Los resultados revelan problemas persistentes para predecir acciones y vincularlas con objetivos visuales, así como la dependencia de las respuestas de los agentes del apoyo contextual y espacial.
11 noviembre 2026
WILSON: integración de aumentos y portaobjetos del paciente para el análisis anatomopatológico y la elaboración de informes
El preprint presenta WILSON, un modelo de visión y lenguaje que codifica imágenes de portaobjetos completos y series de muestras de un mismo paciente a distintos aumentos, en lugar de limitarse a un único portaobjetos «mejor». Sin necesidad de ajustarlo a la tarea, supera a modelos especializados y de mayor tamaño para portaobjetos en varias métricas, con una carga computacional considerablemente menor, y sus descripciones diagnósticas obtuvieron puntuaciones más altas de los patólogos.
11 noviembre 2026