
Breve: de qué se trata todo esto
En agosto de 2026 apareció en arXiv un trabajo con un título casi mundano: «Software Defined Dataflow System for Large-scale AI Acceleration». Detrás de él está la descripción del acelerador Maia 200, y no es otra iteración de «más flops por vatio». La idea principal aquí es arquitectónica: los autores proponen cambiar el enfoque en cómo está diseñado un chip de IA.
El material fue presentado el 25 de agosto de 2026 en la sección cs.AR, el remitente es Torsten Hoefler, y en total la lista de autores incluye a 17 personas (Sherry Xu y otros dieciséis investigadores). El trabajo está clasificado en varias categorías a la vez: arquitecturas de hardware, inteligencia artificial, computación distribuida y paralela, nuevas tecnologías y aprendizaje automático. Es decir, no se presenta como una nota sobre «hardware», sino como una concepción que abarca todo el stack.
Datos en lugar de comandos: la esencia del giro
Un acelerador clásico está construido en torno al flujo de comandos. Hay núcleos, hay un planificador, hay una jerarquía de cachés, y toda esta estructura sirve para ejecutar instrucciones. La memoria en este modelo desempeña el papel de personal de servicio: entrega los datos a tiempo y nosotros nos encargamos del resto.
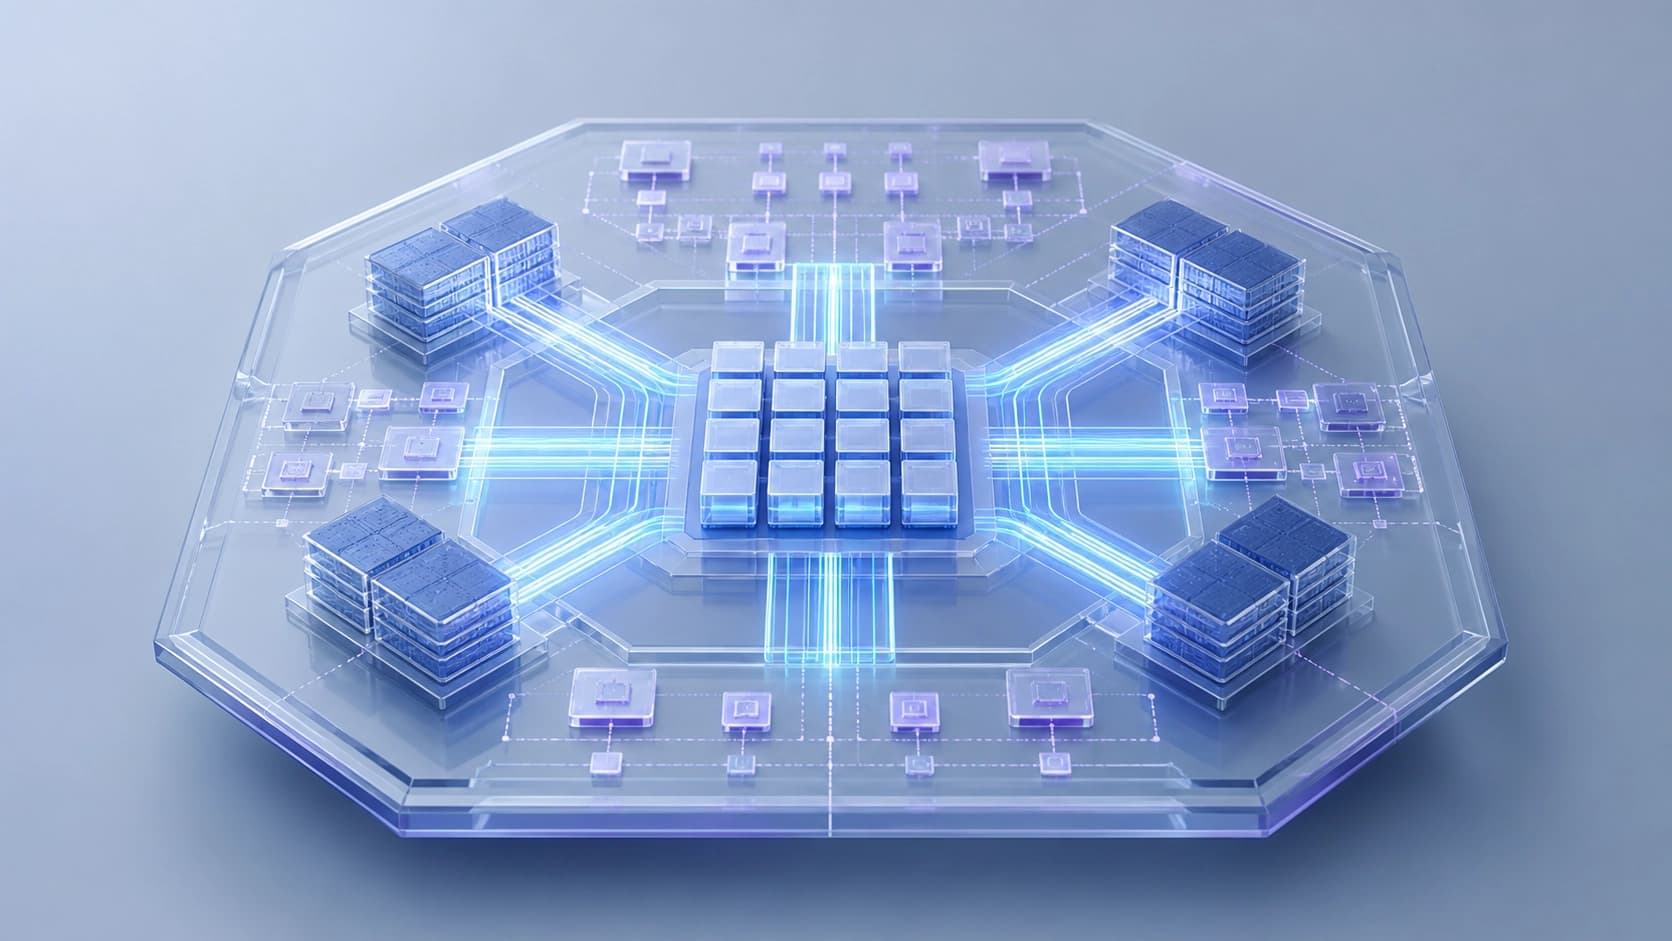
En Maia 200 la lógica se invierte. Los autores clasifican el chip en una nueva clase: Software Defined Locally Accessed Dataflow Architectures, abreviado SDLA. La palabra clave aquí es «software defined»: los motores de dataflow no solo existen en el silicio, se programan explícitamente. El programador describe cómo deben orquestarse exactamente los bloques de memoria especializados y los motores de movimiento de datos. El control se vuelve explícito, y no un efecto secundario del pipeline.
De ahí también el desplazamiento del enfoque: no thread-centric, sino data-movement-centric. La pregunta «cuántas instrucciones por ciclo» cede ante la pregunta «con qué rapidez y sin pérdidas llegan los datos adonde se van a procesar». Para las cargas de trabajo modernas, son planteamientos de problema fundamentalmente distintos.
Cifras
Las características escuetas de la anotación son las siguientes:
- 10 145 Tflop/s en formato FP4;
- 5072 Tflop/s en FP8;
- ancho de banda de memoria HBM — 7 TB/s;
- potencia térmica — 750 W.
Qué significan estas cifras — y qué no significan
La tentación de comparar de inmediato los 10 145 Tflop/s en FP4 con algo conocido es grande, pero no hay con qué comparar de forma correcta: los autores no publican mediciones sobre modelos concretos, y distintos formatos de precisión y distintas metodologías de medición arrojan cifras incomparables. Además, conviene tener presente que una precisión muy baja (FP4) siempre es un compromiso en calidad, y una ventaja en las cifras no equivale a una ventaja en trabajo útil.
Mucho más interesante aquí son los 7 TB/s. Precisamente esta característica rima con la idea principal del artículo: si la arquitectura está construida en torno al movimiento de datos, entonces el ancho de banda de memoria no es un parámetro secundario, sino una estructura portante. Y 750 W es un recordatorio de que se habla de un rack, no de una tarjeta de escritorio.
SDLA y la nueva taxonomía
Para explicar en qué se diferencia un chip así de los habituales, los autores construyen una taxonomía de la gestión de datos. El punto de referencia para ella es la antigua clasificación de Flynn, que dividía las máquinas según el número de flujos de comandos y de datos. Era un lenguaje cómodo para una época en la que el cuello de botella estaba en la ejecución.
Ahora, según los autores, se necesita otro lenguaje: sobre cómo el sistema administra los datos. La clasificación resulta no sobre «cuánto», sino sobre «cómo está organizado». Y en este marco, SDLA ocupa una casilla propia: una arquitectura donde la memoria y el movimiento de datos son ciudadanos de primera clase, y no un telón de fondo.
El sentido práctico de tal taxonomía no está en el amor por los esquemas. Les da a los ingenieros un vocabulario: se puede debatir con fundamento sobre a qué clase pertenece un hardware concreto y qué tareas le convienen, en lugar de medirlo todo con un solo número.
Por qué esto es importante para la inferencia
La inferencia consiste en gran medida en hacer pasar por el chip volúmenes enormes de pesos y activaciones con las mínimas latencias. Cuanto más grande es el modelo, más se topa todo con la memoria y con las conexiones entre bloques, y no con la aritmética. La eficiencia aquí se determina por lo bien que el sistema sabe mover datos.
Los autores afirman que Maia 200 ofrece un ahorro notable en costos y energía, manteniendo un paralelismo masivo precisamente en cargas de inferencia. Si esto se confirma en tareas reales y no solo en pruebas sintéticas, se tratará de otro equilibrio: no «el chip más rápido», sino «el chip que sale más barato alimentar con el mismo volumen de solicitudes». Para los centros de datos, donde las cuentas se llevan en megavatios, este es justamente el argumento que inclina la balanza.
Qué quedó fuera de cámara
La prudencia exige matices. El trabajo es un preprint: arXiv:2608.24664, DOI 10.48550/arXiv.2608.24664, están disponibles el PDF, la versión HTML experimental y las fuentes TeX. La revisión por pares, las mediciones independientes y la reproducción de resultados están por venir. Las promesas sobre ahorro de energía y dinero conviene leerlas como una declaración de los autores, y no como un hecho medido por un tercero.
La segunda cuestión es el costo de la transición. El dataflow programable requiere otra forma de pensar: el desarrollador necesita describir explícitamente las rutas de los datos, y los compiladores y frameworks deben aprender a aprovecharlo. Mientras el ecosistema no se ponga al día, las ventajas del hardware no serán visibles para todos ni de inmediato. Así fue con cualquier cambio de paradigma arquitectónico: primero la concepción, luego las herramientas, después la adopción masiva.
Y aun así, lo principal de esta historia no son los teraflops concretos. Más importante es la propia formulación: el cuello de botella de los cálculos de IA se ha desplazado hacia donde viajan los datos, y no hacia donde se ejecutan los comandos. Si esta idea es correcta, los chips de las próximas generaciones se diseñarán de otra manera y, quizás, precisamente con este trabajo comience la cuenta.


