
Nuevo enfoque LSem2Vec: cómo obtener el vector de código en dos pasos y sin costoso entrenamiento
Los investigadores propusieron una forma sencilla de incrustar código fuente que combina grandes modelos de lenguaje y modelos de embeddings de texto. El método LSem2Vec no requiere ajuste fino para la tarea y, según los resultados de los experimentos, supera a cinco enfoques no supervisados modernos.
¿Qué son los embeddings de código
La representación vectorial del código fuente es necesaria para muchas tareas prácticas: desde la búsqueda de fragmentos similares hasta la agrupación automática de funciones por significado. El programa se convierte en un conjunto de números con el que pueden trabajar los algoritmos de aprendizaje automático. La calidad del vector depende de lo bien que el modelo comprenda la semántica del código, y no solo su sintaxis.
Cuál es la dificultad
Los métodos clásicos suelen requerir un entrenamiento separado para cada tarea o, como mínimo, un ajuste fino con datos del dominio. Esto es costoso y no siempre está justificado. Los enfoques basados en grandes modelos de lenguaje (LLM) parecen más universales, pero tienen su inconveniente: en las respuestas del modelo no es raro encontrar información superflua o errónea, y esa «suciedad» acaba en los vectores.
La idea de LSem2Vec
Los autores del trabajo propusieron un enfoque en dos etapas con un nombre muy descriptivo: LSem2Vec — LLM-extracted code Semantics to Vector embedding. En lugar de intentar entrenar otro modelo pesado, combinan componentes ya existentes: el LLM extrae el significado del código y un modelo de embeddings de frases convierte la descripción en un vector. No se requiere ajuste fino para una tarea concreta.
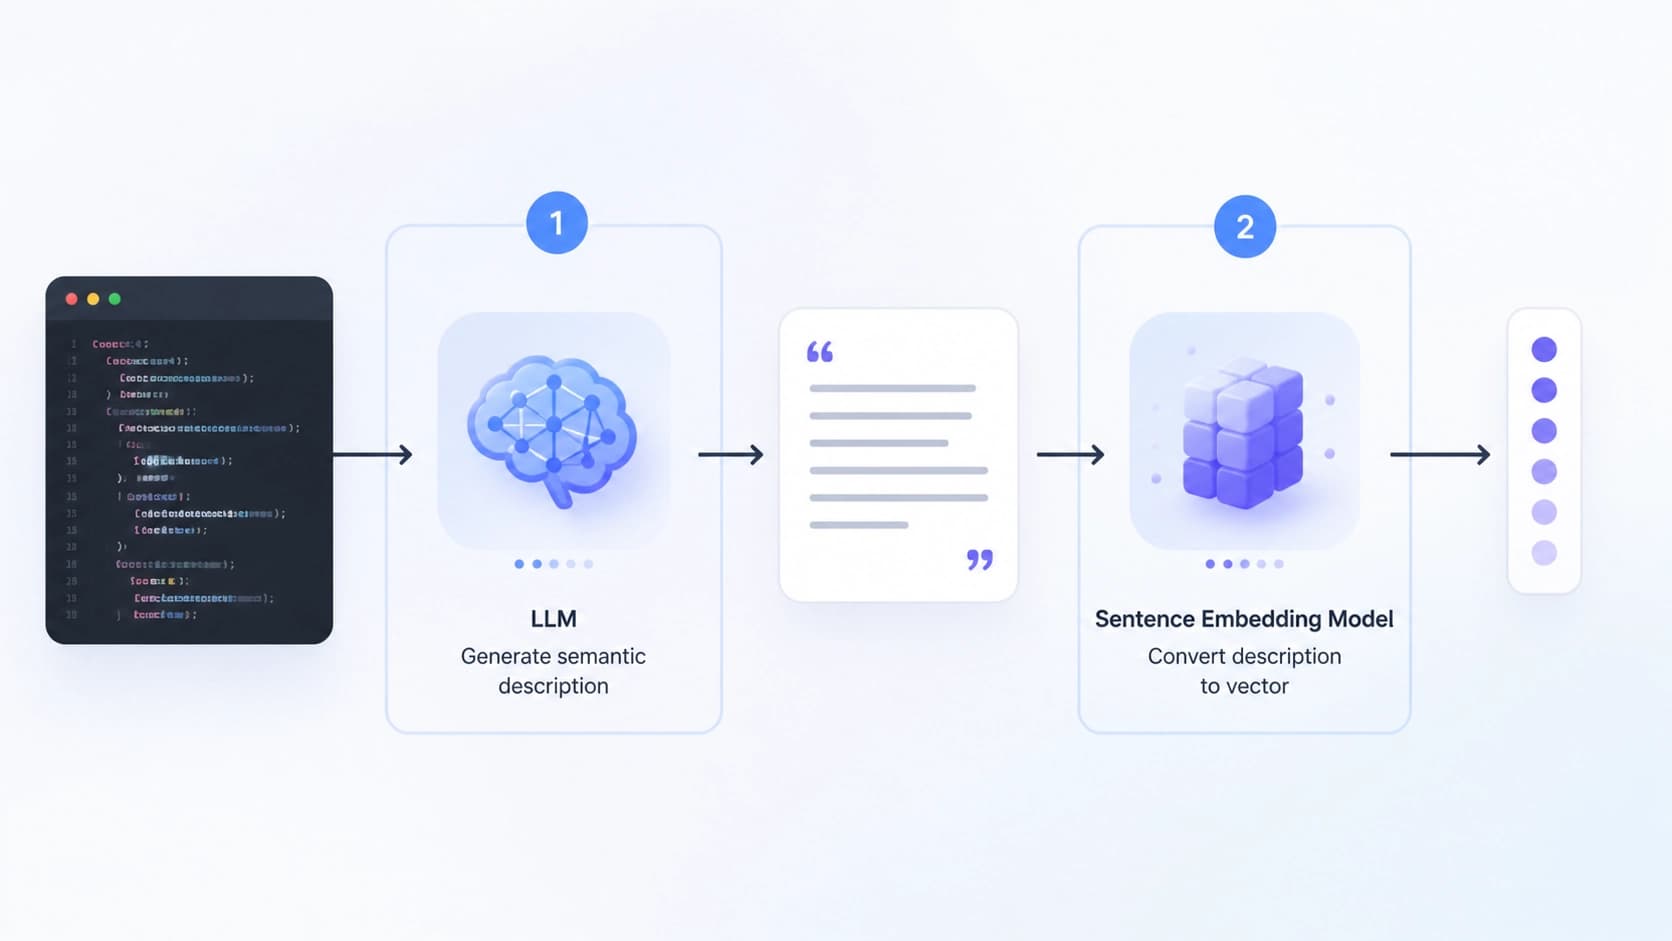
Analicemos el proceso paso a paso. En la primera etapa, el LLM recibe el código y debe formular qué es exactamente lo que hace. No se trata de un resumen mecánico del código fuente, sino de extraer la esencia: el modelo descarta los detalles secundarios para que en la descripción solo entre lo importante para el significado. De paso, este enfoque también elimina posibles «alucinaciones» de los grandes modelos: información errónea que suele aparecer al intentar codificar el código directamente.
La segunda etapa es trivial para los estándares del aprendizaje automático: la descripción obtenida del LLM se introduce en un modelo de embeddings de frases. Ese tipo de modelo ya está entrenado para convertir el lenguaje natural en vectores con sentido, por lo que no es necesario adaptarlo a la sintaxis de los lenguajes de programación.
Por qué funciona
La gran fortaleza de LSem2Vec reside en una clara separación de responsabilidades. Un modelo se encarga de comprender la lógica; el otro, de traducir el texto a un vector. Cada uno resuelve su tarea de la mejor manera posible y, juntos, producen un vector basado en la semántica y no en rasgos formales del código. La ausencia de una fase de entrenamiento hace que el enfoque sea económico y fácil de reproducir.
Cómo se probó y qué se obtuvo
Los experimentos se realizaron con tres conjuntos de datos elaborados en distintos lenguajes de programación. Los autores cambiaron a propósito tanto el LLM como los modelos de embeddings para asegurarse de que el resultado no dependiera del par concreto de herramientas.
En todas las configuraciones, LSem2Vec obtuvo mejores resultados que cinco métodos no supervisados modernos, que normalmente están pensados para condiciones específicas y requieren ajustes.
Estado del trabajo
El artículo se publicó en arXiv en septiembre de 2024; la última versión disponible es la v5, de agosto de 2026. Según los autores, el trabajo ha sido aceptado por la revista Frontiers of Computer Science. Esto significa que el enfoque no solo tiene una página de preprint, sino también una publicación revisada por pares. El original puede encontrarse en el DOI: 10.1007/s11704-026-61288-0.
Conclusión
La principal lección de LSem2Vec es que las tareas complejas no siempre exigen soluciones complejas. Basta con aplicar de forma secuencial un LLM para extraer el significado y un modelo de embeddings de frases para crear el vector. Es rápido, no requiere ajuste fino específico y ofrece resultados competitivos.
Preguntas frecuentes
Material similar
Todos los materiales
Verificación de alucinaciones de LLM mediante una vista SQL de las fuentes, sin reentrenamiento
El estudio evalúa si un LLM puede aprovechar una habilidad simbólica básica —crear una base de datos SQL a partir de documentos fuente— para fundamentar sus respuestas en las fuentes sin supervisión al detectar alucinaciones. En RAGTruth y DiaHalu, este flujo de trabajo neuro-simbólico resulta más preciso que la predicción directa y comparable a los métodos más avanzados, sin requerir un ajuste fino al dominio.
9 noviembre 2026
MathAdv: qué oculta la precisión final de las demostraciones de máquinas
Un conjunto diagnóstico de tareas de 13 áreas de matemáticas de nivel universitario y de posgrado evalúa los sistemas de demostración automática en Lean 4 no solo por el resultado final, sino también por su dominio de la materia, la calidad de sus razonamientos informales y su robustez ante reformulaciones de los enunciados. El análisis por componentes muestra que traducir un problema a un formato formal sigue siendo el principal obstáculo, y que el éxito depende en gran medida del área matemática y de cómo se plantee el problema.
9 noviembre 2026
AffordanceWAM: las affordances como intermediarias entre la predicción de la escena y el control del manipulador
El trabajo describe un modelo generativo que predice simultáneamente futuras observaciones RGB, campos escalares, mapas de calor de affordances y comandos continuos para el robot, utilizando videos de personas para ampliar la diversidad de interacciones sin anotaciones de acciones ni retargeting. En RoboCasa, CALVIN ABC→D y tareas reales, el enfoque ofrece mejoras consistentes frente a las líneas de base que utilizan solo RGB o solo datos robóticos.
9 noviembre 2026