Por qué un sketch global no funciona para las páginas
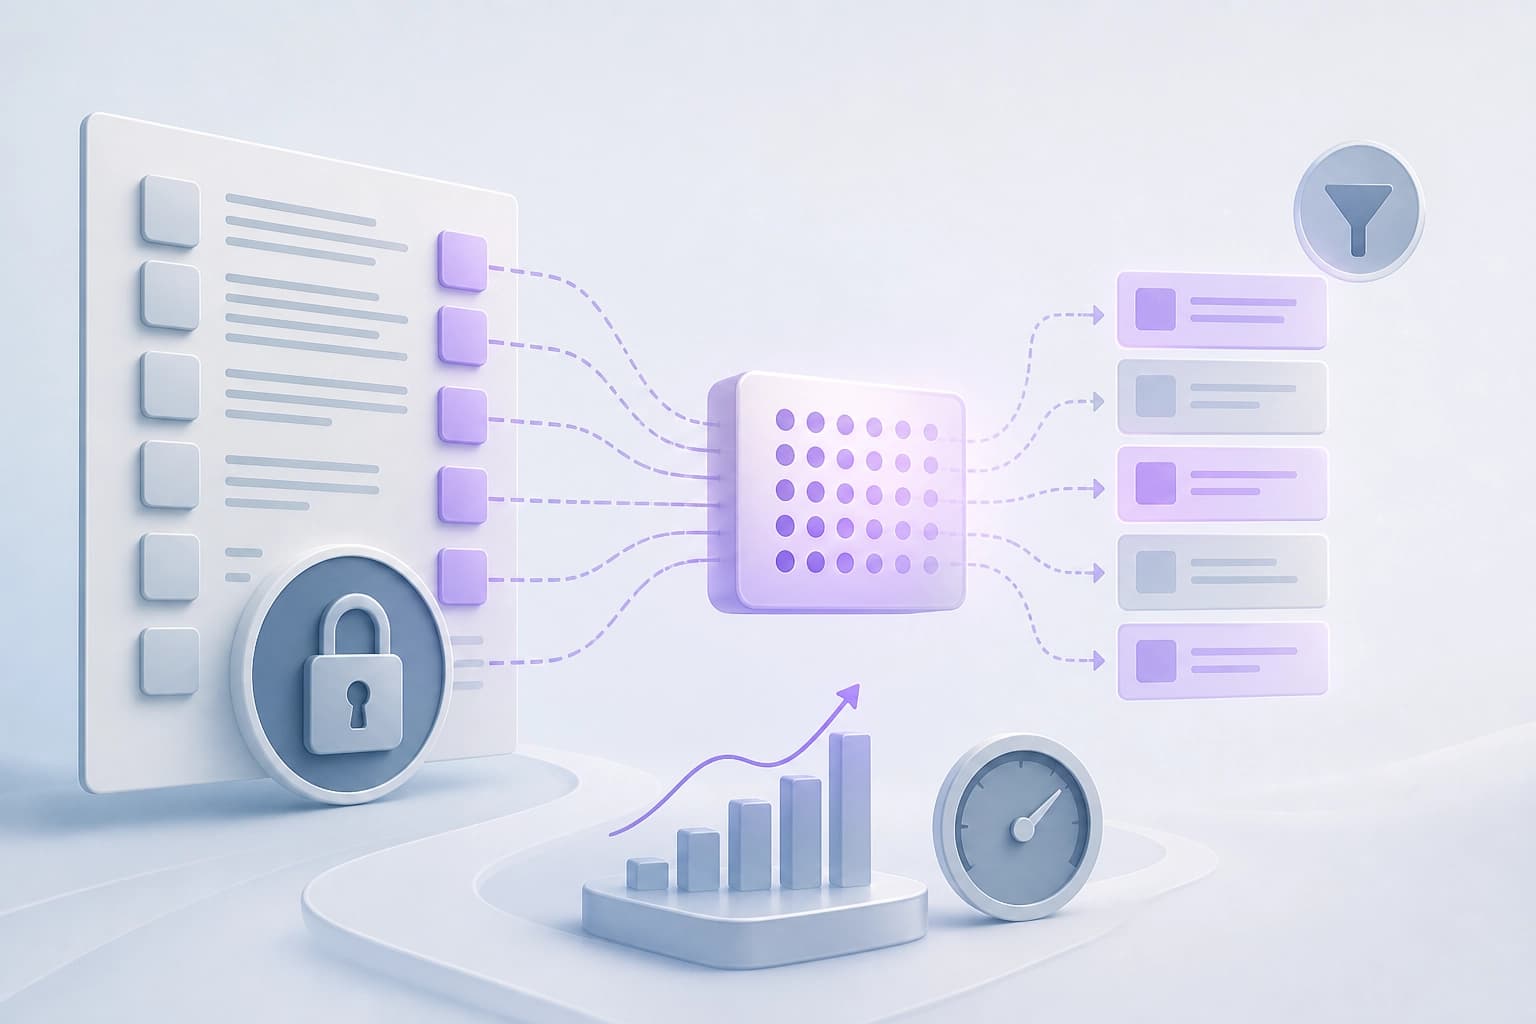
El servicio de grandes modelos de lenguaje en contexto largo choca con la key-value (KV) cache. La caché se lee por completo en cada paso de decodificación. Las attention keys son localmente low-rank, aunque globalmente high-rank. Un sketch low-rank fijo, común para las páginas, es demostrablemente ciego a las direcciones de página.
Con el mismo tamaño de summary, la base propia de la página clasifica las páginas y conserva los portadores mucho mejor. El sketch global no ve esas direcciones. El summary espectral por página resuelve el problema.
Resumen espectral por página
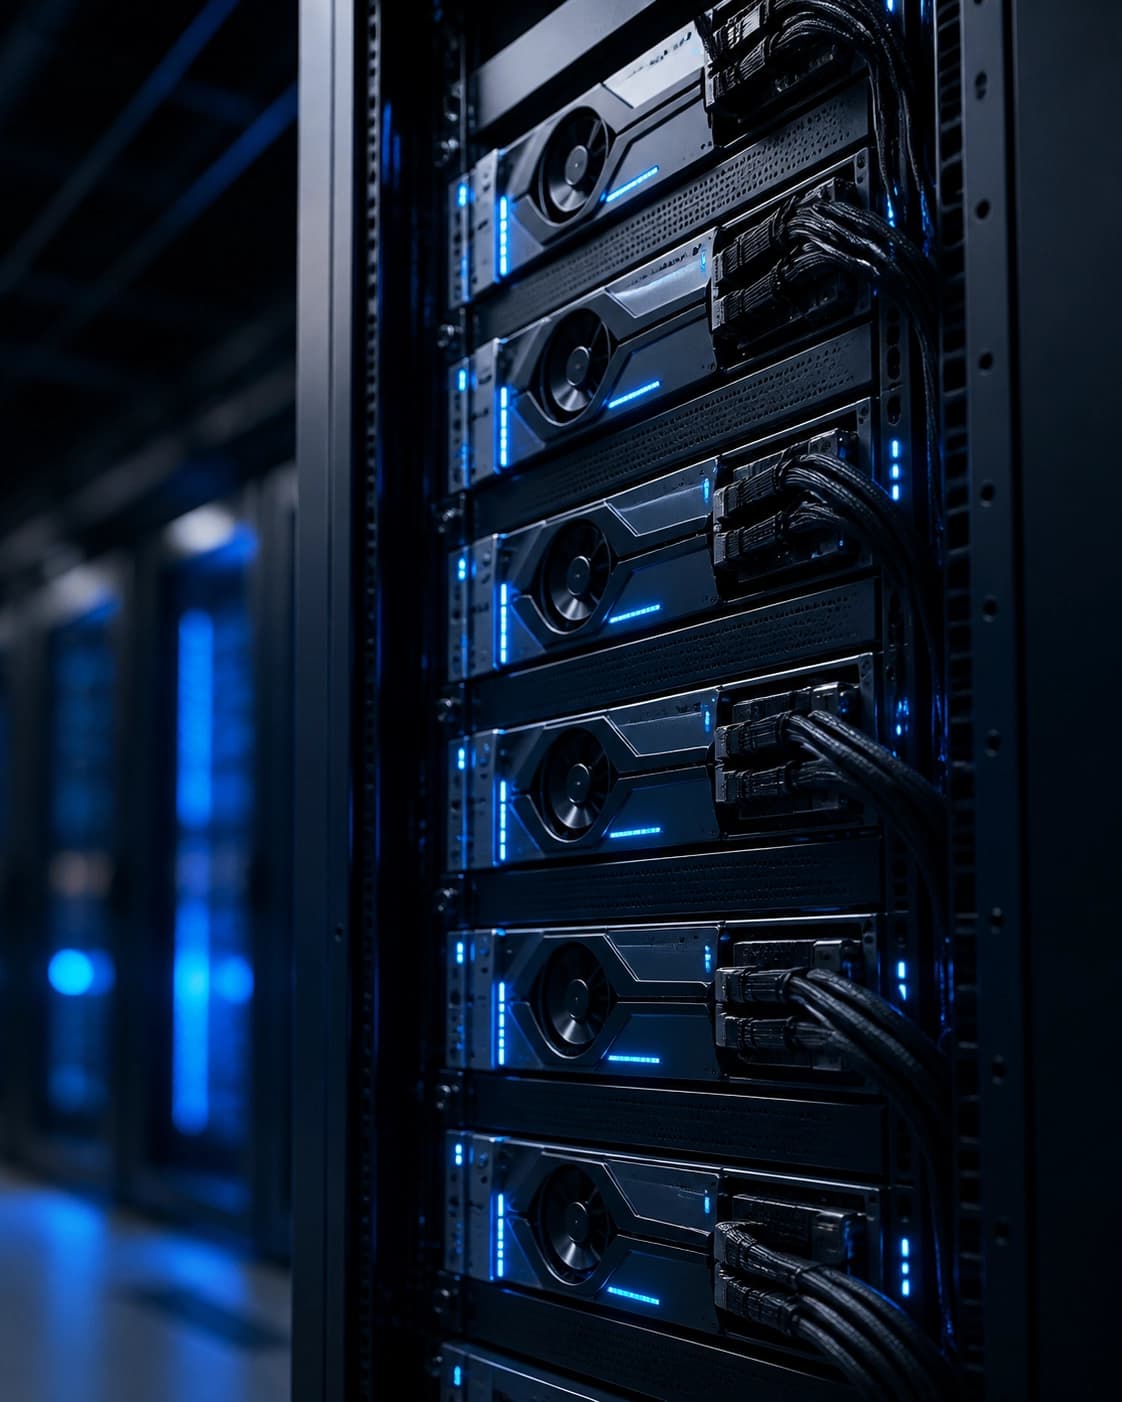
LOCKS da a cada página su propio rank-r spectral summary. El resumen es residente: una décima parte de la caché con r=8 y una vigésima quinta con r=2. El método reconstruye los logits intrapágina. Estima la masa de atención de cada página mediante log-sum-exp. Luego procesa solo las páginas superiores.
Elementos clave:
- Nombre: Page-Local Compact Key Summaries for Efficient Long-Context Decoding.
- Resumen: rank-r spectral summary para cada página.
- Residencia: una décima parte de la caché con r=8, una vigésima quinta con r=2.
- Reconstrucción: logits intrapágina.
- Estimación: masa de atención de la página mediante log-sum-exp.
- Selección: solo las páginas superiores.
Conclusión: el resumen ocupa una fracción de la caché, pero conserva los rasgos de página. La selección de páginas se hace por datos espectrales.
Selección de bloques sin leer claves
La selección en sí no lee las claves ni los valores de los candidatos. La elección se hace solo por el resumen espectral. El resumen se escanea por completo en cada paso. La lectura de KV por paso cae entre 10 y 25 veces en el rango de rangos indicado.
La latencia de decodificación por token se reduce a la mitad. Con 1M de tokens en una sola H200 NVL, la aceleración es de 2.0× con r=8. Es una comparación con la atención densa. La selección no depende de la lectura de las claves de los candidatos.
Calidad en tareas largas
LOCKS mantiene la calidad en varios tipos de tareas. En long-document QA (LongBench-v1; Llama-3.1-8B) el resultado se mantiene dentro de un punto respecto a la caché completa. En retrieval-dense RULER el método sigue al oráculo LSE exacto, que lee cada clave, hasta los presupuestos más pequeños. En long-form reasoning (AIME26, MATH-500; Qwen3-4B) la calidad se mantiene más lejos que nadie en el régimen de presupuestos pequeños. Los selectores y compresores de razonamiento basados en eviction retroceden allí.
Con un presupuesto de 2048 tokens, LOCKS coincide con la calidad agregada de FullKV en un contexto de 100K+ (GLM-4-9B-Chat-1M). Además, el método procesa el 2% de los tokens.
| Condición | Resultado |
|---|---|
| Long-document QA (LongBench-v1; Llama-3.1-8B) | dentro de un punto respecto a la caché completa |
| Retrieval-dense RULER | sigue al oráculo LSE exacto hasta presupuestos pequeños |
| Long-form reasoning (AIME26, MATH-500; Qwen3-4B) | mantiene la calidad más lejos que nadie en presupuestos pequeños |
| Presupuesto de 2048 tokens, contexto de 100K+ (GLM-4-9B-Chat-1M) | coincide con FullKV, procesa el 2% de los tokens |
Conclusión: en las tareas enumeradas, el enfoque mantiene la calidad durante más tiempo que los selectores y los compresores basados en eviction.
Implementación y criterio de elección
El enfoque se distribuye como un plugin drop-in para vLLM sin modificar. La decodificación por lotes funciona en CUDA graphs completos. No se requiere modificar vLLM.
Criterio de elección: contexto largo, presupuesto de tokens limitado, necesidad de reducir la lectura de KV y la latencia de decodificación. Si la tarea requiere seleccionar bloques sin leer las claves de los candidatos, el enfoque es adecuado.