Qué cambia LocalProp
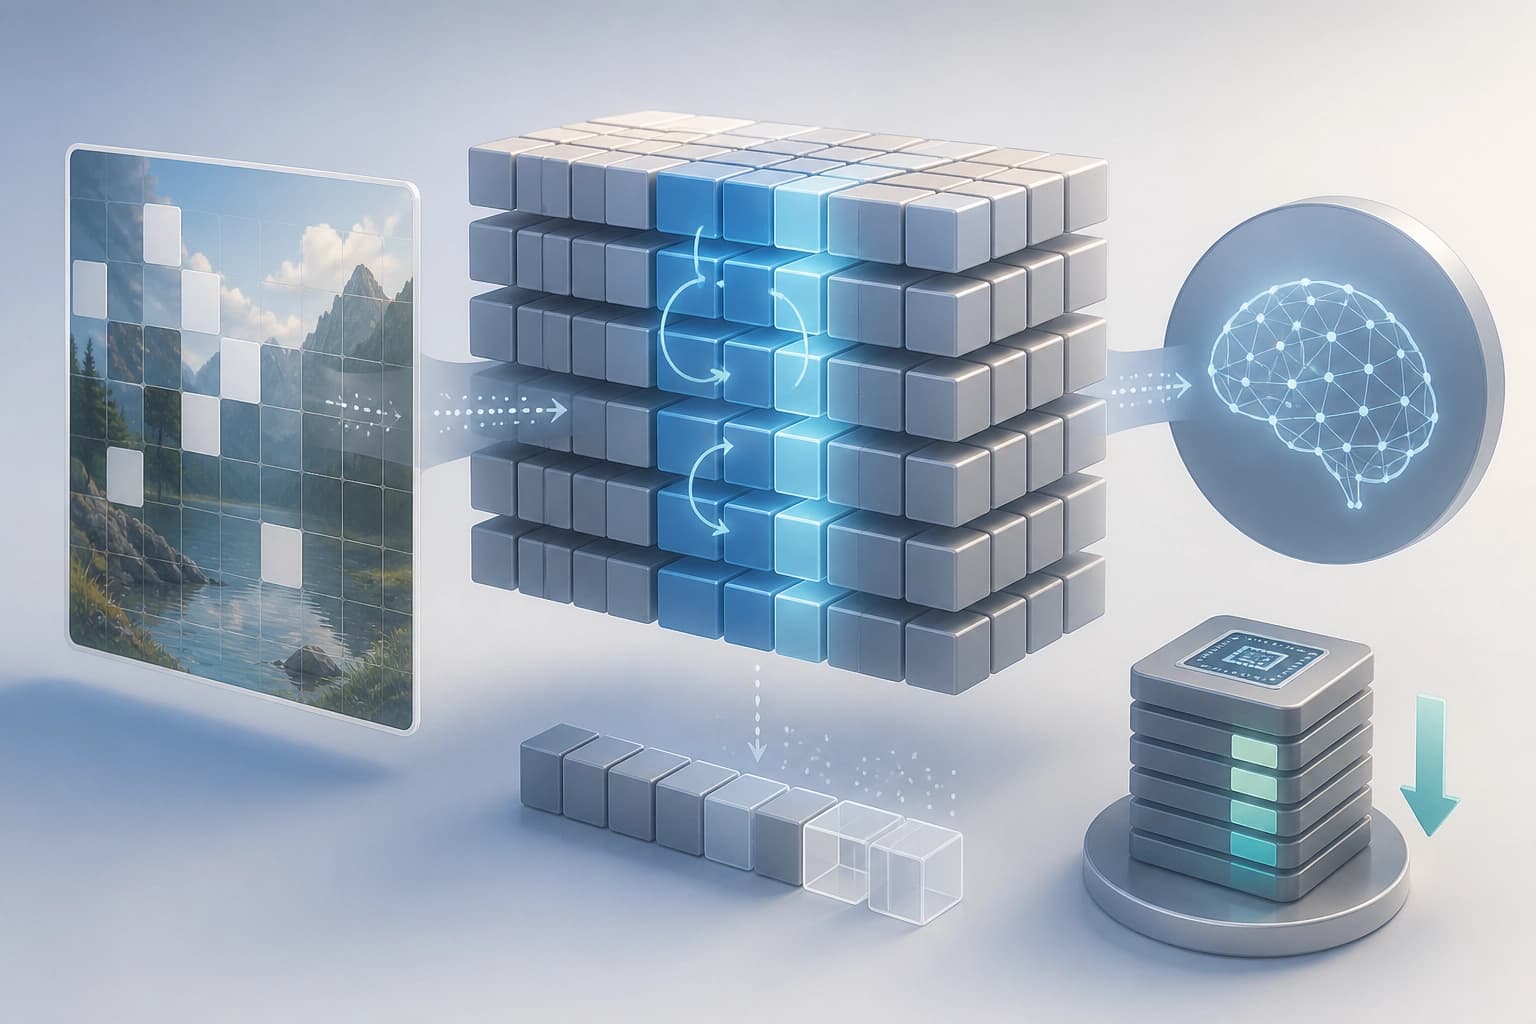
LocalProp es un procedimiento de entrenamiento que actualiza localmente los pesos del modelo. Sus autores lo contraponen a la propagación de gradientes de extremo a extremo a través de todo el modelo. El paso de extremo a extremo no se corresponde con un entrenamiento biológicamente plausible. Además, es ineficiente en cuanto a memoria. El aprendizaje en el cerebro está muy localizado.
| Criterio | Propagación de gradientes de extremo a extremo | LocalProp |
|---|---|---|
| Actualización de pesos | Pasa por todo el modelo | Local |
| Plausibilidad biológica | No se corresponde | Se basa en el aprendizaje localizado en el cerebro |
| Memoria | Ineficiente | Solo se utiliza una parte de la memoria máxima de la GPU |
| Control | No hay un parámetro independiente | Número de bloques optimizados conjuntamente |
Conclusión: LocalProp sustituye el paso de extremo a extremo por actualizaciones locales. Esto reduce la presión sobre la memoria.
Etapas del entrenamiento
LocalProp sigue el esquema «preentrenamiento y luego ajuste fino». Las etapas se suceden en orden.
- Preentrenamiento con I-JEPA.
- Actualización local de los pesos.
- Poda.
- Un breve ajuste fino final.
Conclusión: el esquema combina preentrenamiento, actualizaciones locales, poda y ajuste final.
El papel de la poda
La poda transmite la señal de entrenamiento desde los bloques superiores hasta los inferiores. Esta etapa no se limita a comprimir el modelo. Conecta los bloques superiores e inferiores durante el entrenamiento. Conclusión: en LocalProp, la poda funciona como un canal de transmisión de señales entre bloques.
Compromiso entre precisión y memoria
El número de bloques optimizados conjuntamente determina la longitud de propagación del gradiente. Los autores definen esta longitud como un parámetro práctico. El parámetro controla el compromiso entre la precisión y el uso de memoria.
- Qué cambia: la longitud de propagación del gradiente.
- Qué controla: el equilibrio entre precisión y memoria.
- Cómo se utiliza: mediante el número de bloques optimizados conjuntamente.
Conclusión: ajustar el número de bloques ofrece una palanca para alcanzar el equilibrio.
Resultados y criterio de selección
Los autores realizaron experimentos con varios conjuntos de datos. Entre ellos, grandes benchmarks, incluido ImageNet. LocalProp consigue buenos resultados utilizando solo una parte de la memoria máxima de la GPU. El texto no especifica la proporción concreta. Criterio práctico: LocalProp es adecuado cuando el paso inverso de extremo a extremo se ve limitado por la memoria de la GPU. El número de bloques optimizados conjuntamente permite ajustar el equilibrio.