
Cómo el prompting puntual de LLM encuentra datos médicos ocultos que los sistemas estándar de desidentificación pasan por alto
Un nuevo estudio ha demostrado que los grandes modelos de lenguaje con indicaciones calibradas para una clínica específica cierran las brechas en la protección de la información médica —incluidos los códigos internos y los nombres de edificios—, superando en precisión a los algoritmos existentes y, de paso, detectando errores en el etiquetado de referencia.
¿Por qué los desidentificadores estándar pasan por alto los datos "locales"
Los sistemas automáticos de desidentificación de registros médicos suelen manejar bien los tipos típicos de información protegida: nombres, fechas de nacimiento, números de seguros. Pero en un hospital real aparecen datos que son sensibles solo dentro de esa organización. Son nombres abreviados de clínicas, nombres de edificios, códigos internos de departamentos. Para una persona, estas cadenas indican claramente el lugar de tratamiento, pero un algoritmo universal no puede conocer todas las denominaciones locales.
Las soluciones tradicionales se basan en diccionarios o en modelos entrenados con categorías fijas. Ambas pasan por alto lo que no está en sus referencias. Los investigadores llaman a esto PHI "institucionalmente localizada", y es aquí donde surgen riesgos graves de fuga.
Cómo logra la LLM cerrar la brecha
Para comprobar si los grandes modelos de lenguaje con aprendizaje en contexto (in-context learning) pueden resolver este problema, los autores del experimento tomaron 100 notas anotadas de oncología pediátrica —más de cinco mil fragmentos de PHI en total— y compararon ocho LLM con dos sistemas especializados (Stanford TiDE y OpenMed PII) y dos líneas base basadas en patrones.
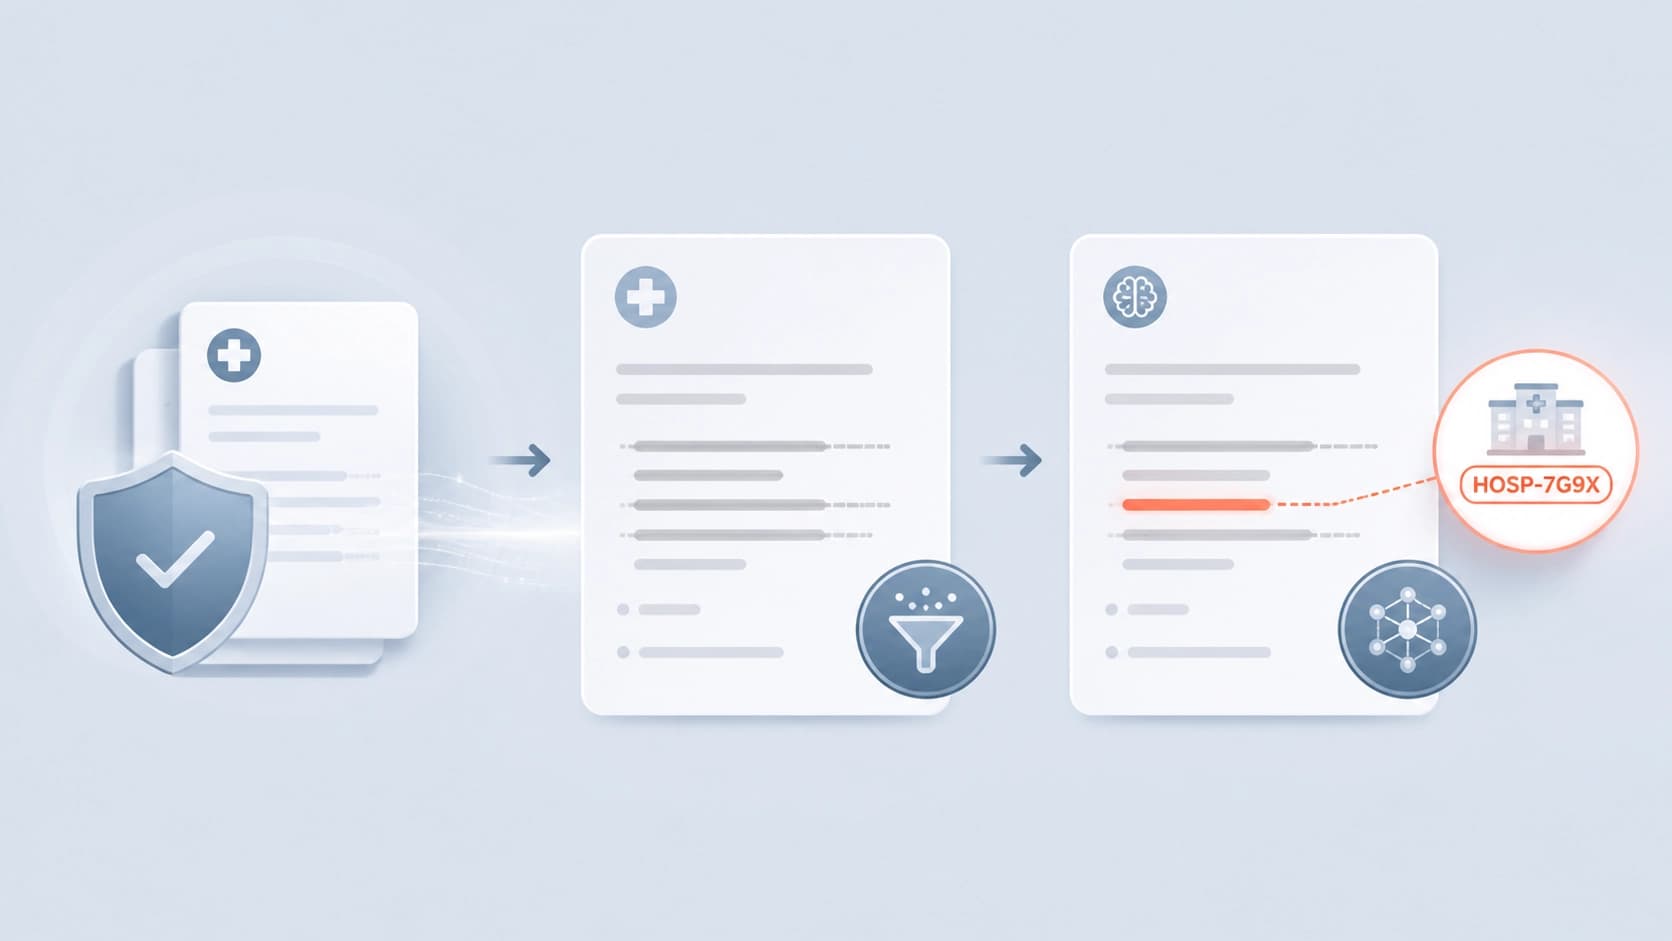
El resultado favoreció a las LLM: el mejor modelo alcanzó un F1 = 0,918 ± 0,001, mientras que el mejor sistema especializado, TiDE, solo obtuvo 0,779. La ventaja fue especialmente notable en las categorías contextualmente dependientes —precisamente esas denominaciones locales que suelen escapar al alcance de los algoritmos.
Tres niveles de prompts: de HIPAA al ajuste fino
El truco clave no es solo la consulta, sino un ajuste dirigido del prompt a la institución concreta. En el experimento se usaron tres variantes:
- Prompt básico — instrucción general según el estándar HIPAA.
- Prompt con categorías locales — se añade una lista de tipos institucionales de PHI que el estándar no contempla.
- Prompt con protección contra el sobredimensionamiento — indicación adicional de no recortar contenido clínico innecesario.
Enumerar las categorías omitidas recuperó el 79% de los 61 fragmentos antes no encontrados (48 piezas). Y la instrucción contra el sobredimensionamiento restauró la precisión, que se veía afectada por el "exceso de cautela" del modelo.
Los agentes y los conjuntos no aportaron ventaja
Podría pensarse que ejecutar varios modelos o un esquema multiagente daría un resultado aún mejor. Los autores probaron 14 configuraciones de este tipo y las compararon con el mejor prompt individual. Resultó que ninguna arquitectura de agentes superó a un simple prompting calibrado de una sola pasada. En los agentes, el F1 se mantuvo en el rango de 0,906–0,907 —es decir, prácticamente al mismo nivel, pero sin ganancia adicional.
La LLM como auditora de la anotación
Un valor adicional del enfoque con LLM es que ayuda a verificar la calidad del propio conjunto de referencia. Los modelos señalaron 414 lugares donde la anotación original probablemente estaba incompleta. Tras la revisión manual, se confirmaron 227 tramos de PHI omitidos. Cuando se corrigió la anotación y se reinició el prompting, la exhaustividad aumentó a 0,981 con un F1 = 0,907 ± 0,002. Esto significa que la LLM puede actuar no solo como herramienta de desidentificación, sino también como auditora para crear conjuntos de entrenamiento más precisos.
Conclusiones
Un prompt bien ajustado permite a la LLM cerrar la brecha institucional de PHI y encontrar un equilibrio óptimo entre precisión y exhaustividad en una sola llamada al modelo. Este enfoque es más costoso que los métodos tradicionales basados en diccionarios, pero esos costos se compensan parcialmente con la posibilidad de verificar y mejorar el propio estándar de referencia.
Los autores consideran que las LLM son una alternativa legítima y adaptable a los desidentificadores especializados. La principal estrategia de implementación es el desarrollo de prompts específicos para cada institución, que tengan en cuenta las realidades locales de cada clínica.
Preguntas frecuentes
Material similar
Todos los materiales
La transición al simplex de probabilidad reduce la brecha modal en los modelos multimodales contrastivos
El trabajo arXiv:2610.32890 propone sustituir los embeddings esféricos por un simplex probabilístico, añadiendo adaptadores softmax ligeros y una similitud de variación total. En cinco benchmarks de búsqueda, la distancia ℓ2 entre centroides de distintas modalidades se reduce un 97–99 %, manteniendo o mejorando la calidad de búsqueda.
3 noviembre 2026
Cómo ActionRAG reevalúa las evidencias durante la difusión por el grafo de memoria de los agentes LLM
Se propone una arquitectura de memoria basada en grafos que armoniza cuidadosamente las entidades durante la indexación y vuelve a evaluar las relaciones al realizar una consulta, basándose en la estructura local. En MemoryAgentBench, el método alcanzó una precisión media de 55,1 y superó en 5,4 puntos porcentuales a la referencia de recuperación más sólida, con un coste de síntesis reducido por consulta.
3 noviembre 2026
Quince empresas respaldaron MDK Tether para automatizar la minería.
Los fabricantes de equipos, los pools y los operadores han asumido el desarrollo de integraciones con el conjunto abierto de Tether para unificar la supervisión y la gestión de los equipos; el agente de IA QVAC ya funciona sobre esta base. Aún no se han publicado confirmaciones independientes de una reducción de los costes de electricidad ni de un aumento de la eficiencia.
2 noviembre 2026